فهرست مقاله
برای ساخت مدل پیشبینی دمای یک سامانهٔ مهندسی، فقط انتخاب الگوریتم مهم نیست؛ باید مشخص باشد در لحظهٔ پیشبینی چه اطلاعاتی در دسترس است. اگر نمونههای آینده وارد آموزش شوند، یک امتیاز خوب ممکن است تصویر درستی از کارکرد آینده ندهد. در این آموزش، مسئلهای کوچک با دادهٔ مصنوعی میسازیم، مرز زمانی را با کد کنترل میکنیم و مدل خطی را با دو خط مبنا میسنجیم. هدف، ساخت روش ارزیابی قابل بازبینی است و نتیجه به هیچ محصول یا تجهیز واقعی نسبت داده نمیشود.
۱. مسئله را با زمان دسترسی داده تعریف کنید
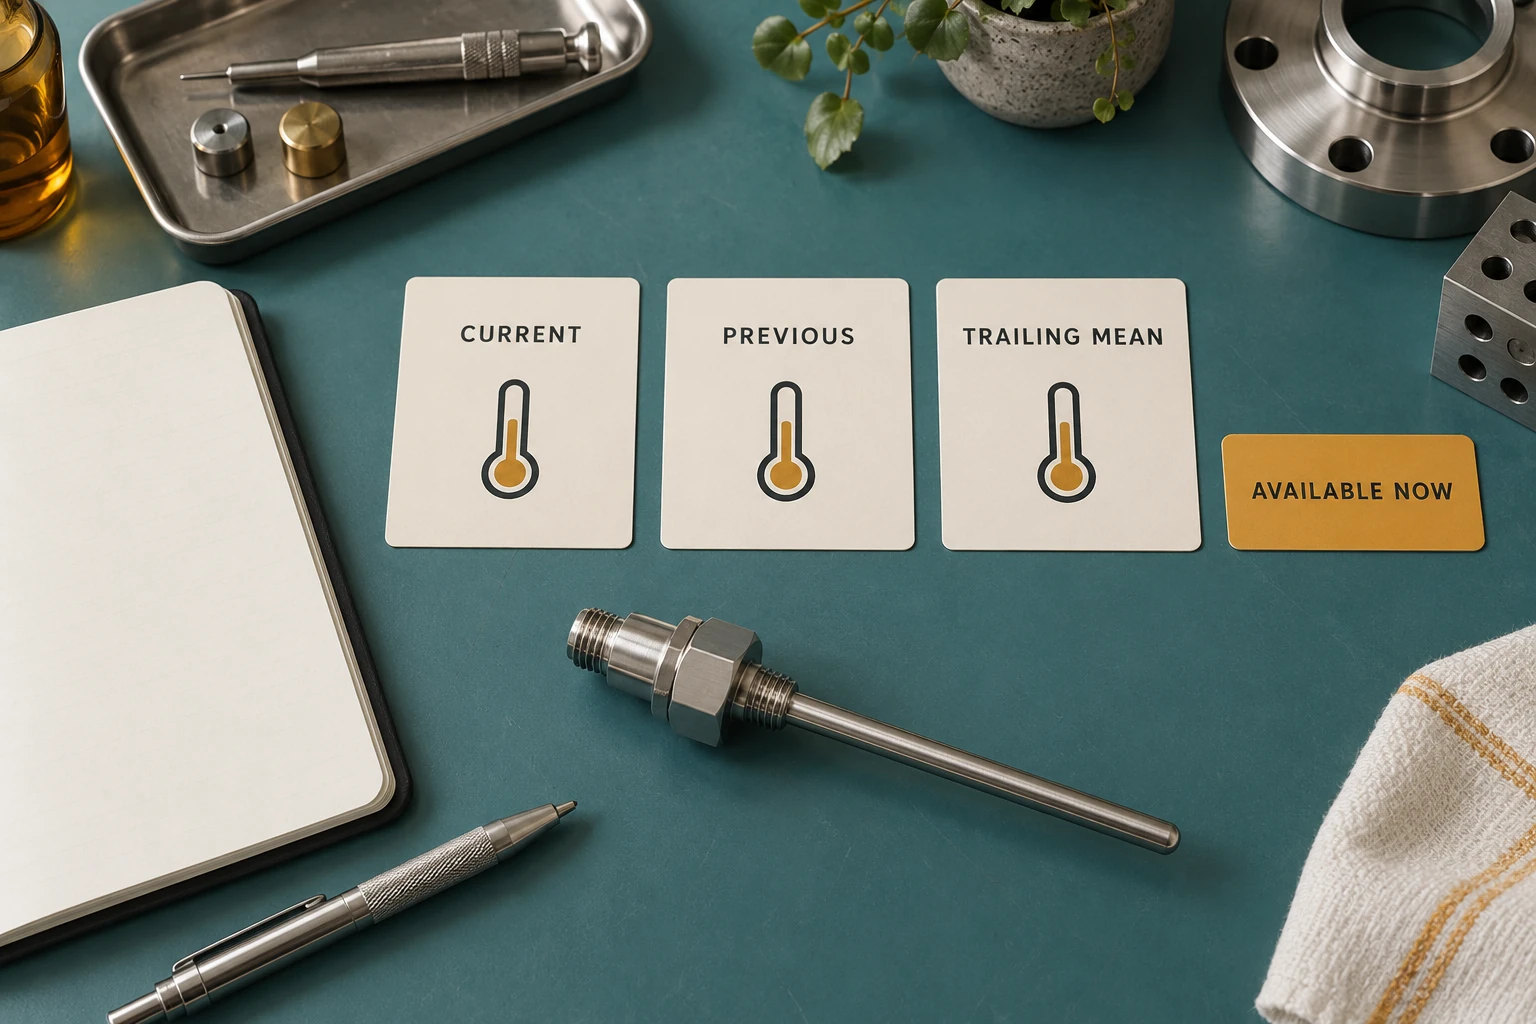
فرض میکنیم هر دقیقه یک مشاهدهٔ دما با واحد درجهٔ سلسیوس دریافت میشود. در دقیقهٔ t، مشاهدهٔ همان دقیقه رسیده است و میخواهیم دمای دقیقهٔ بعد را پیشبینی کنیم. کد ۷۲۰ مشاهدهٔ مصنوعی شامل نوسان، روند، یک تغییر سطح و نویز تولید میکند. این فرمول مدل انتقال حرارت موتور نیست؛ داده برای آزمودن قرارداد نرمافزاری ساخته شده و از دستگاه، مشتری یا خط تولید برداشت نشده است.
برای هر ردیف سه ویژگی داریم: دمای فعلی، دمای دقیقهٔ قبل و میانگین شش مشاهدهٔ اخیر که به مشاهدهٔ فعلی ختم میشوند. هدف، دمای دقیقهٔ بعد است. پنج مشاهدهٔ آغازین تاریخچهٔ کافی ندارند و آخرین مشاهده نیز هدف بعدی ندارد؛ بنابراین ۷۱۴ ردیف آموزشی ساخته میشود. این شمارش ساده ارزش بررسی دارد، چون جابهجایی یک اندیس میتواند یک ویژگی مجاز را به خواندن ناخواستهٔ آینده تبدیل کند.
مرز دسترسی از شکل آرایه مهمتر است. اگر حسگر با دو دقیقه تأخیر گزارش بدهد، دمای فعلی دیگر در لحظهٔ تصمیم در دسترس نیست و این مثال باید بازطراحی شود. همچنین میانگین متحرک نباید حول زمان جاری و شامل نمونههای بعدی باشد. برای همین کد، اندیس همهٔ اعضای تاریخچه را ثبت و کنترل میکند؛ هیچ اندیسی نباید از زمان مبدأ پیشبینی جلوتر باشد.
۲. آموزش را پیش از آزمون نگه دارید
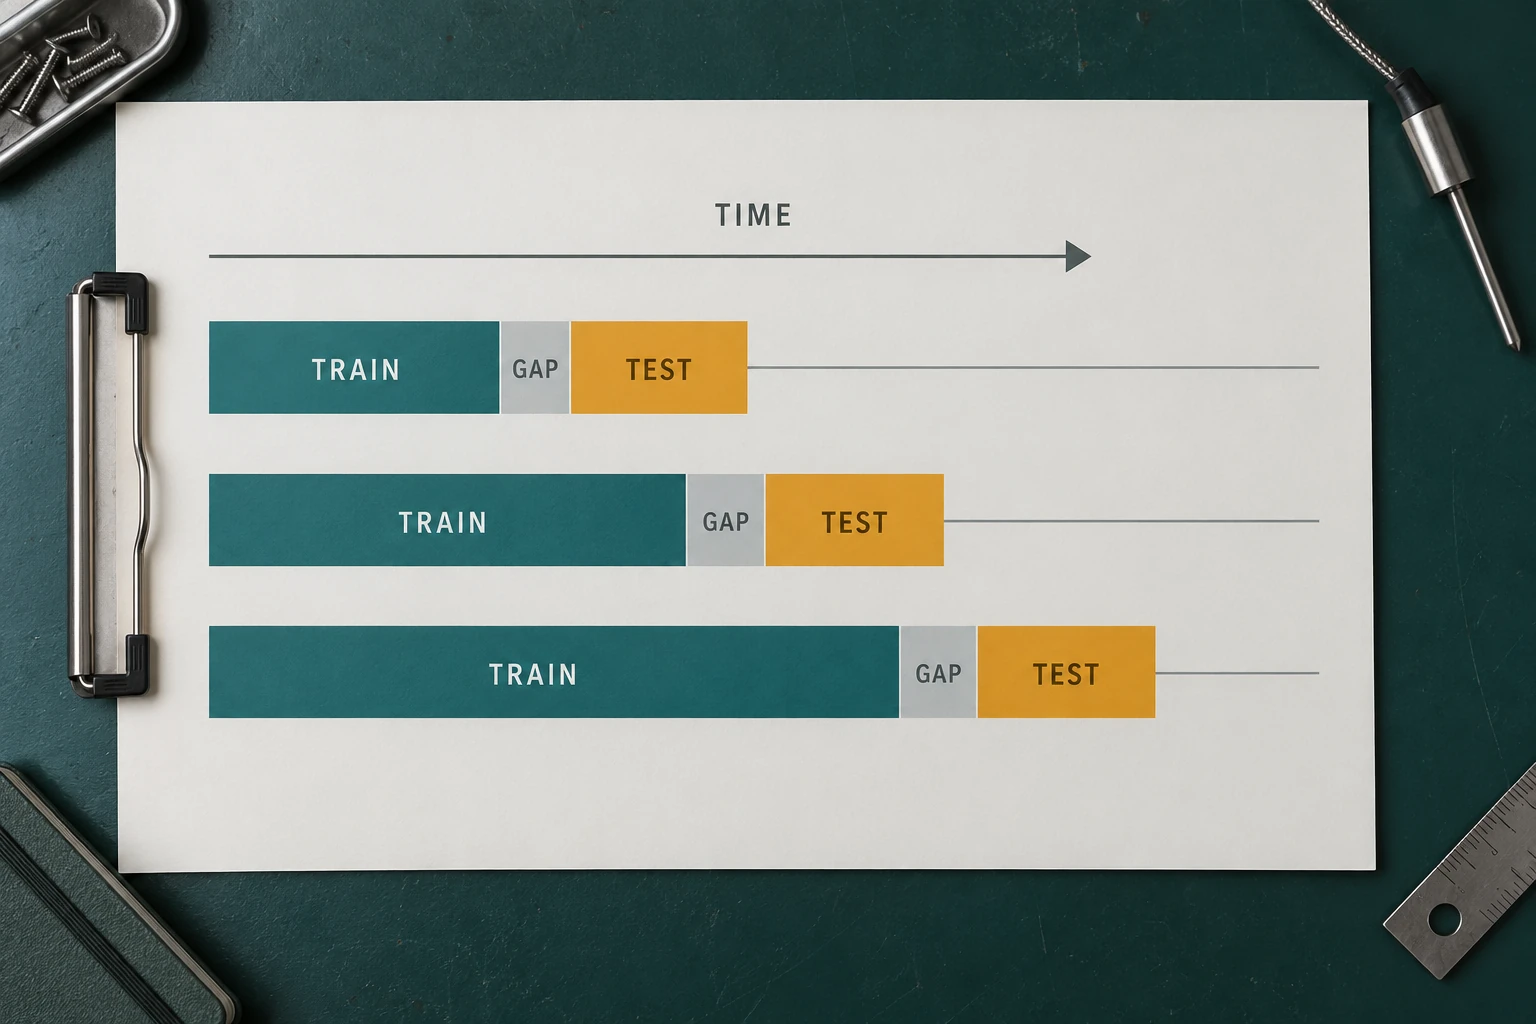
از TimeSeriesSplit با سه تقسیم و ۱۲۰ ردیف آزمون در هر تقسیم استفاده میکنیم. آموزش به مرور بزرگتر میشود و آزمون در زمان بعدی قرار میگیرد. این انتخاب برای مشاهدات منظم دقیقهای ما مناسب است؛ برای دادهٔ نامنظم، باید مدت واقعی هر بازه و زمان رسیدن داده را جدا بررسی کرد. اندازهٔ یکسان آرایهها به تنهایی مدت یکسان را تضمین نمیکند.
سیاست محافظهکارانهٔ این مثال میگوید آخرین زمان برچسب آموزشی باید اکیداً پیش از اولین مبدأ آزمون باشد. فاصلهٔ یکردیفی، یا gap=1، این شرط را برای افق یک دقیقه برقرار میکند. برای نمونه، در تقسیم اول آخرین برچسب آموزش مربوط به دقیقهٔ ۳۵۸ و اولین مبدأ آزمون دقیقهٔ ۳۵۹ است. فاصله را از طول پنجره کورکورانه انتخاب نمیکنیم؛ افق برچسب، تأخیر دسترسی و کاربرد واقعی تعیینکنندهاند.
همپوشانی بخشی از تاریخچهٔ گذشته در ویژگیهای آموزش و آزمون، به خودی خود خواندن آینده نیست. خطر زمانی ایجاد میشود که از اطلاعاتی استفاده کنیم که در لحظهٔ تصمیم هنوز موجود نبودهاند. مثال رسمی ویژگیهای تأخیری scikit-learn نیز نشان میدهد تقسیم درهمریخته میتواند ارزیابی پیشبینی را خوشبینانه کند. این هشدار به معنی تضمین بهتر یا بدتر بودن یک عدد در همهٔ دادهها نیست؛ قرارداد زمانی باید با وظیفه سازگار باشد.
۳. کد کامل مدل و دو خط مبنا
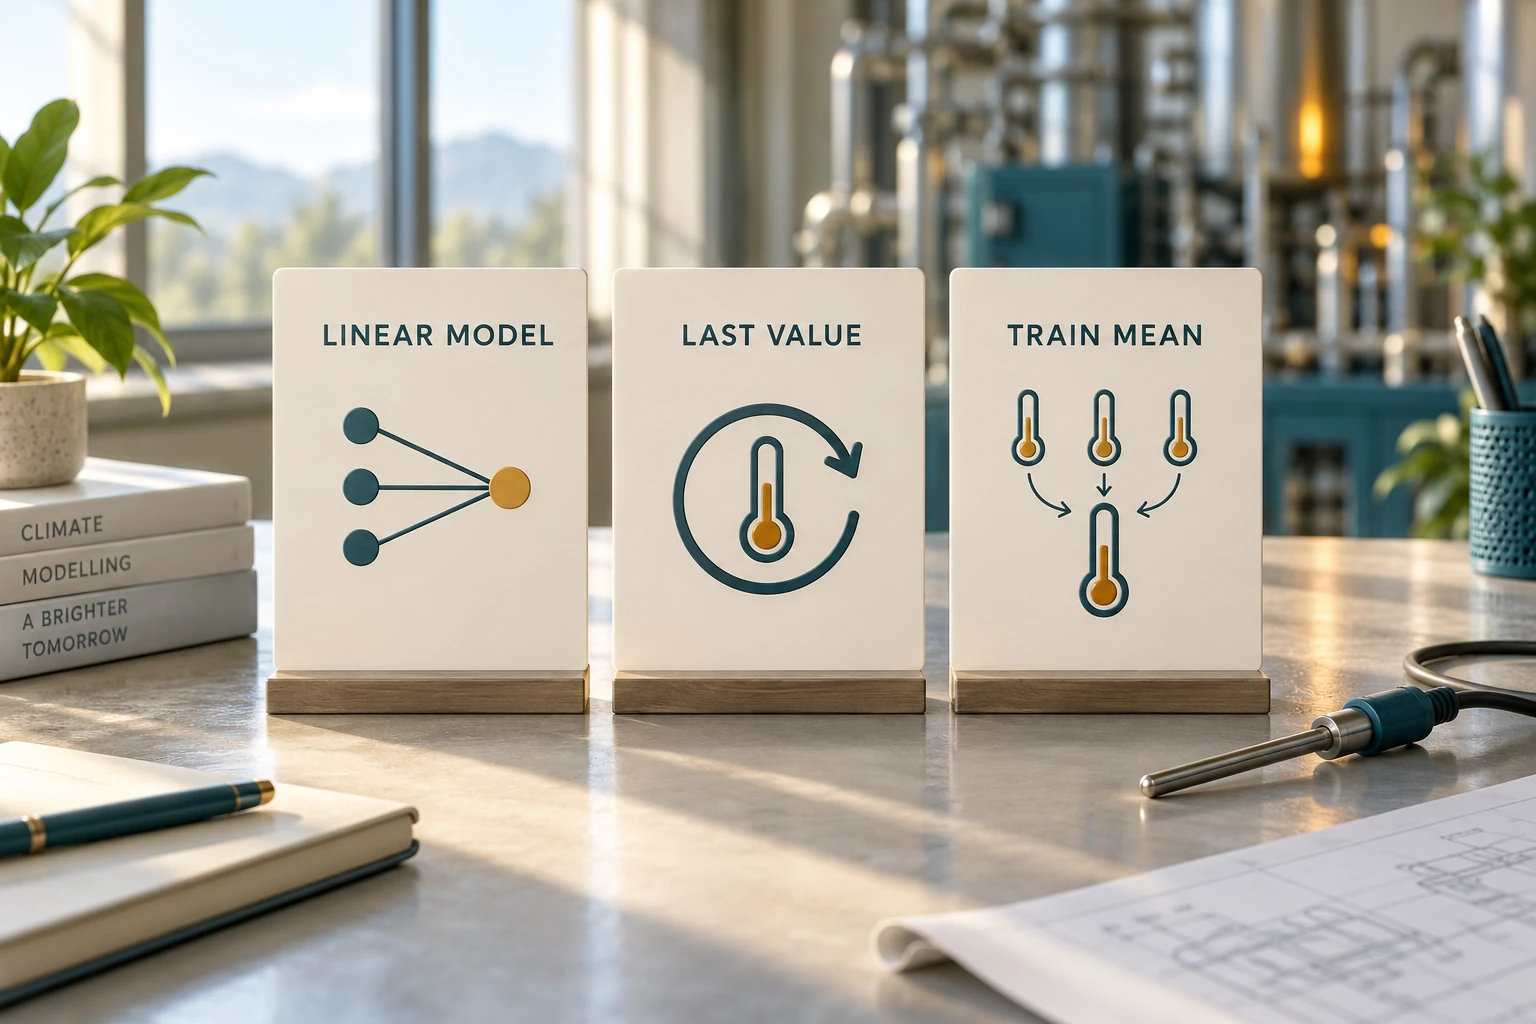
مدل اصلی، رگرسیون خطی کمترین مربعات است. خط مبنای اول، دمای فعلی را به عنوان پیشبینی دقیقهٔ بعد تکرار میکند؛ این روش برای سیگنال آرام یک رقیب مهم است. خط مبنای دوم با DummyRegressor فقط میانگین هدفهای آموزش را پیشبینی میکند. هر دو مدل قابل برازش، داخل هر تقسیم از نو و فقط با ردیفهای آموزش برازش میشوند.
در طول هر بازهٔ آزمون، ضرایب مدل ثابت میمانند، اما با رسیدن هر مشاهدهٔ جدید، ویژگیهای همان دقیقه ساخته میشوند. پس این آزمایش، ۱۲۰ پیشبینی یک دقیقه جلوتر است؛ پیشبینی یکجای ۱۲۰ دقیقهٔ آینده نیست. کد علاوه بر ترتیب زمان، جدایی ردیفهای آزمون بین تقسیمها، متناهی بودن خروجی و استفادهٔ خط مبنا از میانگین آموزش را کنترل میکند. یک ورودی عمدی با آموزش در آینده نیز باید توسط کنترل مرز رد شود.
"""Authored synthetic temperatures; rolling one-step forecasts, not device tests."""
import hashlib
import json
import platform
import numpy as np
import sklearn
from sklearn.dummy import DummyRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error
from sklearn.model_selection import TimeSeriesSplit

rng = np.random.Generator(np.random.PCG64(20261015))
minute = np.arange(720)
temperature = (45.0 + 6.0*np.sin(2*np.pi*minute/180.0)
               + 0.02*minute + 4.0*(minute >= 480)
               + rng.normal(0.0, 0.3, len(minute)))
# At origin t, temperature[t] has already arrived. Predict temperature[t+1].
origins = np.arange(5, len(temperature)-1)
history_indices = origins[:, None] - np.arange(6)[None, :]
X = np.column_stack((temperature[origins], temperature[origins-1],
                     temperature[history_indices].mean(axis=1)))
y = temperature[origins+1]
label_times = origins+1


def assert_temporal_boundary(train, test):
    if len(train) == 0 or len(test) == 0:
        raise ValueError("Empty train or test partition")
    if label_times[train].max() >= origins[test].min():
        raise ValueError("Training label reaches the test forecast origin")
    if np.intersect1d(train, test).size:
        raise ValueError("Train and test rows overlap")


checks = {}
assert np.all(np.diff(minute) == 1)
checks["regular_one_minute_observations"] = True
assert history_indices.min() >= 0
assert np.all(history_indices <= origins[:, None])
checks["features_use_only_available_history"] = True
cv = TimeSeriesSplit(n_splits=3, test_size=120, gap=1)
folds = []
all_test = []
for fold, (train, test) in enumerate(cv.split(X), start=1):
    assert_temporal_boundary(train, test)
    all_test.extend(test.tolist())
    model = LinearRegression().fit(X[train], y[train])
    mean_model = DummyRegressor(strategy="mean").fit(X[train], y[train])
    predictions = {"linear": model.predict(X[test]),
                   "persistence": X[test, 0],
                   "train_mean": mean_model.predict(X[test])}
    assert all(np.all(np.isfinite(p)) for p in predictions.values())
    np.testing.assert_allclose(predictions["train_mean"], y[train].mean(),
                               rtol=0.0, atol=1e-12)
    maes = {name: float(mean_absolute_error(y[test], pred))
            for name, pred in predictions.items()}
    manual = float(np.mean(np.abs(y[test]-predictions["linear"])))
    assert np.isclose(maes["linear"], manual)
    folds.append({"fold": fold, "train_rows": len(train),
                  "test_rows": len(test),
                  "last_train_label_minute": int(label_times[train].max()),
                  "first_test_origin_minute": int(origins[test].min()),
                  "last_test_origin_minute": int(origins[test].max()),
                  "mae_degC": maes})
checks["training_labels_precede_test_origins"] = True
checks["all_predictions_finite"] = True
checks["mean_baseline_uses_training_targets_only"] = True
checks["mae_matches_manual_calculation"] = True
assert len(set(all_test)) == len(all_test) == 360
checks["test_rows_disjoint_across_folds"] = True
try:
    assert_temporal_boundary(np.array([0, 500]), np.array([400, 401]))
except ValueError:
    checks["deliberate_future_training_detected"] = True
else:
    raise AssertionError("Boundary guard did not detect future training data")

report = {
    "versions": {"python": platform.python_version(), "numpy": np.__version__,
                 "scikit_learn": sklearn.__version__},
    "data": {"source": "authored synthetic temperatures; no measured motor data",
             "seed": 20261015, "observations": len(temperature),
             "unit": "degree Celsius", "sample_period_s": 60,
             "sha256_float64_little_endian": hashlib.sha256(
                 temperature.astype("<f8").tobytes()).hexdigest()},
    "task": {"horizon_s": 60, "history_samples": 6,
             "supervised_rows": len(y), "folds": 3, "test_size": 120,
             "gap_rows": 1, "refit_per_fold": True,
             "new_observation_available_at_each_test_origin": True,
             "not_a_120_step_recursive_forecast": True},
    "folds": folds,
    "mean_fold_mae_degC": {name: float(np.mean(
        [fold["mae_degC"][name] for fold in folds]))
        for name in ("linear", "persistence", "train_mean")},
    "limits": "No fault labels, anomaly detector, safety threshold or field validation; no untouched final holdout used for model selection.",
    "checks": checks,
}
print(json.dumps(report, ensure_ascii=False, indent=2))
۴. خروجی واقعی اجرا و پاسخ تمرینها
مثال با Python 3.14.5، NumPy 2.5.4 و scikit-learn 1.9.1 اجرا شد و هشت بررسی گذشت. معیار، میانگین خطای مطلق یا MAE با واحد درجهٔ سلسیوس است. میانگین خطای سه تقسیم برای مدل خطی حدود ۰٫۳۳۲، برای تکرار مشاهدهٔ فعلی ۰٫۳۵۰ و برای میانگین آموزش ۸٫۰۴۲ درجه ثبت شد. بهبود مدل خطی نسبت به روش تکرار، محدود است؛ مقایسه فقط با خط مبنای ضعیفِ میانگین، این تفاوت را پنهان میکرد.
خطای مدل خطی در سه تقسیم به ترتیب حدود ۰٫۳۱۱، ۰٫۳۳۷ و ۰٫۳۴۷ درجه بود. این اعداد عملکرد روی همین دنبالهٔ مصنوعی و افق تعریفشدهاند و فاصلهٔ اطمینان یا حد خطای آینده نیستند. تقسیمها از تاریخچهٔ آموزشی مشترک استفاده میکنند؛ مستقل فرض کردن امتیازها درست نیست. چون تعداد آزمونها در هر تقسیم برابر است، میانگین سادهٔ خطاهای تقسیمها با میانگین خطای همهٔ ردیفهای آزمون یکسان است.
{
  "versions": {
    "python": "3.14.5",
    "numpy": "2.5.4",
    "scikit_learn": "1.9.1"
  },
  "data": {
    "source": "authored synthetic temperatures; no measured motor data",
    "seed": 20261015,
    "observations": 720,
    "unit": "degree Celsius",
    "sample_period_s": 60,
    "sha256_float64_little_endian": "a9b789bac42c5450ba19ba3c1f687ac0a0a34e711bf8b1c2a861bbbe83ec8dc8"
  },
  "task": {
    "horizon_s": 60,
    "history_samples": 6,
    "supervised_rows": 714,
    "folds": 3,
    "test_size": 120,
    "gap_rows": 1,
    "refit_per_fold": true,
    "new_observation_available_at_each_test_origin": true,
    "not_a_120_step_recursive_forecast": true
  },
  "folds": [
    {
      "fold": 1,
      "train_rows": 353,
      "test_rows": 120,
      "last_train_label_minute": 358,
      "first_test_origin_minute": 359,
      "last_test_origin_minute": 478,
      "mae_degC": {
        "linear": 0.31144014092125477,
        "persistence": 0.32687566672681073,
        "train_mean": 6.984665375517928
      }
    },
    {
      "fold": 2,
      "train_rows": 473,
      "test_rows": 120,
      "last_train_label_minute": 478,
      "first_test_origin_minute": 479,
      "last_test_origin_minute": 598,
      "mae_degC": {
        "linear": 0.336834061419829,
        "persistence": 0.3515851674476007,
        "train_mean": 9.3722850427789
      }
    },
    {
      "fold": 3,
      "train_rows": 593,
      "test_rows": 120,
      "last_train_label_minute": 598,
      "first_test_origin_minute": 599,
      "last_test_origin_minute": 718,
      "mae_degC": {
        "linear": 0.3473453155540079,
        "persistence": 0.37164986052386517,
        "train_mean": 7.7705452894907205
      }
    }
  ],
  "mean_fold_mae_degC": {
    "linear": 0.33187317263169724,
    "persistence": 0.35003689823275885,
    "train_mean": 8.042498569262516
  },
  "limits": "No fault labels, anomaly detector, safety threshold or field validation; no untouched final holdout used for model selection.",
  "checks": {
    "regular_one_minute_observations": true,
    "features_use_only_available_history": true,
    "training_labels_precede_test_origins": true,
    "all_predictions_finite": true,
    "mean_baseline_uses_training_targets_only": true,
    "mae_matches_manual_calculation": true,
    "test_rows_disjoint_across_folds": true,
    "deliberate_future_training_detected": true
  }
}
تمرین اول: اگر افق پیشبینی پنج دقیقه شود، آیا نگه داشتن فاصلهٔ یک ردیف کافی است؟ پاسخ: برای سیاست اکید همین مثال خیر؛ باید زمان برچسب را به origin+5 تغییر دهیم و فاصله را طوری تعیین کنیم که بیشترین زمان برچسب آموزش از اولین مبدأ آزمون کوچکتر بماند. در دادهٔ منظم و بدون تأخیر، فاصلهٔ پنجردیفی این شرط را برقرار میکند. وجود تأخیر در دریافت یا طول بازهٔ برچسب میتواند فاصلهٔ بیشتری لازم کند.
تمرین دوم: آیا برای محاسبهٔ میانگین ششتاییِ اولین ردیف آزمون میتوان گذشتهٔ قبل از مرز را خواند؟ پاسخ: بله، اگر آن مشاهدات در لحظهٔ تصمیم موجود باشند. خواندن گذشته با برازش تبدیل روی کل داده فرق دارد. اگر مقیاسسازی یا انتخاب ویژگی آموختنی اضافه شود، پارامترهای آن باید فقط از آموزش به دست آیند؛ راهنمای جلوگیری از نشت داده با Pipeline این بخش را توضیح میدهد.
تمرین سوم: آیا MAE برابر ۰٫۳۳۲ درجه ثابت میکند هشدار خرابی قابل اتکاست؟ پاسخ: خیر؛ دادهٔ ما برچسب خرابی، هزینهٔ هشدار اشتباه و سناریوی خطای حسگر ندارد. پیشبینی دما با تشخیص خرابی یکی نیست. برای ارزیابی هشدار، باید تعریف رویداد، تأخیر مجاز، پوشش شرایط کاری و معیارهای متناسب با هشدار جداگانه تعیین شوند.
تمرین چهارم: اگر حسگر در ۱۲۰ دقیقهٔ آینده مشاهدهٔ تازه نفرستد، میتوان همین خطا را نقل کرد؟ پاسخ: خیر؛ ورودی این آزمایش در هر دقیقه از مشاهدهٔ واقعیِ همان لحظه استفاده میکند. برای پیشبینی چندگامی بدون دریافت دادهٔ تازه، باید مسیر ساخت ویژگی و آزمون دیگری بسازیم. خطای تکگام را نمیتوان به عنوان خطای پیشبینی دو ساعت آینده گزارش کرد.
۵. قبل از بهرهبرداری چه شواهدی لازم است؟
این آموزش مجموعهٔ نهاییِ دستنخورده برای انتخاب مدل ندارد. اگر با دیدن امتیاز همین تقسیمها، الگوریتم، ویژگی یا فاصله را تغییر دهیم، ارزیابی نهایی به یک بازهٔ بعدی که برای تصمیمها استفاده نشده نیاز دارد. برای چند تجهیز، مسئلهٔ تعمیم به دستگاه تازه نیز جداست و تنها تقسیم زمانی یک تجهیز آن را پاسخ نمیدهد. ترتیب زمانی، شرط لازمِ این آزمایش است و پوشش همهٔ خطاهای احتمالی نیست.
در گزارش رویداد Research@ گوگل در ۲۲ مهر ۱۴۰۵، مدلهای زمانی و جدولی TimesFM و TabFM نیز مطرح شدهاند. این اشاره زمینهٔ روز موضوع است؛ مثال ما آن مدلها را اجرا نکرده و ادعای سازنده دربارهٔ کیفیت آنها را نتیجهٔ مستقل آزمایش خود نمیداند. آموزش حاضر بر روشی پایه تکیه دارد که برای مقایسهٔ مدل ساده و پیچیده به یک اندازه ضروری است.
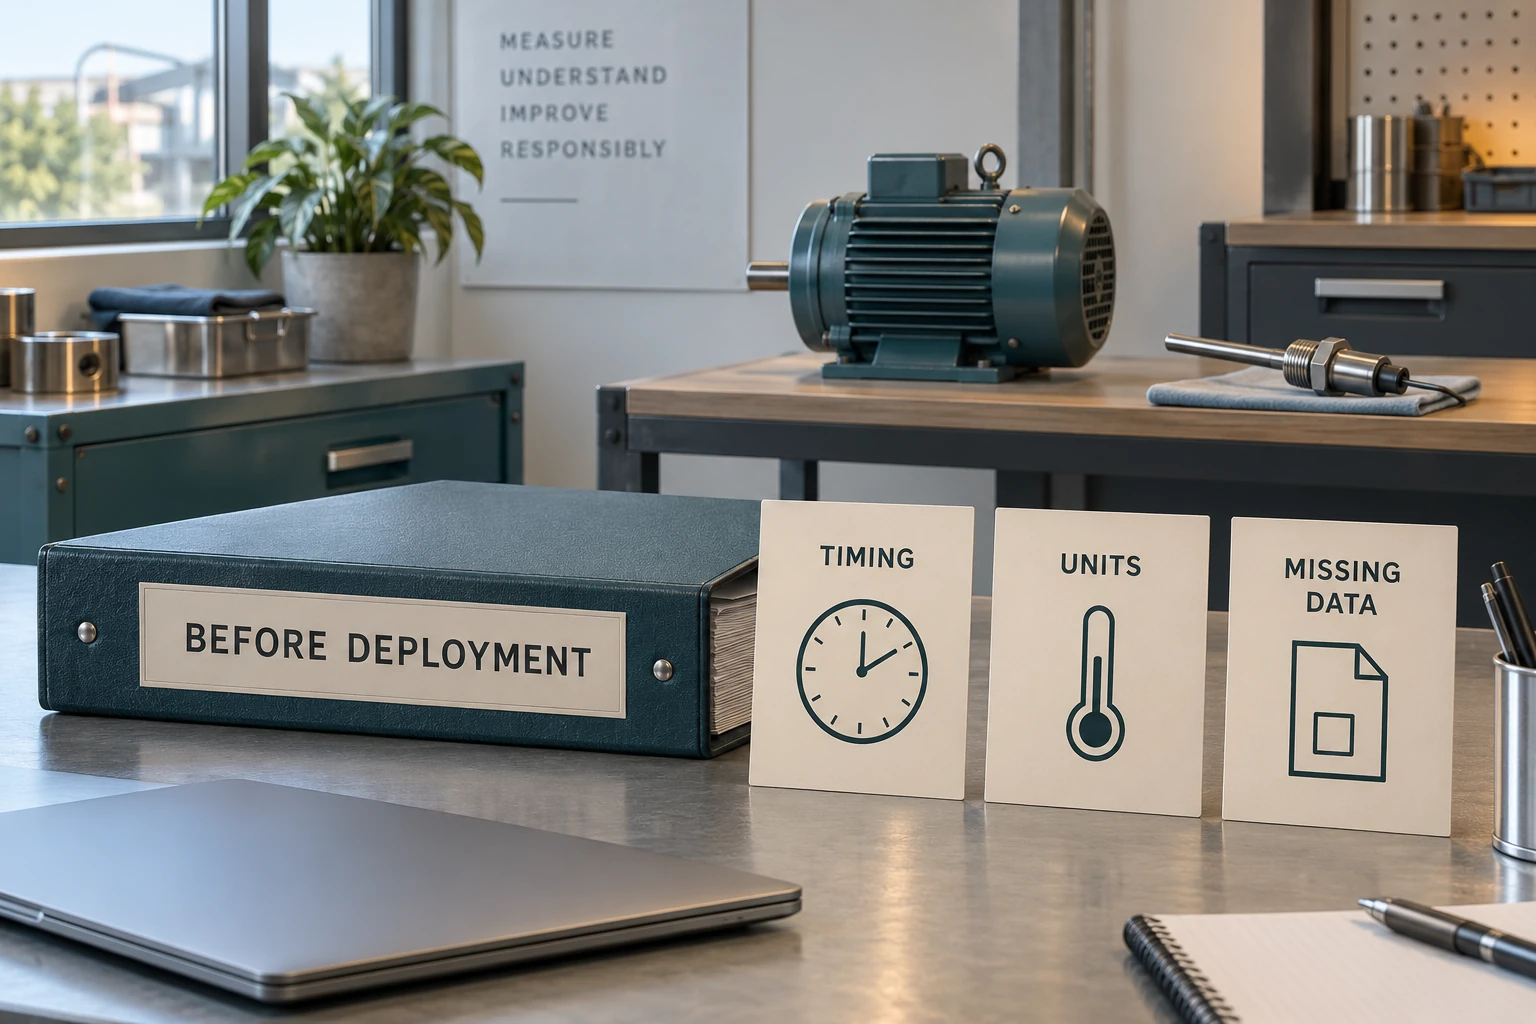
پیش از استقرار باید زمان رسیدن داده، واحد و کالیبراسیون حسگر، وضعیت دادهٔ گمشده، نسخهٔ مدل و رفتار هنگام قطع ارتباط ثبت شود. نتیجه را همراه با نسخهٔ محیط، هش داده و بازهٔ آزمون نگه دارید. برای طراحی ارزیابی گستردهتر، راهنمای ارزیابی عملی سامانهٔ هوش مصنوعی را ببینید. این شبیهسازی مجوز کنترل خودکار تجهیز یا آستانهٔ ایمنی تولید نمیکند؛ ارزش آن در روشن کردن قرارداد زمانی و آشکار کردن خطاهای مشخصِ فرایند ارزیابی است.
منابع و مطالعهٔ بیشتر
- تقسیم زمانی داده با TimeSeriesSplit
- ویژگیهای تأخیری و ارزیابی پیشبینی در scikit-learn
- رگرسیون کمترین مربعات با LinearRegression
- خط مبنای ساده با DummyRegressor
- میانگین خطای مطلق در scikit-learn
- گزارش Research@ 2026؛ بخش مدلهای زمانی و جدولی
بررسی منابع: ۲۳ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.