فهرست مقاله
ساخت Pipeline استانداردسازی و رگرسیون لجستیک، اعتبارسنجی درست، خروجی اجرای واقعی روی دادهٔ مصنوعی و پاسخ تمرینها.
این آموزش با دادهٔ مصنوعی و مثال تألیفی تهیه شده است. تصاویر، تصویرسازی مفهومیاند و شاهد عملکرد یک دستگاه واقعی نیستند. پاسخ تمرینها در متن آمده است. تاریخ بازبینی: ۲۲ مهر ۱۴۰۵؛ مبنای ساعت انتشار، تهران است.
۱. تعریف مسئلهٔ طبقهبندی و دادهٔ مصنوعی
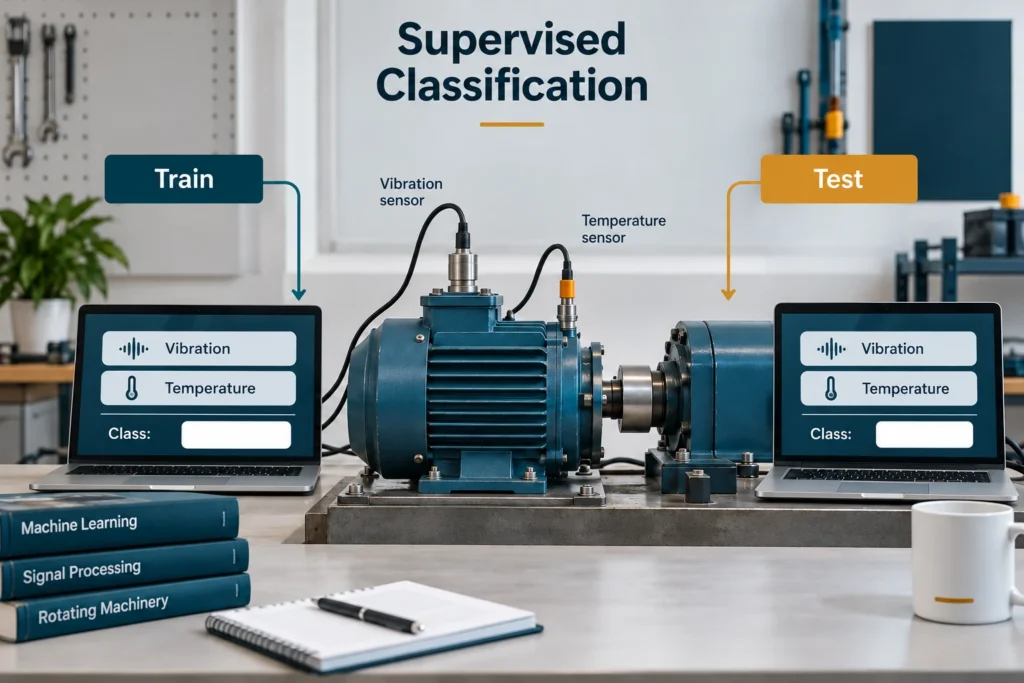
در این درس از دو ویژگی ارتعاش و دما برای پیشبینی یک برچسب دودویی مصنوعی استفاده میکنیم. مقدار ارتعاش با واحد میلیمتر بر ثانیه و دما با درجهٔ سلسیوس ساخته میشود. برچسب از ترکیب این دو ویژگی و اغتشاش به دست میآید. برچسب یک، تشخیص خرابی واقعی نیست؛ تنها کلاس تعریفشده برای تمرین است. برای اینکه یک مدل روی دستگاه صنعتی معنا داشته باشد، تعریف و روش تأیید خرابی باید از داده و آزمون معتبر به دست بیاید.
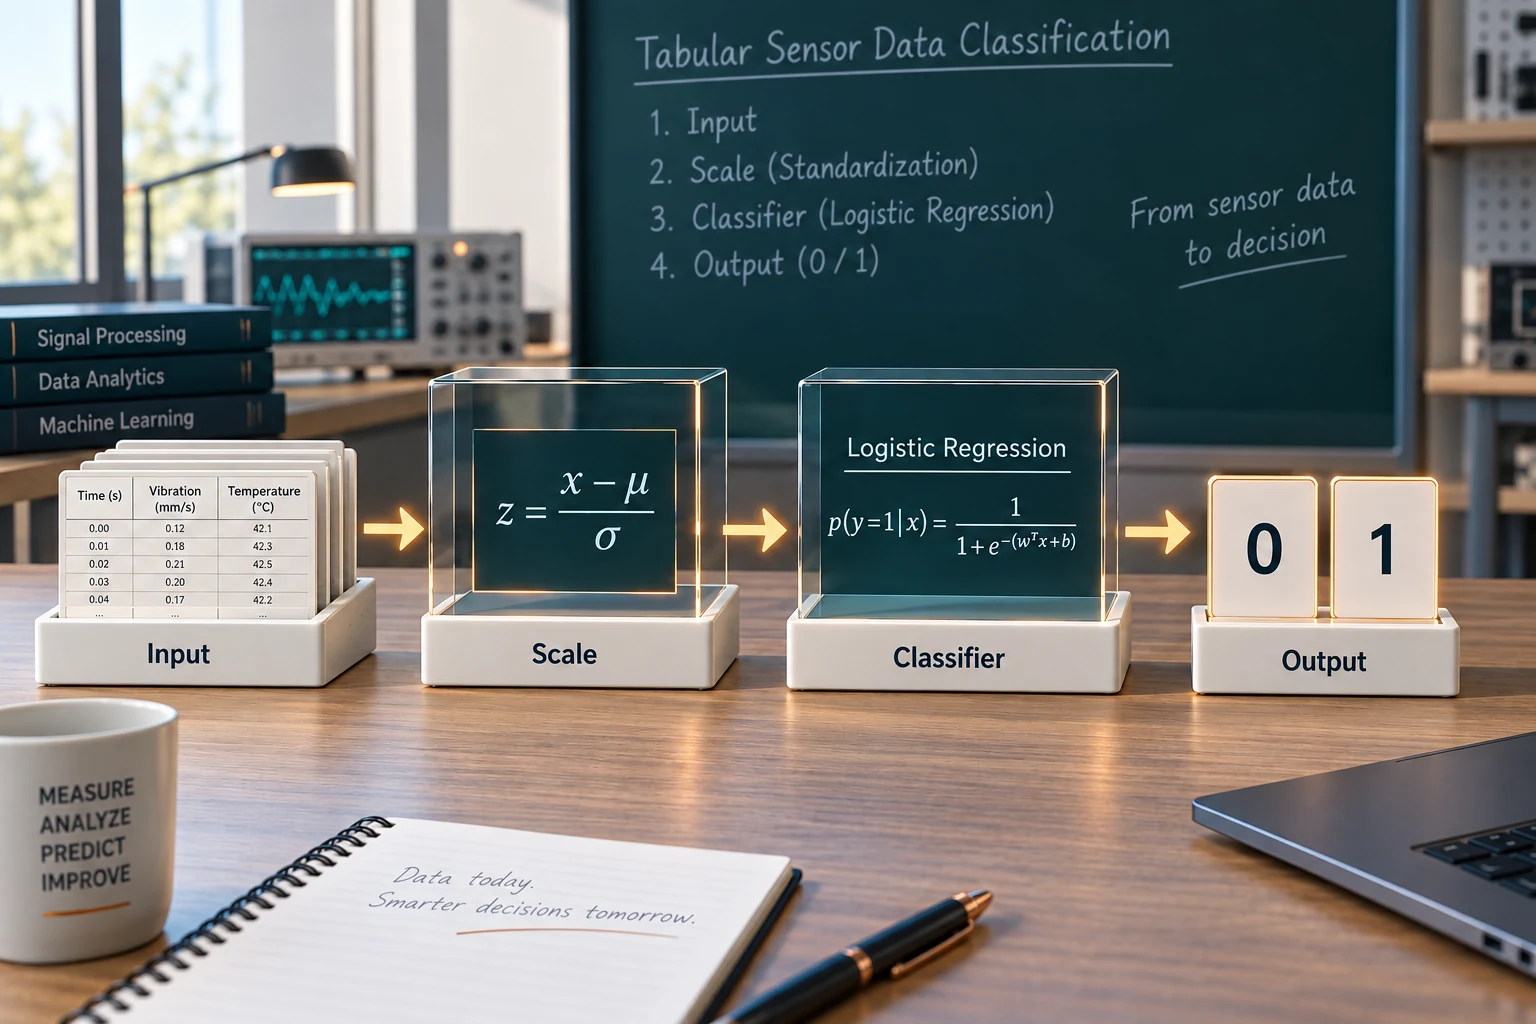
با مقیاس متفاوت ویژگیها، یک مرحلهٔ استانداردسازی پیش از رگرسیون لجستیک قرار میدهیم. مسئلهٔ آموزشی، ساخت قرارداد مشترک برای آمادهسازی و پیشبینی است. در مثال کمترین مربعات NumPy تنها دو پارامتر محاسبه میشد؛ اینجا یک طبقهبند و تبدیل آماری داده را کنار هم داریم. اگر تبدیل ورودی هنگام پیشبینی فراموش شود، مدل دادهای با معنای متفاوت دریافت میکند.
۲. جلوگیری از نشت و انتخاب تقسیم مناسب
ابتدا ۲۵ درصد داده را برای آزمون کنار میگذاریم و تقسیم طبقهبندیشده را به کار میبریم تا نسبت کلاسها تقریباً حفظ شود. هیچ پارامتر آمادهسازی از بخش آزمون یاد گرفته نمیشود. راهنمای خطاهای متداول scikit-learn بر جدا کردن آزمون پیش از برازش پیشپردازش تأکید میکند. Pipeline به اتصال تبدیل و مدل کمک میکند، اما طراحی غلط تقسیم را خودکار اصلاح نمیکند.
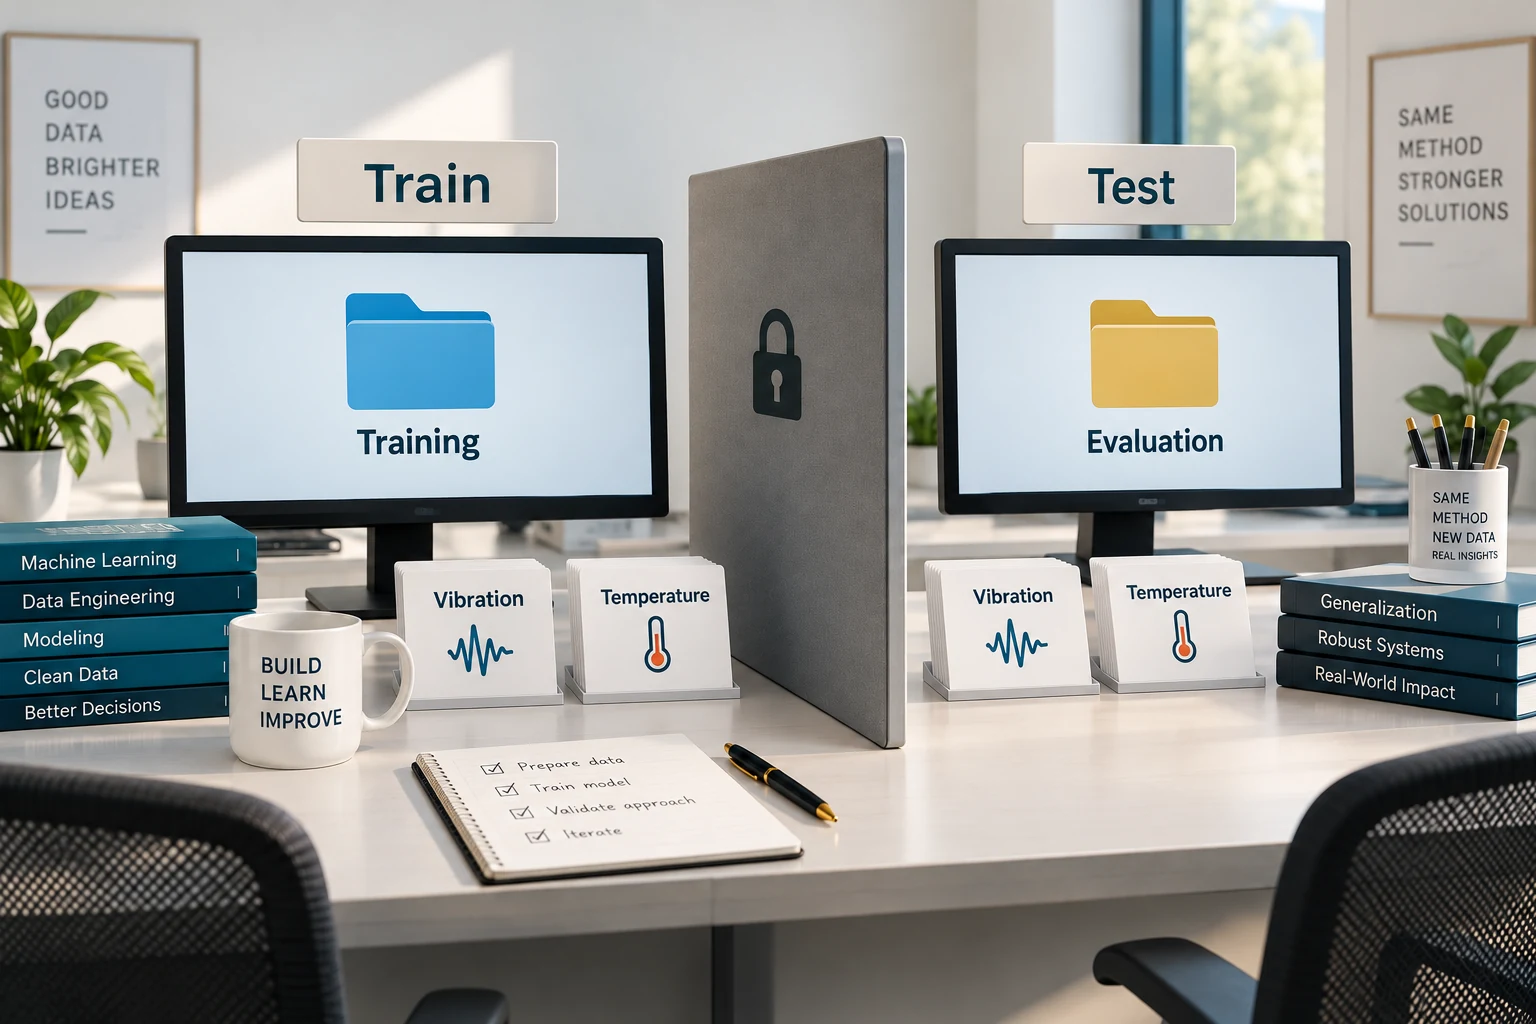
برای دادهٔ مصنوعی مستقل این درس، تقسیم تصادفی مناسب است. اگر چندین پنجرهٔ ارتعاش از یک دستگاه یا آزمایش مشترک دارید، پراکندن پنجرههای مشابه در هر دو بخش میتواند ارزیابی خوشبینانه بسازد. برای پیشبینی در زمان آینده، ترتیب زمانی و برای تعمیم به دستگاه تازه، گروه دستگاه را حفظ کنید. برچسب یا ویژگیای که پس از رویداد معلوم میشود، نباید وارد پیشبینی قبل از رویداد شود. اینها تصمیمهای مربوط به مسئلهاند و به انتخاب نام کتابخانه محدود نمیشوند.
۳. کد کامل Pipeline و اعتبارسنجی آموزشی
کد زیر در Python 3.14 با scikit-learn 1.9.1 و NumPy 2.5.4 اجرا شده است. اعتبارسنجی پنجبخشی فقط روی قسمت آموزشی انجام میشود و Pipeline در هر بخش، مقیاس را از دادهٔ آموزش همان بخش یاد میگیرد. سپس مدل روی کل قسمت آموزشی برازش و یکبار روی آزمون ارزیابی میشود. تعریف مراحل نامدار در مرجع Pipeline آمده است. معیار این مثال دقت متوازن است، نه صرفاً درصد همهٔ پاسخهای درست.
import numpy as np
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import balanced_accuracy_score, confusion_matrix

rng = np.random.default_rng(17)
vibration_mm_s = rng.uniform(0.5, 8.0, 320)
temperature_C = rng.uniform(25.0, 85.0, 320)
noise = rng.normal(0.0, 0.8, 320)
score = (vibration_mm_s - 4.0) + 0.04 * (temperature_C - 55.0) + noise
y = (score > 0).astype(int)
X = np.column_stack([vibration_mm_s, temperature_C])
Xtr, Xte, ytr, yte = train_test_split(
    X, y, test_size=0.25, random_state=17, stratify=y
)
model = Pipeline([
    ("scale", StandardScaler()),
    ("classifier", LogisticRegression(max_iter=1000, random_state=17)),
])
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=17)
cv_scores = cross_val_score(model, Xtr, ytr, cv=cv, scoring="balanced_accuracy")
model.fit(Xtr, ytr)
prediction = model.predict(Xte)
print(f"training CV balanced accuracy = {cv_scores.mean():.6f}")
print(f"holdout balanced accuracy = {balanced_accuracy_score(yte, prediction):.6f}")
print("confusion matrix [rows=true, columns=predicted]:")
print(confusion_matrix(yte, prediction))
assert np.allclose(model.named_steps["scale"].mean_, Xtr.mean(axis=0))
assert len(Xte) == 80 and len(prediction) == 80
کنترل پایانی بررسی میکند میانگین استانداردساز برابر میانگین Xtr باشد. این کنترل، یک خطای مشخص آمادهسازی را میگیرد؛ همهٔ نشتهای احتمالی داده را اثبات یا رد نمیکند. ویژگیهای استخراجشده، نحوهٔ برچسبگذاری و طراحی گروهها همچنان باید مستقلاً بررسی شوند.
۴. خروجی اجراشده و خواندن ماتریس درهمریختگی
در اجرای ثبتشده، میانگین دقت متوازن اعتبارسنجی آموزشی ۰٫۸۸۷۷۰۳ و دقت متوازن آزمون ۰٫۹۱۱۵۰۷ شد. ماتریس آزمون دو سطر دارد: سطر کلاس صفر شامل ۳۴ پیشبینی صفر و پنج پیشبینی یک است؛ سطر کلاس یک شامل دو پیشبینی صفر و ۳۹ پیشبینی یک است. سطر، برچسب واقعی و ستون، پیشبینی را نشان میدهد. در نتیجه ۷۳ نمونه از ۸۰ نمونه درست طبقهبندی شدهاند و دقت معمولی ۰٫۹۱۲۵ است. اختلاف کوچک آن با دقت متوازن از تعداد متفاوت اعضای کلاسها میآید.
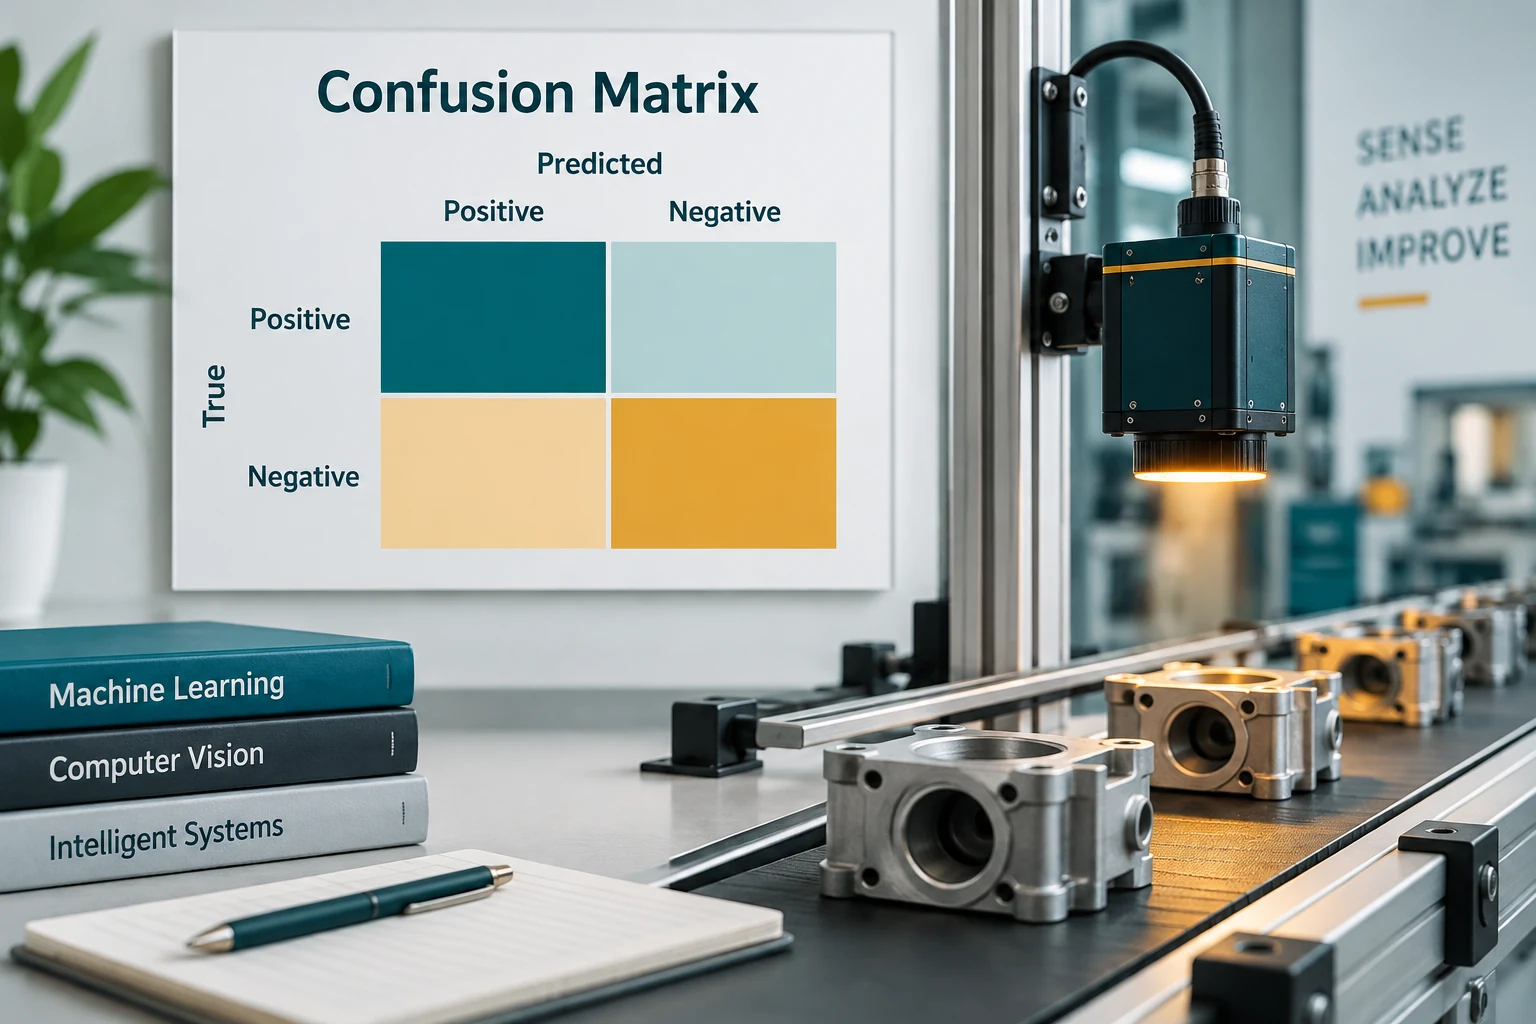
این اعداد برای دادهٔ مصنوعی مشخصاند و نباید به نرخ تشخیص خرابی محصول نسبت داده شوند. دقت متوازن، میانگین بازیابی دو کلاس است: ۳۴ تقسیم بر ۳۹ برای کلاس صفر و ۳۹ تقسیم بر ۴۱ برای کلاس یک. پاسخ سؤال «آیا بالاتر بودن آزمون از اعتبارسنجی خطاست؟» خیر است؛ نمونهها متفاوتاند و نوسان وجود دارد. با یک تقسیم نمیتوان برتری پایدار الگوریتم را نتیجه گرفت. تغییر مدل بر اساس همین آزمون، استقلال ارزیابی را از بین میبرد.
۵. تمرین حلشده و استفادهٔ درست در پروژه
تمرین اول: آیا میتوان StandardScaler را پیش از تقسیم، روی همهٔ داده fit کرد؟ پاسخ: خیر؛ میانگین و مقیاس آزمون وارد تبدیل میشود. ابتدا تقسیم کنید و برازش را در Pipeline روی آموزش انجام دهید. تمرین دوم: آیا داخل هر بخش اعتبارسنجی باید مقیاس دوباره محاسبه شود؟ پاسخ: بله، فقط از دادهٔ آموزش همان بخش. تمرین سوم: اگر چند ردیف از یک موتور مشترک باشند، آیا stratify بهتنهایی آنها را جدا میکند؟ پاسخ: خیر؛ stratify نسبت کلاسها را دنبال میکند و قرارداد گروه دستگاه را تضمین نمیکند.
انتخاب اندازهٔ آزمون و رفتار تقسیم را با مرجع train_test_split تطبیق دهید. مدل و استانداردساز را بهصورت یک Pipeline نگهداری کنید و نسخهٔ کتابخانهها، ترتیب و واحد ویژگیها را ثبت کنید. برای مقایسه با آمادهسازی در زبان دیگر، آموزش trainnet در متلب را بخوانید. انتقال یک مدل به کاربرد عملی، علاوه بر امتیاز آزمون به قرارداد ورودی، بررسی تغییر توزیع و رفتار هنگام دادهٔ نامعتبر نیاز دارد.
منابع و مطالعهٔ بیشتر
بررسی منابع: ۲۲ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.