فهرست مقاله
پس از آمادهشدنِ قطعههای یک پایگاه دانش، ممکن است همهٔ آنها در بودجهٔ باقیماندهٔ زمینه جا نشوند. انتخابِ چند قطعهٔ کامل، با بریدنِ متن یا مرتبکردنِ امتیازها مسئلهٔ یکسانی نیست. این درس، یک مدلِ کوچکِ کولهپشتی صفر و یک را برای چنین تصمیمی میسازد: هزینهها دادهشدهاند، ارزشها ساختگیاند و برنامه بهترین زیرمجموعه را برای همین قرارداد پیدا میکند. هیچ پاسخگوی تلفنی، توکنساز یا مدل زبانی اجرا نمیشود.
۱. هزینهٔ قطعه را از ارزشِ فرضی جدا کنیم
هر رکورد چهار جزء دارد: شناسه، متنِ کاملِ قطعه، هزینه و ارزش. ورودی، تاپلِ دقیق با حداکثر هشت رکورد است. شناسهٔ یکتا از یک حرفِ انگلیسی آغاز میشود و تا دوازده حرف، رقم یا زیرخط دارد؛ بزرگی و کوچکیِ حروف متفاوتاند. متن، رشتهٔ دقیقِ ناتهی با حداکثر ۱۲۸ نقطهٔ کد است. دو قطعه میتوانند متنِ یکسان داشته باشند؛ یکتاییِ شناسه، حذفِ محتوای تکراری را انجام نمیدهد.
هزینه، عددِ صحیحِ دقیق از یک تا شانزده و ظرفیت، عددِ صحیحِ صفر تا سیودو است. اینها سقفهای مثالاند. هزینه را یک قراردادِ بیرونیِ توکنسازی و محاسبهٔ سربار تأمین میکند؛ تابع آن را از طولِ متن نمیسازد. یک متنِ ۱۲۸نقطهای میتواند در دادهٔ ساختگی هزینهٔ یک داشته باشد. از این ورودی، تعدادِ توکنِ هیچ مدلِ واقعی نتیجه نمیگیریم.
ظرفیتِ ورودی فقط سهمِ باقیمانده برای قطعههاست. جایِ سیاست، پرسش، قالبِ پیام و خروجیِ رزروشده باید بیرون از این تابع حساب شود. جمعِ هزینههای اعلامشده نیز تنها وقتی نمایندهٔ هزینهٔ نهایی است که فرضِ جمعپذیریِ همان قرارداد برقرار باشد؛ چسباندنِ واقعیِ متنها و جداکنندهها اینجا انجام نمیشود. درسِ قطعهبندی و offset توضیح میدهد چرا نقطهٔ کد، بایت و توکن را نباید همواحد گرفت.
ارزش، عددِ صحیحِ نامنفیِ صفر تا سیودو و بیواحد است. آن را احتمالِ ارتباط یا میزانِ صحتِ پاسخ نمینامیم. مدل فرض میکند ارزشِ مجموعه برابرِ جمعِ ارزشهای اعضاست؛ تکرارِ اطلاعات، تکمیلِ یکدیگر یا تناقضِ دو قطعه را نمیفهمد. بنابراین حتی جوابِ بهینهٔ ریاضی، شواهدِ کافی برای مناسببودنِ مجموعه در یک پاسخِ واقعی نیست.
۲. چرا مرتبکردن بر اساس ارزش یا نسبت کافی نیست؟
سه قطعهٔ A، B و C را در نظر بگیرید. هزینههایشان سه، دو و دو و ارزشهایشان پنج، سه و سه است؛ ظرفیت چهار است. نسبتِ ارزش به هزینه برای A، پنجسوم و برای دو قطعهٔ دیگر سهدوم میشود. روشِ حریصانهٔ نسبت، A را برمیدارد؛ یک واحد باقی میماند و هیچکدام از دو قطعهٔ دیگر جا نمیشود. ارزشِ حاصل پنج است.
انتخابِ B و C هزینهٔ چهار و ارزشِ شش دارد و بهتر است. این شاهد، شکستِ همان قاعدهٔ حریصانه در انتخابِ صفر و یک را نشان میدهد. مجاز نیستیم نصفِ یک قطعه را برداریم یا یک شناسه را چند بار استفاده کنیم. پاسخِ مسئلهٔ کولهپشتیِ کسری، با این قرارداد فرق دارد؛ بالاترین ارزشِ تکی نیز در همین نمونه A را انتخاب میکند.
تعریفِ رسمیِ مسئله در راهنمای OR-Tools، بیشینهکردنِ ارزشِ مجموعِ اعضای جاگرفته در ظرفیت را توضیح میدهد. کاربردِ آن برای قطعاتِ دانش، مدلسازیِ آموزشیِ ماست. کدِ این مقاله کتابخانهٔ OR-Tools یا حلگرِ شاخهوکرانِ آن صفحه را وارد یا اجرا نمیکند؛ نمونه و محدودیتهای خودمان را با کتابخانهٔ استاندارد میسازیم.
۳. جدولِ ظرفیت و قاعدهٔ قطعیِ تساوی
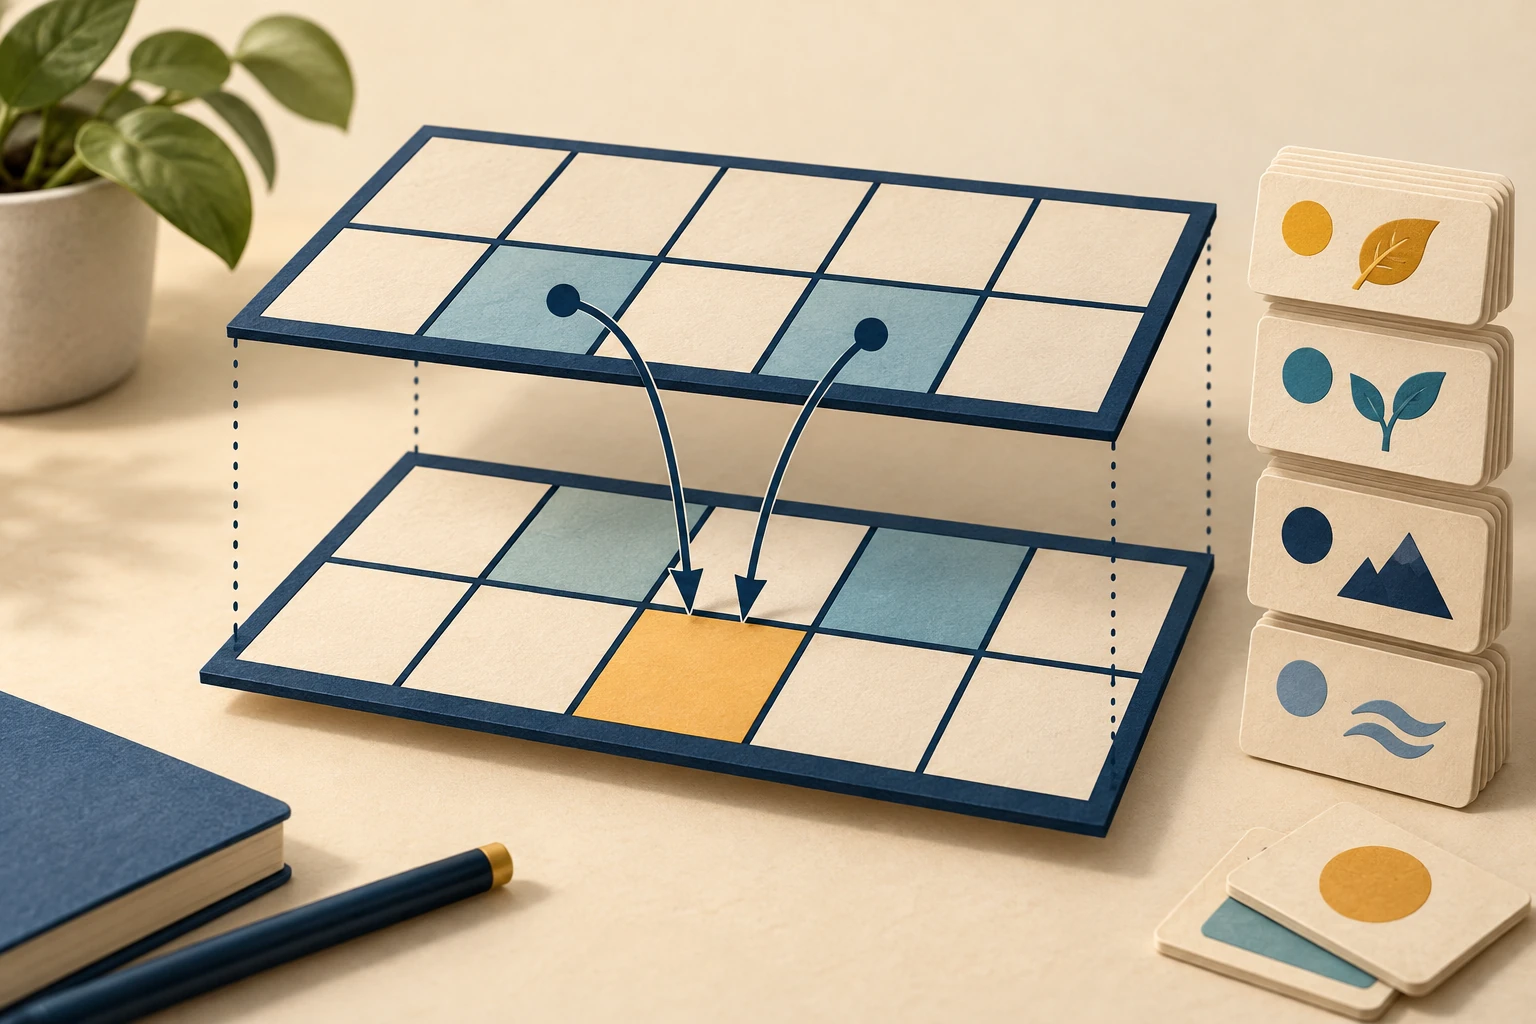
ابتدا رکوردها را با شناسه مرتب میکنیم. هر خانهٔ جدول، یک هزینهٔ دقیق را نشان میدهد؛ خانهٔ دستنیافتنی None است و با ارزشِ صفر اشتباه نمیشود. پیش از هر قطعه، یک لایهٔ قبلی داریم. لایهٔ تازه یا جوابِ قبلی را نگه میدارد، یا همان قطعه را به یک جوابِ قبلی با هزینهٔ مناسب اضافه میکند. خواندن از لایهٔ قبلی، استفادهٔ چندباره از قطعه را منتفی میکند.
یادداشتِ کولهپشتیِ درسِ الگوریتم MIT تصمیمِ گرفتن یا نگرفتن و وابستگیِ حالت به ظرفیت را شرح میدهد. جدولِ ما برای هزینهٔ دقیق تعریف شده، سپس بهترین خانهٔ مجاز را انتخاب میکند. برای نمونه، پس از A فقط هزینههای صفر و سه دستیافتنیاند. پس از دو قطعهٔ دیگر، خانهٔ هزینهٔ چهار به ارزشِ شش میرسد؛ گزارش، همهٔ لایههای ارزش را آشکار میکند.
ترتیبِ هدفها روشن است: ارزشِ بیشتر، سپس هزینهٔ کمتر و سرانجام ماسکِ عضویتِ کوچکتر. در ماسک، بیتِ صفر به اولین شناسهٔ مرتب تعلق دارد. اگر A با هزینهٔ دو و ارزشِ چهار با مجموعهٔ B و C، هرکدام هزینهٔ یک و ارزشِ دو، برابر شود، ماسکِ یک از شش کوچکتر است و A انتخاب میشود. این قاعده، ادعای کوچکترین تاپلِ واژگانی یا بیشترین تعدادِ قطعه نیست.
برای n قطعه و ظرفیتِ B، تعدادِ حالتها و انتقالهای اسکالر از مرتبهٔ nB است؛ مرتبسازی و ساختِ خروجی نیز کارِ جدا دارند. سقفِ هشت قطعه، ارزشِ تجمعی و ماسک را کوچک نگه میدارد. B مقدارِ عددیِ ظرفیت است، نه تعدادِ بیتهای نمایشِ آن؛ بزرگکردنِ ظرفیت میتواند جدول را بسیار بزرگ کند. این توضیحِ ساختارِ محاسبه، بنچمارک یا تضمینِ زمانِ پاسخِ سرویس نیست.
۴. کدِ کامل و مرجعِ همهٔ زیرمجموعهها
فایل را با نام rag_context_knapsack.py ذخیره کنید. ورودیِ برنامه داخلِ فایل است و هیچ متن یا هزینهای از شبکه دریافت نمیکند. bool، زیرکلاسهای نوع، شناور و رشتهٔ عددی تبدیل نمیشوند؛ شناسهٔ تکراری، متنِ تهی و هزینهٔ صفر رد میشوند. ظرفیتِ صفر و مجموعهٔ نامزدِ تهی معتبرند و انتخابِ تهی میدهند. ارزشِ صفر نیز معتبر است، اما افزودنِ هزینهٔ بیفایده، هدفِ ثانویه را بهتر نمیکند.
"""Bounded whole-chunk 0/1 selection; supplied costs, synthetic additive utility.

No tokenizer, LLM, retrieval, serialization, network or filesystem payload input.
Cost is an externally supplied charging contract, never len(text) or byte count.
"""
from fractions import Fraction
from itertools import combinations, permutations, product
import json
import platform
import re
import sys


def choose_chunks(chunks, capacity):
    """Exact tuple<=8 of (ID,text,cost,utility); exact int capacity0..32.

    ID: ASCII letter then letters/digits/underscore,1..12 chars, unique.
    Text: exact nonempty str<=128 codepoints; not used to estimate cost.
    Cost1..16 and utility0..32 are exact ints, excluding bool/subclasses.
    Maximize utility, then minimize cost, then canonical membership mask.
    Canonical IDs sort ascending; bit0 denotes the first ID. This tie rule
    does not claim the lexicographically smallest tuple of selected IDs.
    """
    if type(capacity) is not int or not 0 <= capacity <= 32:
        raise ValueError('capacity')
    if type(chunks) is not tuple or len(chunks) > 8:
        raise ValueError('chunks')
    identifiers = set()
    for record in chunks:
        if type(record) is not tuple or len(record) != 4:
            raise ValueError('record')
        identifier, text, cost, utility = record
        if (type(identifier) is not str or re.fullmatch(r'[A-Za-z][A-Za-z0-9_]{0,11}', identifier) is None
                or identifier in identifiers):
            raise ValueError('ID')
        identifiers.add(identifier)
        if type(text) is not str or not 1 <= len(text) <= 128:
            raise ValueError('text')
        if type(cost) is not int or not 1 <= cost <= 16:
            raise ValueError('cost')
        if type(utility) is not int or not 0 <= utility <= 32:
            raise ValueError('utility')
    items = tuple(sorted(chunks, key=lambda record: record[0]))
    # Each cell represents EXACT charged cost, so None means unreachable.
    states = [None] * (capacity + 1)
    states[0] = (0, 0)  # (utility, canonical membership mask)
    layers = [tuple(None if cell is None else cell[0] for cell in states)]
    for index, (_, _, cost, utility) in enumerate(items):
        following = states.copy()
        for used, cell in enumerate(states):
            if cell is None or used + cost > capacity:
                continue
            candidate = (cell[0] + utility, cell[1] | (1 << index))
            old = following[used + cost]
            if old is None or (-candidate[0], candidate[1]) < (-old[0], old[1]):
                following[used + cost] = candidate
        states = following  # No transition reads the new layer while adding an item.
        layers.append(tuple(None if cell is None else cell[0] for cell in states))
    used, (utility, mask) = min(((cost, cell) for cost, cell in enumerate(states) if cell is not None),
                               key=lambda row: (-row[1][0], row[0], row[1][1]))
    selected = tuple(record for index, record in enumerate(items) if mask & (1 << index))
    return {'selected_ids': tuple(record[0] for record in selected),
            'selected_texts': tuple(record[1] for record in selected),
            'charged_cost': used, 'utility': utility, 'unused_capacity': capacity - used,
            'canonical_ids': tuple(record[0] for record in items), 'membership_mask': mask,
            'exact_cost_optimum_utilities_by_layer': tuple(layers)}


def subset_reference(chunks, capacity):
    """Trusted small fixtures only: direct sums of all combinations, no DP/bitops.

    A reversed canonical membership BOOLEAN tuple orders ties like an unsigned
    mask, independently of the main function's mask representation/recurrence.
    """
    items = tuple(sorted(chunks, key=lambda record: record[0]))
    all_ids = tuple(record[0] for record in items)
    candidates = []
    for size in range(len(items) + 1):
        for selected in combinations(items, size):
            cost = sum(record[2] for record in selected)
            if cost <= capacity:
                value = sum(record[3] for record in selected)
                ids = tuple(record[0] for record in selected)
                indicators = tuple(identifier in ids for identifier in reversed(all_ids))
                candidates.append(((-value, cost, indicators), ids))
    key, ids = min(candidates)
    return {'selected_ids': ids, 'utility': -key[0], 'charged_cost': key[1]}


def density_greedy_fixture(chunks, capacity):
    """Counterexample fixture only, not the optimizer or its correctness oracle."""
    used, value, picked = 0, 0, []
    for identifier, _, cost, utility in sorted(chunks, key=lambda row: (-Fraction(row[3], row[2]), row[0])):
        if used + cost <= capacity:
            picked.append(identifier); used += cost; value += utility
    return {'selected_ids': tuple(picked), 'charged_cost': used, 'utility': value}


def rejects(chunks, capacity):
    try:
        choose_chunks(chunks, capacity)
    except ValueError:
        return True
    return False


def run():
    checks = {}
    def check(name, value):
        assert type(value) is bool, name
        checks[name] = value
        assert value, name

    chunks = (('A', 'adc-note', 3, 5), ('B', 'filter-note', 2, 3), ('C', 'clock-note', 2, 3))
    result = choose_chunks(chunks, 4)
    check('hand_whole_chunks_B_C_have_cost4_utility6',
          result['selected_ids'] == ('B', 'C') and result['selected_texts'] == ('filter-note', 'clock-note')
          and (result['charged_cost'], result['utility'], result['unused_capacity']) == (4, 6, 0))
    check('manual_exact_cost_layers_preserve_unreachable_None',
          result['exact_cost_optimum_utilities_by_layer'] ==
          ((0, None, None, None, None), (0, None, None, 5, None),
           (0, None, 3, 5, None), (0, None, 3, 5, 6)))
    greedy = density_greedy_fixture(chunks, 4)
    check('density_greedy_counterexample_is5_not6',
          greedy == {'selected_ids': ('A',), 'charged_cost': 3, 'utility': 5}
          and greedy['utility'] < result['utility'])
    empty = choose_chunks((), 32)
    check('empty_input_and_zero_residual_budget_allow_empty_selection',
          empty['selected_ids'] == () and empty['utility'] == empty['charged_cost'] == 0
          and empty['unused_capacity'] == 32 and choose_chunks(chunks, 0)['selected_ids'] == ())
    check('charged_cost_is_supplied_not_text_length_and_overbudget_is_excluded',
          choose_chunks((('Long', 'x' * 128, 1, 4),), 1)['utility'] == 4
          and choose_chunks((('Tiny', 'x', 16, 32),), 15)['selected_ids'] == ())
    one = choose_chunks((('Only', 'whole', 2, 3),), 32)
    check('each_whole_chunk_at_most_once_not_unbounded_reuse',
          one['selected_ids'] == ('Only',) and one['charged_cost'] == 2 and one['utility'] == 3)
    zero = (('A', 'unused-zero', 1, 0), ('B', 'useful', 2, 5))
    check('zero_utility_is_valid_and_extra_cost_not_preferred',
          choose_chunks((zero[0],), 32)['selected_ids'] == ()
          and choose_chunks(zero, 3)['selected_ids'] == ('B',))
    check('equal_utility_prefers_lower_charged_cost',
          choose_chunks((('A', 'a', 2, 5), ('B', 'b', 1, 5)), 2)['selected_ids'] == ('B',))
    tied = (('A', 'a', 2, 4), ('B', 'b', 1, 2), ('C', 'c', 1, 2))
    tie_result = choose_chunks(tied, 2)
    check('canonical_membership_mask_breaks_full_tie_deterministically',
          tie_result['selected_ids'] == ('A',) and tie_result['membership_mask'] == 1
          and subset_reference(tied, 2) == {'selected_ids': ('A',), 'utility': 4, 'charged_cost': 2})
    check('all6_input_permutations_preserve_canonical_result_ONE_group',
          all(choose_chunks(permuted, 2) == tie_result for permuted in permutations(tied)))
    maximum = tuple((chr(65 + index), 'same-text', 1, 32) for index in range(8))
    values = []
    valid = True
    for capacity in range(33):
        got = choose_chunks(maximum, capacity)
        selected = tuple(record for record in maximum if record[0] in got['selected_ids'])
        valid &= (got['charged_cost'] == sum(record[2] for record in selected) <= capacity
                  and got['utility'] == sum(record[3] for record in selected)
                  and got['unused_capacity'] == capacity - got['charged_cost'])
        values.append(got['utility'])
    check('capacity_monotonic_feasible_reconstruction_and_inclusive_upper_caps',
          bool(valid) and values == sorted(values) and choose_chunks(maximum, 32)['utility'] == 256
          and choose_chunks(maximum, 32)['membership_mask'] == 255)
    family_cases = 0
    for n in range(5):
        for profiles in product(((1, 0), (1, 2), (2, 1), (3, 4)), repeat=n):
            fixture = tuple((chr(65 + i), 'provided', cost, value) for i, (cost, value) in enumerate(profiles))
            for capacity in range(7):
                actual = choose_chunks(fixture, capacity)
                expected = subset_reference(fixture, capacity)
                assert all(actual[key] == value for key, value in expected.items())
                family_cases += 1
    check('2387_small_capacity_profiles_match_independent_all_subset_reference_ONE_group', family_cases == 2387)
    class IntSubclass(int): pass
    class StrSubclass(str): pass
    class TupleSubclass(tuple): pass
    consumed = []
    def source():
        consumed.append(True)
        yield chunks[0]
    invalid = [(chunks, cap) for cap in (-1, 33, True, 1.0, '4', IntSubclass(4))]
    nine_unique = tuple((chr(65 + i), 'x', 1, 1) for i in range(9))
    invalid += [(bad, 4) for bad in (None, [], source(), TupleSubclass(chunks), nine_unique)]
    invalid += [((bad,), 4) for bad in ([], ('A', 'x', 1), TupleSubclass(chunks[0]))]
    invalid += [(((identifier, 'x', 1, 1),), 4) for identifier in ('', '1A', 'A-B', 'x' * 13, StrSubclass('A'), 1)]
    invalid += [(((('A', 'x', 1, 1)), ('A', 'other', 2, 3)), 4)]
    invalid += [((('A', text, 1, 1),), 4) for text in ('', 'x' * 129, b'x', StrSubclass('x'))]
    invalid += [((('A', 'x', cost, 1),), 4) for cost in (0, -1, 17, True, 1.0, IntSubclass(1))]
    invalid += [((('A', 'x', 1, utility),), 4) for utility in (-1, 33, False, 1.0, IntSubclass(1))]
    check('strict_exact_types_IDs_nonempty_text_ranges_caps_and_no_iterator_pull',
          all(rejects(records, cap) for records, cap in invalid) and consumed == [])
    changed = choose_chunks(chunks, 4)
    changed['selected_ids'] = ('tampered',)
    check('immutable_inputs_and_fresh_independent_result_containers',
          choose_chunks(chunks, 4) == result and chunks ==
          (('A', 'adc-note', 3, 5), ('B', 'filter-note', 2, 3), ('C', 'clock-note', 2, 3)))
    assert len(checks) == 14
    return {'python': platform.python_version(), 'implementation': platform.python_implementation(),
            'dependencies': 'standard library only', 'cost_unit': 'externally supplied charged tokenizer-cost units; not bytes/words/codepoints',
            'utility_unit': 'synthetic unitless additive integer, not probability or answer quality',
            'limits': {'candidate_records': 8, 'text_codepoints': 128, 'cost': [1, 16], 'utility': [0, 32], 'capacity': [0, 32]},
            'hand_candidates_ID_text_cost_utility': chunks, 'hand_capacity': 4, 'hand_selection': result,
            'density_greedy_counterexample': greedy, 'tie_policy': 'max utility, min charged cost, min canonical membership mask; bit0 is first sorted ID',
            'complete_tie_example_selection': tie_result['selected_ids'],
            'reference_cases_inside_ONE_group': family_cases, 'invalid_fixtures_inside_ONE_group': len(invalid),
            'state_model': 'Exact cost layer: None unreachable; transitions read only previous item layer; O(nB) bounded scalar DP states/transitions',
            'oracle': 'Direct subset combinations and cost/value sums; reversed Boolean membership tuple for tie, no DP/bit operations/main calls',
            'assumptions': ['Supplied charged costs and utilities are additive independent records', 'Prompt/query/policy/output reserves external; no actual prompt serialization fit guarantee',
                            'No tokenizer, LLM, retrieval, quality, performance or security experiment'],
            'named_check_groups': len(checks), 'checks': checks}


if __name__ == '__main__':
    sys.stdout.buffer.write((json.dumps(run(), ensure_ascii=True, indent=2, allow_nan=False) + '\n').encode('utf-8'))
مرجعِ مستقل، تمامِ ترکیبهای اعضا را مستقیماً برمیشمرد و هزینه و ارزش را جمع میکند. جدولِ ظرفیت، انتقالِ لایهها و عملیاتِ بیتیِ تابعِ اصلی را ندارد. برای تساوی از تاپلِ بولیِ عضویت، در ترتیبِ معکوسِ شناسهها، استفاده میکند؛ این ترتیب با ماسکِ نامنفی همارز است. پاسخِ نهایی باید هم شناسهها و هم هزینه و ارزشِ مرجع را داشته باشد؛ برابرشدنِ یک عدد بهتنهایی کافی نیست.
خانوادهٔ محدودِ آزمون، صفر تا چهار قطعه با چهار جفتِ هزینه و ارزش و ظرفیتهای صفر تا شش دارد؛ ۲۳۸۷ حالت داخلِ یک گروه بررسی میشوند. جابهجاییِ شش ترتیبِ ورودیِ شاهدِ تساوی نیز یک گروه است. بررسیهای دستی، مرزهای ورودی، یکباربودنِ انتخاب، بازسازیِ جمعها و خروجیِ تازه، شاهدهای جدا هستند. کد چهارده گروهِ نامدار دارد؛ شمارِ حالتها بهعنوان گروههای تازه گزارش نمیشود.
{
  "python": "3.14.5",
  "implementation": "CPython",
  "dependencies": "standard library only",
  "cost_unit": "externally supplied charged tokenizer-cost units; not bytes/words/codepoints",
  "utility_unit": "synthetic unitless additive integer, not probability or answer quality",
  "limits": {
    "candidate_records": 8,
    "text_codepoints": 128,
    "cost": [
      1,
      16
    ],
    "utility": [
      0,
      32
    ],
    "capacity": [
      0,
      32
    ]
  },
  "hand_candidates_ID_text_cost_utility": [
    [
      "A",
      "adc-note",
      3,
      5
    ],
    [
      "B",
      "filter-note",
      2,
      3
    ],
    [
      "C",
      "clock-note",
      2,
      3
    ]
  ],
  "hand_capacity": 4,
  "hand_selection": {
    "selected_ids": [
      "B",
      "C"
    ],
    "selected_texts": [
      "filter-note",
      "clock-note"
    ],
    "charged_cost": 4,
    "utility": 6,
    "unused_capacity": 0,
    "canonical_ids": [
      "A",
      "B",
      "C"
    ],
    "membership_mask": 6,
    "exact_cost_optimum_utilities_by_layer": [
      [
        0,
        null,
        null,
        null,
        null
      ],
      [
        0,
        null,
        null,
        5,
        null
      ],
      [
        0,
        null,
        3,
        5,
        null
      ],
      [
        0,
        null,
        3,
        5,
        6
      ]
    ]
  },
  "density_greedy_counterexample": {
    "selected_ids": [
      "A"
    ],
    "charged_cost": 3,
    "utility": 5
  },
  "tie_policy": "max utility, min charged cost, min canonical membership mask; bit0 is first sorted ID",
  "complete_tie_example_selection": [
    "A"
  ],
  "reference_cases_inside_ONE_group": 2387,
  "invalid_fixtures_inside_ONE_group": 36,
  "state_model": "Exact cost layer: None unreachable; transitions read only previous item layer; O(nB) bounded scalar DP states/transitions",
  "oracle": "Direct subset combinations and cost/value sums; reversed Boolean membership tuple for tie, no DP/bit operations/main calls",
  "assumptions": [
    "Supplied charged costs and utilities are additive independent records",
    "Prompt/query/policy/output reserves external; no actual prompt serialization fit guarantee",
    "No tokenizer, LLM, retrieval, quality, performance or security experiment"
  ],
  "named_check_groups": 14,
  "checks": {
    "hand_whole_chunks_B_C_have_cost4_utility6": true,
    "manual_exact_cost_layers_preserve_unreachable_None": true,
    "density_greedy_counterexample_is5_not6": true,
    "empty_input_and_zero_residual_budget_allow_empty_selection": true,
    "charged_cost_is_supplied_not_text_length_and_overbudget_is_excluded": true,
    "each_whole_chunk_at_most_once_not_unbounded_reuse": true,
    "zero_utility_is_valid_and_extra_cost_not_preferred": true,
    "equal_utility_prefers_lower_charged_cost": true,
    "canonical_membership_mask_breaks_full_tie_deterministically": true,
    "all6_input_permutations_preserve_canonical_result_ONE_group": true,
    "capacity_monotonic_feasible_reconstruction_and_inclusive_upper_caps": true,
    "2387_small_capacity_profiles_match_independent_all_subset_reference_ONE_group": true,
    "strict_exact_types_IDs_nonempty_text_ranges_caps_and_no_iterator_pull": true,
    "immutable_inputs_and_fresh_independent_result_containers": true
  }
}
در انتخابِ بازههای بدونِ همپوشانی، محدودیت از تقاطعِ جایگاههای متن میآید و بودجهٔ طولِ خروجی نداریم. اینجا محدودیت، جمعِ هزینه است و دربارهٔ تقاطعِ بازهها تصمیم نمیگیریم. قطعهسازی، حذفِ تکرار و انتخابِ زیرمجموعه، مراحلِ متفاوتیاند؛ عوضکردنِ قید، مسئله و مرجعِ مناسبِ آن را تغییر میدهد.
۵. چهار پرسش دربارهٔ بودجه و محدودیتِ مدل
پرسش اول: چرا A با نسبتِ بهتر انتخابِ نهایی نیست؟ پاسخ: نسبتِ پنجسوم از سهدوم بزرگتر است، اما A سه واحد از چهار را مصرف میکند و یک واحد برای B یا C کافی نیست. B و C با هزینهٔ چهار، ارزشِ شش میدهند. برنامه به مجموعِ مجموعهٔ کامل نگاه میکند، نه فقط به امتیازِ انتخابِ اول.
پرسش دوم: آیا ظرفیتِ بیشتر باید همهٔ شناسههای قبلی را حفظ کند؟ پاسخ: خیر؛ مقدارِ بهینه نمیتواند کمتر شود، چون مجموعهٔ قبلی هنوز مجاز است، اما ترکیبِ برنده میتواند عوض شود. حتی پاسخهای همارزش با قاعدهٔ تساوی انتخاب میشوند. پس آزمونِ درست برای یکنواییِ ظرفیت، کاهشنیافتنِ ارزش است، نه زیرمجموعهبودنِ پاسخِ قبلی.
پرسش سوم: قطعهٔ با ارزشِ صفر را برای پرکردنِ ظرفیت برداریم؟ پاسخ: در این قرارداد خیر؛ ظرفیت، سقف است و پُرکردنِ آن هدف نیست. با ارزشِ برابر، هزینهٔ کمتر ترجیح دارد. اگر همهٔ ارزشها صفر باشند، مجموعهٔ تهی برنده است. برای الزامِ حضورِ یک شاهد یا شمارِ حداقلِ قطعه باید قیدِ دیگری تعریف کنیم.
پرسش چهارم: آیا انتخابِ ششامتیازی پاسخِ بهتری میسازد؟ پاسخ: چنین نتیجهای نداریم. امتیازها ساختگی و جمعپذیر فرض شدهاند؛ اعتبارِ سند، تعاملِ قطعهها، هزینهٔ بستهبندی و کیفیتِ پاسخ آزموده نشدهاند. یادداشتِ MIT تاریخِ چاپیِ ۲۳ نوامبر ۲۰۱۱ دارد؛ صفحهٔ Google آخرین بهروزرسانیِ ۲۸ اوت ۲۰۲۴ را نشان میدهد. دسترسیِ منابع در ۲۸ مهر ۱۴۰۵ است و این درس، خبرِ تازه یا گزارشِ عملکردِ محصول نیست.
منابع و مطالعهٔ بیشتر
- MIT6.006؛ کولهپشتی صفر و یک، جدول و وابستگی به ظرفیت
- Google OR-Tools؛ تعریف مسئلهٔ کولهپشتی و دادهٔ صحیح
بررسی منابع: ۲۸ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.