فهرست مقاله
گزارش «بیستوپنج درصد حذف بسته» ترتیب حذفها را نشان نمیدهد. چهار بستهٔ جدا از هم و چهار بستهٔ پشت سر هم میتوانند همین نسبت را بسازند، ولی الگوی ورودیِ روش بعدی متفاوت است. در این درس دو ماسک حذفِ کاملاً ساختگی را مقایسه میکنیم؛ هدف، دیدن چیزی است که نسبت کلی پنهان میکند. هیچ تماس، صوت، کدک یا شبکهٔ واقعی اندازهگیری نشده است.
۱. نسبت حذف را از ترتیب حذف جدا کنیم
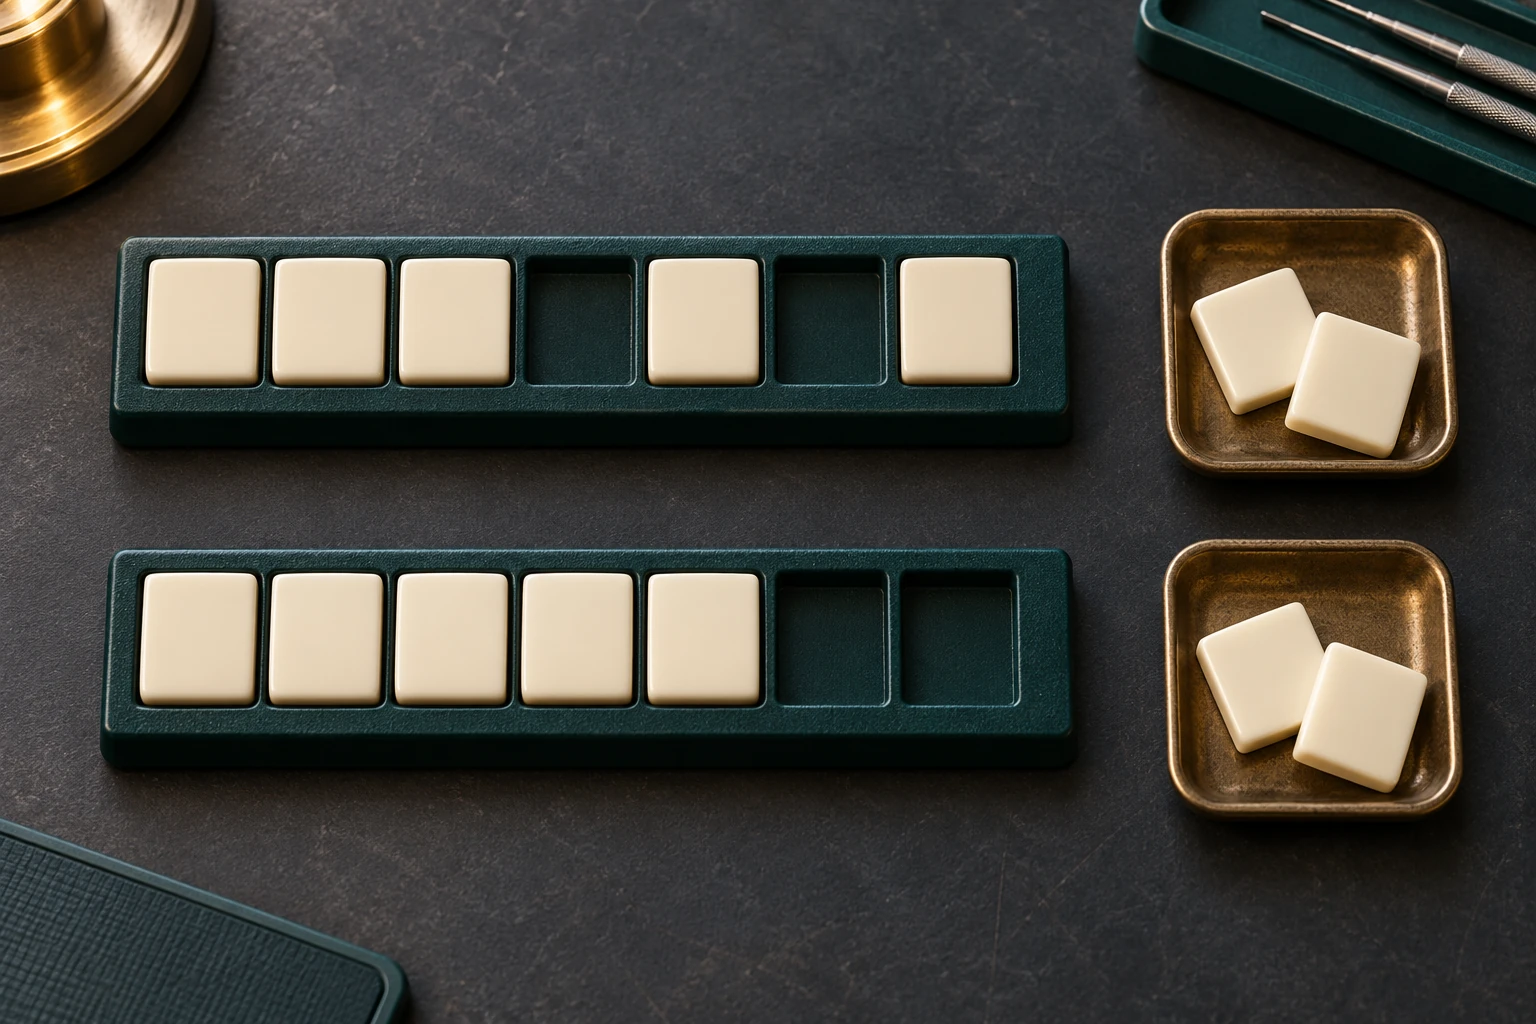
شانزده جایگاه زمانبندیشده داریم. در الگوی پراکنده، جایگاههای صفرمبنا دو، شش، ده و چهارده حذف شدهاند؛ در الگوی خوشهای، جایگاههای پنج تا هشت. حذف را از ابتدا خودمان تعیین میکنیم. این ماسک، استنتاجِ گمشدن دائمی از شمارههای دریافتی نیست و بستهٔ دیررس یا تکراری در آن وجود ندارد.
هر دو الگو چهار حذف از شانزده جایگاه دارند: نسبت دقیق یکچهارم است. مخرج، تعداد جایگاههای همین پنجره است، نه تعداد بستههای دریافتشده و نه تعداد رگهها. اگر چهار را بر دوازدهٔ باقیمانده تقسیم کنیم، پرسش دیگری ساختهایم. برای حفظ این تفاوت، صورت و مخرج را همراه الگو ثبت میکنیم.
در ردگیری شکاف توالی RTP، یک شکاف میتوانست با دریافت بعدی پر شود. اینجا ورودیِ آزمایش از پیش معلوم است و هیچ انتظار شبکهای نداریم. پس نام «حذف ساختگیِ تعیینشده» دقیقتر از ادعای اندازهگیری اتلاف واقعی است؛ یک تابع آماری نمیتواند منشأ نامعلومِ داده را خودش معتبر کند.
۲. رگهٔ متوالی را در پنجرهٔ مشاهده تعریف کنیم
رگه را دنبالهٔ بیشینهٔ جایگاههای حذفشدهٔ کاملاً متوالی تعریف میکنیم. یک جایگاهِ نگهداشتهشده، رگه را میشکند. بنابراین الگوی پراکنده چهار رگه با طول یک و الگوی خوشهای یک رگه با طول چهار دارد. بیشینهٔ طولها بهترتیب یک و چهار و میانگین طول رگهها نیز یک و چهار بسته است.
میانگین از مجموع تعداد حذفها تقسیم بر تعداد رگههای حذف به دست میآید؛ این عدد با نسبت حذف فرق دارد. در پنجرهٔ بدون حذف، رگهای نداریم، پس میانگین را None گزارش میکنیم، نه صفرِ وانمودشده بهعنوان میانگین یک مجموعهٔ غیرتهی. بیشینهٔ قراردادیِ همان حالت صفر است؛ این دو خروجی معنای متفاوت دارند.
برای حفظ ترتیب، کدگذاری طول رگه یا RLE روی هر دو مقدارِ نگهداشته و حذفشده ساخته میشود. هر رکورد، وضعیت و طول مثبت دارد و وضعیت رکوردهای همسایه متفاوت است. جمع طولها باید شانزده شود. بازکردن این فهرست باید دقیقاً ماسک اولیه را بسازد؛ هیستوگرامِ طولهای حذف بهتنهایی چنین اطلاعاتی را حفظ نمیکند.
۳. طول رگه و زمان قراردادی را یکی نگیریم
اگر هر جایگاه را نمایندهٔ بیست میلیثانیهٔ زمانبندیشده فرض کنیم، بلندترین بخشِ جایگاههای حذفشده در دو الگو بیست و هشتاد میلیثانیه میشود. این حاصلِ ضرب طول رگه در گامِ فرضی است؛ برنامه زمان ورود، تأخیر یکطرفه یا سکوت بازسازیشده را نمیداند. گام ده میلیثانیه، همان رگهٔ چهارتایی را چهل میلیثانیه میکند.
این عدد کیفیت شنیداری را اندازه نمیگیرد. برای چنین نتیجهای باید صوت، کدک، شیوهٔ پنهانسازی حذف و معیار ارزیابی مشخص باشند. در مدل موعد پخش و بستهٔ دیررس، برنامهٔ پخش مسئلهٔ جداگانهای بود. ماسک فعلی حتی نمیگوید بسته چرا حذف شده یا آیا دیرتر از مهلت رسیده است.
رگهٔ ابتدا یا انتهای پنجره ممکن است بیرون آن ادامه داشته باشد؛ ما فقط قسمت مشاهدهشده را میشماریم. همچنین ادغام گزارش دو پنجره به توجه به مرز نیاز دارد: دو حذفِ انتهای چپ و یک حذفِ ابتدای راست، در اتصال سه حذف متوالیاند. جمع سادهٔ هیستوگرامهای جدا، آن را اشتباهاً دو رگه با طولهای دو و یک نگه میدارد.
۴. کد را با الگوهای دستی و مرجع مستقل بسنجیم
فایل packet_loss_runs.py با Python 3.14.5 و کتابخانهٔ استاندارد اجرا شده است. ورودی، فهرست غیرتهیِ یک تا ۲۵۶ مقدار bool واقعی است؛ عددهای صفر و یک را خودکار تبدیل نمیکنیم. مقدار نامعلوم هم نداریم. اگر دادهٔ واقعی وضعیت نامعلوم دارد، ابتدا باید قرارداد آن را جدا تعریف کرد.
"""Synthetic finite loss-mask runs; not RTCP XR burst/gap metrics or audio quality."""
from collections import Counter
from fractions import Fraction
from itertools import groupby, product
import json
import platform


def validate_mask(mask):
    if type(mask) is not list or not 1 <= len(mask) <= 256:
        raise ValueError('expected 1..256 supplied loss flags')
    if any(type(flag) is not bool for flag in mask):
        raise ValueError('each supplied loss flag must be actual bool')


def summarize(mask, period_ms=20):
    validate_mask(mask)
    if type(period_ms) is not int or not 1 <= period_ms <= 1000:
        raise ValueError('synthetic fixed packet period must be 1..1000 ms')
    encoded = [{'lost': lost, 'count': sum(1 for _ in members)}
               for lost, members in groupby(mask)]
    lengths = [row['count'] for row in encoded if row['lost']]
    missing = sum(lengths)
    maximum = max(lengths, default=0)
    return {'packets': len(mask), 'lost_packets': missing,
            'loss_ratio': str(Fraction(missing, len(mask))),
            'loss_run_lengths': lengths,
            'loss_run_histogram': {str(k): v for k, v in sorted(Counter(lengths).items())},
            'longest_loss_run_packets': maximum,
            'mean_loss_run_packets': str(Fraction(missing, len(lengths))) if lengths else None,
            'synthetic_period_ms': period_ms,
            'longest_missing_scheduled_span_ms': maximum * period_ms,
            'rle': encoded}


def restore(encoded):
    if type(encoded) is not list or not 1 <= len(encoded) <= 256:
        raise ValueError('bounded nonempty RLE required')
    result = []
    previous = None
    for row in encoded:
        if type(row) is not dict or set(row) != {'lost', 'count'}:
            raise ValueError('exact RLE fields required')
        if type(row['lost']) is not bool or type(row['count']) is not int or not 1 <= row['count'] <= 256:
            raise ValueError('invalid RLE values')
        if row['lost'] == previous or len(result) + row['count'] > 256:
            raise ValueError('RLE must alternate within total bound')
        previous = row['lost']
        result.extend([row['lost']] * row['count'])
    return result


def oracle_lengths(mask):
    # Independent interval-start enumeration; no groupby, Counter or summarize.
    starts = [i for i in range(len(mask)) if mask[i] and (i == 0 or not mask[i - 1])]
    return [next((j for j in range(i + 1, len(mask)) if not mask[j]), len(mask)) - i for i in starts]


def rejects(fn):
    try:
        fn()
    except ValueError:
        return True
    return False


def run_example():
    isolated = [i in {2, 6, 10, 14} for i in range(16)]
    clustered = [i in {5, 6, 7, 8} for i in range(16)]
    a, b = summarize(isolated), summarize(clustered)
    exhaustive = []
    for length in range(1, 9):
        for bits in product([False, True], repeat=length):
            mask = list(bits)
            result = summarize(mask)
            expected_lengths = oracle_lengths(mask)
            expected_histogram = {str(n): expected_lengths.count(n) for n in set(expected_lengths)}
            exhaustive.append(result['loss_run_lengths'] == expected_lengths and
                              result['loss_run_histogram'] == expected_histogram and
                              result['lost_packets'] == sum(mask) and restore(result['rle']) == mask)
    rle_hand = [{'lost': False, 'count': 1}, {'lost': True, 'count': 2}, {'lost': False, 'count': 1}]
    before = isolated.copy()
    invalid_rle = [[], [{'lost': True, 'count': 0}], [{'lost': 1, 'count': 1}],
                   [{'lost': True, 'count': True}], [{'lost': True, 'count': 2}, {'lost': True, 'count': 1}],
                   [{'lost': True, 'count': 256}, {'lost': False, 'count': 1}],
                   [{'lost': True, 'count': 1, 'extra': 0}]]
    checks = {
        'literal_equal_loss_masks_different_runs': a['loss_run_lengths'] == [1, 1, 1, 1] and b['loss_run_lengths'] == [4],
        'same_exact_fraction_different_maximum': a['lost_packets'] == b['lost_packets'] == 4 and a['loss_ratio'] == b['loss_ratio'] == '1/4' and a['longest_loss_run_packets'] == 1 and b['longest_loss_run_packets'] == 4,
        'histogram_and_mean_hand_answers': a['loss_run_histogram'] == {'1': 4} and b['loss_run_histogram'] == {'4': 1} and a['mean_loss_run_packets'] == '1' and b['mean_loss_run_packets'] == '4',
        'rle_maintains_order_and_run_boundaries': summarize([False, True, True, False])['rle'] == rle_hand,
        'no_loss_and_all_loss_boundaries': summarize([False] * 4)['loss_run_lengths'] == [] and summarize([False])['mean_loss_run_packets'] is None and summarize([True] * 4)['loss_run_lengths'] == [4] and summarize([True])['loss_ratio'] == '1',
        'edge_clipped_runs_are_only_observed_lengths': summarize([True, True, False, True])['loss_run_lengths'] == [2, 1],
        'split_boundary_true_runs_need_merging': summarize([False, True, True] + [True, False])['loss_run_lengths'] == [3] and summarize([False, True, True])['loss_run_lengths'] + summarize([True, False])['loss_run_lengths'] == [2, 1],
        'fixed_period_conversion_is_an_assumption': a['longest_missing_scheduled_span_ms'] == 20 and b['longest_missing_scheduled_span_ms'] == 80 and summarize(clustered, period_ms=10)['longest_missing_scheduled_span_ms'] == 40,
        'rle_literal_restore': restore(rle_hand) == [False, True, True, False],
        'mask_length_exact_boundaries': summarize([False] * 256)['packets'] == 256 and rejects(lambda: summarize([])) and rejects(lambda: summarize([False] * 257)),
        'actual_bool_and_list_contract': all(rejects(lambda x=x: summarize(x)) for x in [[0, 1], [None], [True, 0], (False, True), '01']),
        'period_type_and_range': all(rejects(lambda x=x: summarize([True], x)) for x in [True, 0, 1001, 20.0]),
        'rle_decoder_rejects_invalid_and_noncanonical_records': all(rejects(lambda x=x: restore(x)) for x in invalid_rle),
        'independent_finite_pattern_oracle': all(exhaustive),
        'supplied_mask_is_preserved': isolated == before and restore(a['rle']) == before,
    }
    assert all(type(x) is bool and x for x in checks.values()), checks
    return {'python': platform.python_version(), 'dependencies': 'Python standard library only',
            'example_kind': 'Original finite synthetic ground-truth loss mask; not inferred RTP loss or standardized RTCP XR burst metrics',
            'isolated_loss_positions_zero_based': [2, 6, 10, 14],
            'clustered_loss_positions_zero_based': [5, 6, 7, 8],
            'isolated': a, 'clustered': b,
            'independent_pattern_cases_inside_one_group': len(exhaustive), 'checks': checks}


if __name__ == '__main__':
    print(json.dumps(run_example(), ensure_ascii=False, indent=2))
تابع groupby پایتون هنگام تغییر کلید، گروه تازه میسازد. در این کاربرد، ترتیب ورودی را حفظ میکنیم و پیش از گروهبندی مرتب نمیکنیم؛ مرتبسازی همهٔ حذفها را کنار هم میبرد و چیزی را که میخواهیم اندازه بگیریم عوض میکند. گروهِ iterator نیز همان لحظه مصرف میشود تا به پیمایش مشترک وابسته نماند.
پاسخ دستی، هیستوگرام چهار رگهٔ یکتایی در برابر یک رگهٔ چهارتایی است. پانزده گروه بررسی اجرا شدهاند. مرجع مستقل، آغاز هر دنبالهٔ حذف را از همسایهٔ قبلی پیدا میکند و اولین جایگاه نگهداشتهشدهٔ بعدی را انتهای آن میگیرد؛ از groupby و تابع خلاصهسازی استفاده نمیکند. هر ۵۱۰ الگوی ممکن با طول یک تا هشت در یک گروه مقایسه میشوند.
۵. رگهٔ آموزشی با burst استاندارد برابر نیست
بخشهای ۴٫۷٫۱ و ۴٫۷٫۲ از RFC 3611، اتلاف، کنارگذاشتن و معیارهای burst را تفکیک میکنند. تعریف burst با آستانهٔ Gmin میتواند بستههای دریافتشده را نیز میان دو حذف در یک دوره نگه دارد. رگهٔ این درس با اولین نگهداشتن قطع میشود؛ بنابراین خروجی آن burst density، gap duration یا فیلد استاندارد گزارش RTCP نیست.
{
  "python": "3.14.5",
  "dependencies": "Python standard library only",
  "example_kind": "Original finite synthetic ground-truth loss mask; not inferred RTP loss or standardized RTCP XR burst metrics",
  "isolated_loss_positions_zero_based": [
    2,
    6,
    10,
    14
  ],
  "clustered_loss_positions_zero_based": [
    5,
    6,
    7,
    8
  ],
  "isolated": {
    "packets": 16,
    "lost_packets": 4,
    "loss_ratio": "1/4",
    "loss_run_lengths": [
      1,
      1,
      1,
      1
    ],
    "loss_run_histogram": {
      "1": 4
    },
    "longest_loss_run_packets": 1,
    "mean_loss_run_packets": "1",
    "synthetic_period_ms": 20,
    "longest_missing_scheduled_span_ms": 20,
    "rle": [
      {
        "lost": false,
        "count": 2
      },
      {
        "lost": true,
        "count": 1
      },
      {
        "lost": false,
        "count": 3
      },
      {
        "lost": true,
        "count": 1
      },
      {
        "lost": false,
        "count": 3
      },
      {
        "lost": true,
        "count": 1
      },
      {
        "lost": false,
        "count": 3
      },
      {
        "lost": true,
        "count": 1
      },
      {
        "lost": false,
        "count": 1
      }
    ]
  },
  "clustered": {
    "packets": 16,
    "lost_packets": 4,
    "loss_ratio": "1/4",
    "loss_run_lengths": [
      4
    ],
    "loss_run_histogram": {
      "4": 1
    },
    "longest_loss_run_packets": 4,
    "mean_loss_run_packets": "4",
    "synthetic_period_ms": 20,
    "longest_missing_scheduled_span_ms": 80,
    "rle": [
      {
        "lost": false,
        "count": 5
      },
      {
        "lost": true,
        "count": 4
      },
      {
        "lost": false,
        "count": 7
      }
    ]
  },
  "independent_pattern_cases_inside_one_group": 510,
  "checks": {
    "literal_equal_loss_masks_different_runs": true,
    "same_exact_fraction_different_maximum": true,
    "histogram_and_mean_hand_answers": true,
    "rle_maintains_order_and_run_boundaries": true,
    "no_loss_and_all_loss_boundaries": true,
    "edge_clipped_runs_are_only_observed_lengths": true,
    "split_boundary_true_runs_need_merging": true,
    "fixed_period_conversion_is_an_assumption": true,
    "rle_literal_restore": true,
    "mask_length_exact_boundaries": true,
    "actual_bool_and_list_contract": true,
    "period_type_and_range": true,
    "rle_decoder_rejects_invalid_and_noncanonical_records": true,
    "independent_finite_pattern_oracle": true,
    "supplied_mask_is_preserved": true
  }
}
حتی نسبت کسریِ این مثال، کدگذاری هشتبیتیِ نرخ اتلافِ استاندارد را تولید نمیکند. حد اندازه و بازکردنِ RLE فقط قرارداد محدود داده را بررسی میکنند. منابع در ۲۵ مهر ۱۴۰۵ خوانده شدند؛ RFC مربوط به نوامبر ۲۰۰۳ و مستندات پایتون 3.14.8 از اجرای 3.14.5 جدا ثبت شدهاند. این تمرین، آموزش پایه است و خبر تازه یا ارزیابی محصول محسوب نمیشود.
پرسش اول: نسبت یکچهارم یعنی هر چهارمین بسته حذف شده؟ پاسخ: خیر؛ این فقط نسبت تعداد است. الگوی خوشهای همان نسبت را با چهار حذف پشت سر هم دارد.
پرسش دوم: در حالت بدون حذف، میانگین صفر است؟ پاسخ: در قرارداد ما تعریف نشده و None است؛ رگهای برای میانگینگرفتن نداریم.
پرسش سوم: دو پنجره را با جمع هیستوگرام ادغام کنیم؟ پاسخ: فقط اگر اثر مرز را هم حساب کنیم؛ دو رگهٔ حذفِ چسبیده در مرز باید یکی شوند.
پرسش چهارم: رگهٔ بلندتر الزاماً امتیاز صوت بدتری دارد؟ پاسخ: این کد چنین نتیجهای نمیدهد؛ تنها ترتیب حذفِ ساختگی را توصیف میکند. کیفیت به داده و مسیر پردازشِ جدا نیاز دارد.
منابع و مطالعهٔ بیشتر
بررسی منابع: ۲۵ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.