فهرست مقاله
دو ویژگی ممکن است معمولاً با هم تغییر کنند. در این صورت، جمعِ سادهٔ مربعِ اختلافِ ستونها، تنها هندسهٔ ممکن برای مقایسهٔ بردارها نیست. این درس فاصلهٔ ماهالانوبیس را برای یک مرجعِ کوواریانسِ صریح بررسی میکند: چگونه جابهجاییِ همجهت و خلافجهت وزنِ متفاوت میگیرند، چرا کوواریانس با وارونِ آن یکی نیست، و چگونه محاسبه را بدون ساختنِ وارونِ صریح بازبینی کنیم. تمام بردارها و مرجعِ مثال تألیفیاند؛ هیچ مدل یا موتورِ جستوجوی واقعی ارزیابی نمیشود.
۱. بردارِ مشترک و کوواریانسِ دادهشده
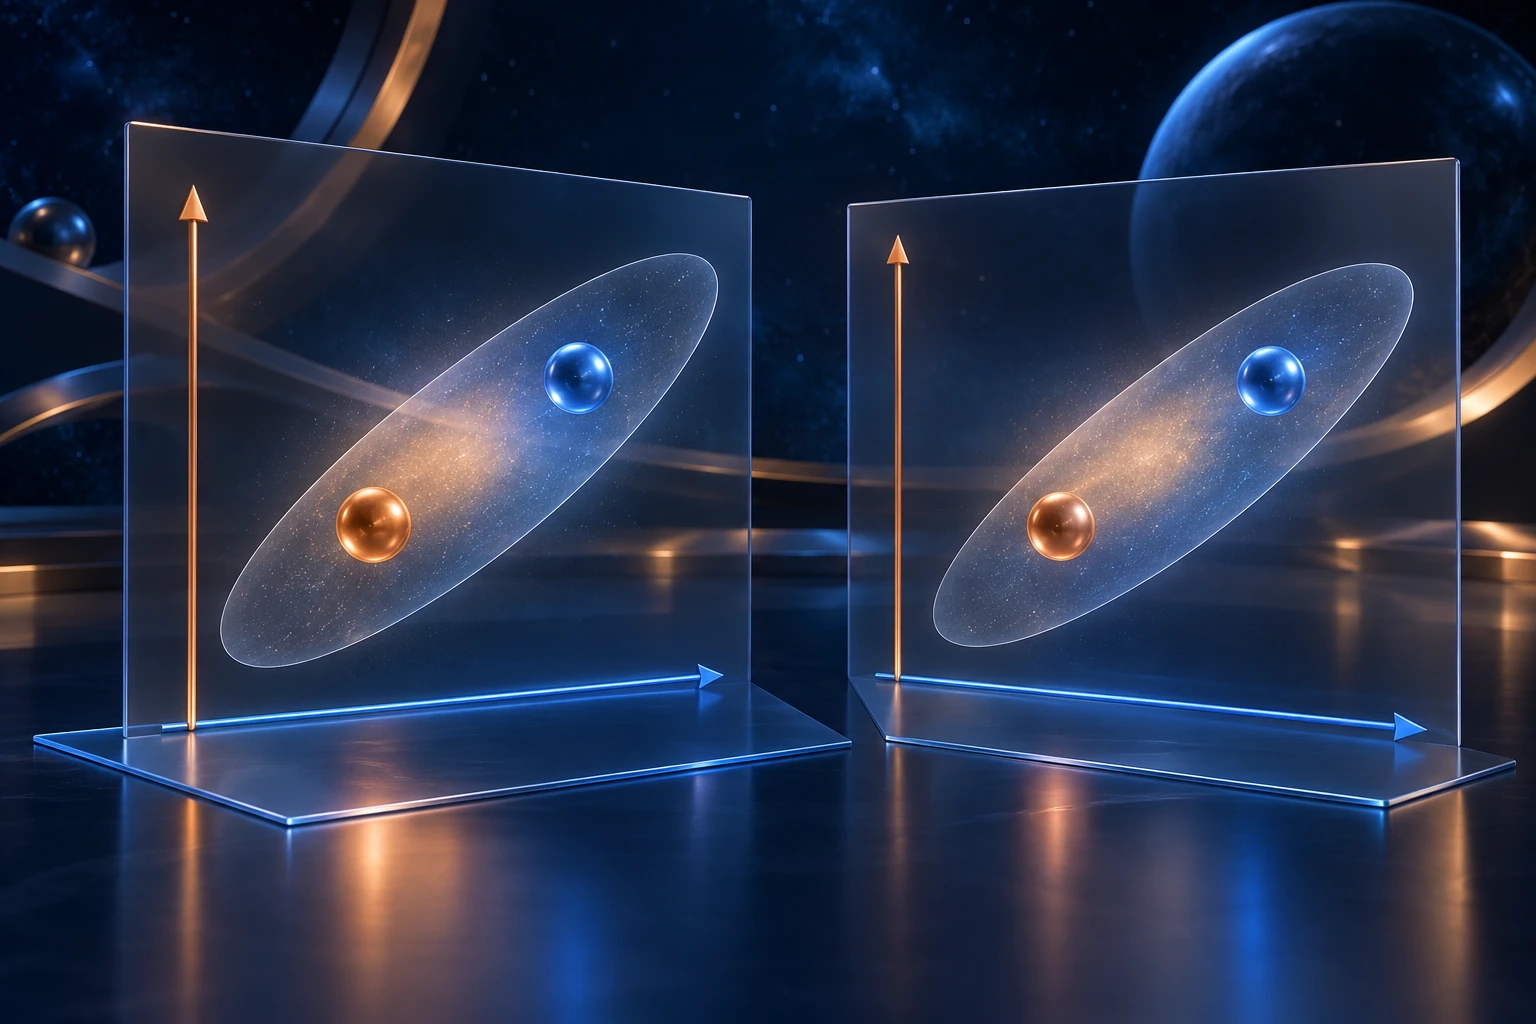
دو سندِ فرضی را با دو ضریبِ بیواحد و علامتدار نمایش میدهیم. نامِ ستونها فقط ویژگیِ مدار و ویژگیِ سیگنال است؛ این مقدارها شمارشِ واژه، احتمال، اندازهگیریِ حسگر یا خروجیِ نهفتهساز نیستند. پرسوجو و سند باید همین ترتیبِ ستونها را داشته باشند. مانند درسِ شباهتِ کسینوسی، برابر بودنِ بُعد، درست بودنِ معنای ستونها را ثابت نمیکند.
پرسوجو صفر و صفر است. سندِ نخست، دو و دو و سندِ دوم، یک و منفیِ یک دارد. مرجعِ کوواریانس را با سطرهای چهار و سه، سپس سه و چهار میدهیم. این ماتریس از داده برازش نشده است؛ نویسنده آن را برای روشن شدنِ هندسه انتخاب کرده است. عاملِ بیرونیِ سامانه باید منشأ، نسخه و مناسب بودنِ چنین مرجعی را تعیین کند؛ تابعِ فاصله آن اطلاعات را کشف نمیکند.
قطرهای مرجع چهار و کوواریانسِ مشترک سه است. در این مدل، جهتِ تغییرِ همزمانِ دو ویژگی با جهتِ افزایشِ یکی و کاهشِ دیگری یکسان وزن نمیگیرد. این یک رابطهٔ درجهدویِ دادهشده است، نه ادعای علت و معلول یا وابستگیِ اندازهگیریشده. اگر ویژگیها واحدِ فیزیکی داشته باشند، خانهٔ سطرِ i و ستونِ j کوواریانس باید حاصلِ ضربِ واحدهای همان دو ویژگی را داشته باشد؛ با تبدیلِ سازگار، فاصله بیواحد میشود.
۲. چرا تغییرِ همجهت میتواند نزدیکتر باشد؟
تعریفِ کاملِ mahalanobis در SciPy، ریشهٔ فرمِ درجهدویِ اختلافِ دو بردار با وارونِ کوواریانس است. مربعِ فاصله را نیز میتوان جدا نگه داشت؛ ریشه روی عددهای نامنفی ترتیب را حفظ میکند. مربعِ فاصله همان فاصله نیست و نسبتِ آنها را نباید جابهجا گزارش کرد. در برنامه، نامِ خروجی صریحاً فاصلهٔ مربعی است.
فاصلهٔ اقلیدسیِ مربعیِ دو سند از پرسوجو، هشت و دو است؛ بنابراین سندِ دوم نزدیکتر است. اما وارونِ مرجعِ انتخابشده، سطرهای چهارهفتم و منفیِ سههفتم، سپس منفیِ سههفتم و چهارهفتم دارد. فرمِ درجهدو برای سندِ اول هشتهفتم و برای سندِ دوم دو میشود. اکنون سندِ اول نزدیکتر است. این تغییرِ ترتیب، نتیجهٔ عوض شدنِ هندسه است و بهتر شدنِ ارتباطِ سند را ثابت نمیکند.
در رابطِ SciPy، آرگومانِ VI باید وارونِ کوواریانس باشد. اگر خودِ ماتریسِ دادهشده را در جای آن بگذاریم، فرمِ مربعی برای همین شاهد ۵۶ و دو میشود. حاصل، صرفاً خطای گردکردن نیست؛ کمیتِ دیگری ساختهایم. ممکن است آن ماتریس برای مدلِ دیگری نقشِ دقت را داشته باشد، اما دیگر همان مرجعِ اولیه نیست. تابعِ حاضر مستقیماً کوواریانس میگیرد تا این تفاوت در نامِ ورودی روشن بماند.
۳. عاملگیری و حل، بهجایِ وارونسازیِ صریح
برای کوواریانسِ حقیقیِ متقارن و مثبتمعین، عاملِ پایینمثلثیِ L را بهگونهای میگیریم که حاصلِ ضربِ آن در ترانهادهاش مرجع را بسازد. مستندِ جاریِ Cholesky در NumPy پیششرطها را مشخص میکند. خودِ کتابخانه تقارنِ کامل را بررسی نمیکند؛ برنامه پیش از عاملگیری، همهٔ خانههای تبدیلشده را از نظرِ متناهی بودن و تقارن میسنجد. این اعتبارسنجی، موضوعِ اصلیِ جدید نیست؛ مقدمهٔ استفادهٔ درست از فاصله است.
اختلافِ هر سند و پرسوجو را یک ستون میگذاریم و دستگاهِ L ضربدرِ z برابرِ آن اختلاف را حل میکنیم. مجموعِ مربعِ مؤلفههای z، فاصلهٔ مربعیِ مطلوب است؛ چون وارونِ مرجع برابرِ حاصلِ ضربِ وارونِ ترانهادهٔ L و وارونِ L است. عامل فقط یک بار برای همان دسته ساخته میشود. کد از solve عمومی استفاده میکند؛ ادعای حلگرِ مثلثیِ تخصصی یا اندازهگیریِ شتاب نداریم.
قراردادِ solve، سمتِ راستِ ماتریسی و شرطِ دستگاهِ مربعیِ تمامرتبه را توضیح میدهد. واژهٔ «حل» در این API به معنای حسابِ کسریِ دقیق نیست؛ مسیرِ واقعی float64 و LAPACK است. ماتریسِ نزدیک به تکینی میتواند حساس باشد. هیچ تضمینِ عمومیِ خطای کوچک، رتبهبندیِ دقیقِ فاصلههای بسیار نزدیک یا اصلاحِ خودکارِ کوواریانس از این فراخوانی نتیجه نمیشود.
۴. کدِ کامل و مرجعِ کسریِ مستقل
فایل را با نامِ mahalanobis_feature_distance.py ذخیره کنید. رابط فقط list یا tuple دقیق با یک تا ۶۴ سند و یک تا هشت ویژگی میپذیرد. هر مؤلفه int یا float دقیقِ پایتون است؛ پس از تبدیلِ متناهی، قدرمطلقِ ویژگی حداکثر ۱۶ و قدرمطلقِ خانهٔ کوواریانس حداکثر ۶۴ است. bool، رشته، زیرکلاس و آرایهٔ آماده در این رابط رد میشوند؛ اینها محدودیتِ آموزشیِ خودماناند، نه دامنهٔ عمومیِ روش.
"""Supplied covariance geometry, not learned semantic relevance or outlier inference."""
from fractions import Fraction
from itertools import product
import json
import math
import platform
import numpy as np


def vector(values, size, limit):
    if type(values) not in (list, tuple) or len(values) != size:
        raise ValueError('an exact list/tuple with the required dimension is required')
    out = []
    for value in values:
        if type(value) not in (int, float):
            raise ValueError('only exact Python int/float, not bool or subclass')
        try:
            number = float(value)
        except OverflowError as error:
            raise ValueError('finite representable coordinate required') from error
        if not math.isfinite(number) or abs(number) > limit:
            raise ValueError('finite coordinate within the declared bound required')
        out.append(number)
    return out


def squared_distances(candidates, query, covariance):
    """1..64 rows, 1..8 common features; supplied symmetric positive-definite C."""
    if type(query) not in (list, tuple) or not 1 <= len(query) <= 8:
        raise ValueError('query must have one to eight features')
    dimension = len(query)
    q = np.array(vector(query, dimension, 16), dtype=np.float64)
    if type(candidates) not in (list, tuple) or not 1 <= len(candidates) <= 64:
        raise ValueError('one to sixty-four candidate rows required')
    x = np.array([vector(row, dimension, 16) for row in candidates], dtype=np.float64)
    if type(covariance) not in (list, tuple) or len(covariance) != dimension:
        raise ValueError('covariance must be square in the same feature space')
    c = np.array([vector(row, dimension, 64) for row in covariance], dtype=np.float64)
    if not np.array_equal(c, c.T):
        raise ValueError('whole converted covariance must be exactly symmetric')
    # Do not silently symmetrize, add diagonal jitter, or use a pseudoinverse.
    factor = np.linalg.cholesky(c, upper=False)
    with np.errstate(over='raise', invalid='raise', divide='raise'):
        # Columns are candidate deltas. Solve L z = delta; no explicit inverse.
        whitened = np.linalg.solve(factor, (x - q).T)
        result = np.sum(whitened * whitened, axis=0)
    if not np.isfinite(result).all() or np.any(result < 0):
        raise ArithmeticError('nonfinite or negative computed squared distance')
    return tuple(float(value) for value in result)


def quadratic_2d_oracle(row, query, covariance):
    """Trusted2D fixture only: direct rational quadratic form, no factor/solve."""
    a, b = map(Fraction, covariance[0])
    b2, c = map(Fraction, covariance[1])
    assert b == b2 and a > 0 and a * c > b * b
    dx, dy = (Fraction(x) - Fraction(q) for x, q in zip(row, query, strict=True))
    return (c * dx * dx - 2 * b * dx * dy + a * dy * dy) / (a * c - b * b)


def refuses(call):
    try:
        call()
    except (ValueError, ArithmeticError, np.linalg.LinAlgError):
        return True
    return False


def main():
    c = ((4, 3), (3, 4))
    query = (0, 0)
    candidates = ((2, 2), (1, -1))
    actual = squared_distances(candidates, query, c)
    exact = tuple(quadratic_2d_oracle(row, query, c) for row in candidates)
    euclidean = tuple(sum((x - q) ** 2 for x, q in zip(row, query, strict=True)) for row in candidates)
    close = lambda x, y: math.isclose(x, float(y), rel_tol=2e-12, abs_tol=2e-12)
    checks = {}
    def check(label, condition):
        checks[label] = bool(condition)
        assert checks[label], label
    check('literal_covariance_geometry_reverses_euclidean_neighbor_order',
          exact == (Fraction(8, 7), Fraction(2)) and all(close(x, y) for x, y in zip(actual, exact, strict=True))
          and euclidean == (8, 2) and actual[0] < actual[1])
    # Deliberately wrong quadratic form: supplying C where a VI API needs C^-1.
    wrong_vi = tuple(sum(row[i] * c[i][j] * row[j] for i in range(2) for j in range(2)) for row in candidates)
    check('covariance_is_not_the_precision_argument', wrong_vi == (56, 2) and wrong_vi[0] > wrong_vi[1])
    points = tuple(product(range(-2, 3), repeat=2))
    cases = 0
    matrices = 0
    largest_error = 0.0
    for a, b, d in product((1, 2, 4), (-1, 0, 1), (1, 2, 4)):
        if a * d <= b * b:
            continue
        covariance = ((a, b), (b, d))
        matrices += 1
        for q in product((-1, 0, 1), repeat=2):
            got = squared_distances(points, q, covariance)
            for row, value in zip(points, got, strict=True):
                reference = quadratic_2d_oracle(row, q, covariance)
                assert close(value, reference)
                largest_error = max(largest_error, abs(value - float(reference)))
                cases += 1
    check('independent_exact_quadratic_grid_is_ONE_family', matrices == 25 and cases == 5625)
    shifted = tuple(tuple(x + 3 for x in row) for row in candidates)
    check('common_translation_preserves_fixed_covariance_distances',
          all(close(x, y) for x, y in zip(squared_distances(shifted, (3, 3), c), actual, strict=True)))
    scale = (2, -0.5)
    transformed = tuple(tuple(x * s for x, s in zip(row, scale, strict=True)) for row in candidates)
    transformed_c = tuple(tuple(c[i][j] * scale[i] * scale[j] for j in range(2)) for i in range(2))
    check('feature_units_and_covariance_must_transform_together',
          all(close(x, y) for x, y in zip(squared_distances(transformed, query, transformed_c), actual, strict=True)))
    wrong_scale = squared_distances(transformed, query, c)
    check('changing_features_without_covariance_is_a_different_geometry',
          any(not close(x, y) for x, y in zip(wrong_scale, actual, strict=True)))
    swapped = tuple(tuple(reversed(row)) for row in candidates)
    asymmetric_scale_c = ((4, 2), (2, 9))
    permuted_c = ((9, 2), (2, 4))
    check('coordinate_permutation_requires_both_covariance_axes',
          all(close(x, y) for x, y in zip(squared_distances(candidates, query, asymmetric_scale_c),
                                        squared_distances(swapped, query, permuted_c), strict=True)))
    check('zero_distance_symmetry_and_nonnegative_values',
          squared_distances((query,), query, c) == (0.0,)
          and close(squared_distances(((2, 1),), (-1, 0), c)[0], squared_distances(((-1, 0),), (2, 1), c)[0])
          and all(x >= 0 for x in actual))
    batch = squared_distances(points, (1, -1), c)
    check('batch_columns_keep_candidate_order_without_a_feature_axis_mixup',
          all(close(value, quadratic_2d_oracle(row, (1, -1), c)) for row, value in zip(points, batch, strict=True))
          and squared_distances(tuple(reversed(points)), (1, -1), c) == tuple(reversed(batch)))
    check('identity_and_diagonal_covariances_have_independent_known_forms',
          squared_distances(candidates, query, ((1, 0), (0, 1))) == (8.0, 2.0)
          and all(close(x, y) for x, y in zip(squared_distances(candidates, query, ((4, 0), (0, 9))),
                                                 (Fraction(13, 9), Fraction(13, 36)), strict=True)))
    check('covariance_global_scale_changes_squared_distance_reciprocally',
          all(close(x, y / 4) for x, y in zip(squared_distances(candidates, query, ((16, 12), (12, 16))), actual, strict=True)))
    invalid_covariances = (((1, 1), (1, 1)), ((1, 2), (2, 1)), ((0, 0), (0, 0)),
                           ((4, 999), (3, 4)), ((4, math.nan), (3, 4)), ((4, True), (3, 4)))
    check('singular_indefinite_asymmetric_and_nonfinite_covariances_refused',
          all(refuses(lambda value=value: squared_distances(candidates, query, value)) for value in invalid_covariances))
    invalid_calls = [((), query, c), (candidates, (), c), (candidates, (0,), c),
                     (((1,),), query, c), (((True, 0),), query, c), (((math.inf, 0),), query, c),
                     (((17, 0),), query, c), (((10 ** 1000, 0),), query, c),
                     (((1, 0),), query, ((65, 0), (0, 4))), (np.array(candidates), query, c)]
    check('shape_exact_type_and_declared_bounds_are_not_silently_coerced',
          all(refuses(lambda values=values: squared_distances(*values)) for values in invalid_calls))
    broad = tuple(tuple(1 if i == j else 0 for j in range(8)) for i in range(8))
    rows = tuple((1,) * 8 for _ in range(64))
    original_c = [list(row) for row in c]
    original_x = [list(row) for row in candidates]
    squared_distances(original_x, list(query), original_c)
    check('one_feature_eight_features_sixty_four_rows_and_inputs_preserved',
          squared_distances(((2,),), (0,), ((4,),)) == (1.0,)
          and squared_distances(rows, (0,) * 8, broad) == (8.0,) * 64
          and original_c == [list(row) for row in c] and original_x == [list(row) for row in candidates])
    return {'python': platform.python_version(), 'numpy': np.__version__, 'scipy_executed': False,
            'feature_units': 'dimensionless supplied synthetic document features', 'distance_units': 'dimensionless',
            'supplied_covariance': c, 'query': query, 'candidate_ids_in_order': ('doc-a', 'doc-b'),
            'candidates': candidates, 'squared_euclidean': euclidean,
            'squared_mahalanobis': actual, 'exact_2d_reference': tuple(str(x) for x in exact),
            'mahalanobis_distances': tuple(math.sqrt(x) for x in actual),
            'wrong_C_used_as_VI_quadratic_values': wrong_vi,
            'ranking_by_computed_squared_distance': tuple(sorted(range(2), key=lambda i: (actual[i], i))),
            'reference_matrices_in_ONE_family': matrices, 'reference_cases_in_ONE_family': cases,
            'maximum_reference_absolute_difference': largest_error, 'relative_and_absolute_tolerance': 2e-12,
            'transformed_covariance': transformed_c, 'features_rescaled_but_C_frozen': wrong_scale,
            'actual_covariance_fits': 0, 'checks': checks, 'unique_check_groups': len(checks),
            'limits': 'Supplied SPD covariance only. Float64 arithmetic, no certified accuracy or exact near-tie ordering. No covariance estimation, learned embeddings, statistical anomaly threshold, relevance judgment, timing or deployment claim.'}


if __name__ == '__main__':
    print(json.dumps(main(), ensure_ascii=False, indent=2, allow_nan=False))
مرجعِ مستقل فقط برای شاهدهای دوبعدی است. با Fraction، صورتِ مستقیمِ فرمِ درجهدو را از درایههای دو در دو میسازد؛ نه Cholesky و نه solve مسیرِ اصلی را فراخوانی نمیکند. این فرمولِ کوچک ابزارِ آزمون است و توصیهٔ ساختنِ وارونِ صریح برای سامانهٔ عمومی نیست. در ۲۵ مرجعِ مثبتمعین و ۵۶۲۵ مقایسهٔ شبکهای، همهٔ موردها یک خانوادهٔ بررسی محسوب میشوند.
مقایسه با مرجع، تلورانسِ نسبی و مطلقِ دو ضربدر دهبهتوانِ منفیِ دوازده دارد. این مقدار، تضمینِ خطای همهٔ ورودیها یا آستانهٔ ارتباطِ سند نیست. جابهجاییِ مشترکِ مبدأ، تغییرِ سازگارِ مقیاس و کوواریانس، جایگشتِ ستونها، تفاوتِ فاصلهٔ صفر و ورودیِ نامعتبر و مرزِ ابعاد نیز جدا سنجیده میشوند. ترتیبِ سندها در خروجی حفظ میشود؛ مرتبسازیِ نمایشی از فاصلهٔ محاسبهشده و سپس شمارهٔ سطر استفاده میکند.
{
  "python": "3.14.5",
  "numpy": "2.5.4",
  "scipy_executed": false,
  "feature_units": "dimensionless supplied synthetic document features",
  "distance_units": "dimensionless",
  "supplied_covariance": [
    [
      4,
      3
    ],
    [
      3,
      4
    ]
  ],
  "query": [
    0,
    0
  ],
  "candidate_ids_in_order": [
    "doc-a",
    "doc-b"
  ],
  "candidates": [
    [
      2,
      2
    ],
    [
      1,
      -1
    ]
  ],
  "squared_euclidean": [
    8,
    2
  ],
  "squared_mahalanobis": [
    1.1428571428571428,
    1.9999999999999996
  ],
  "exact_2d_reference": [
    "8/7",
    "2"
  ],
  "mahalanobis_distances": [
    1.0690449676496976,
    1.414213562373095
  ],
  "wrong_C_used_as_VI_quadratic_values": [
    56,
    2
  ],
  "ranking_by_computed_squared_distance": [
    0,
    1
  ],
  "reference_matrices_in_ONE_family": 25,
  "reference_cases_in_ONE_family": 5625,
  "maximum_reference_absolute_difference": 7.105427357601002e-15,
  "relative_and_absolute_tolerance": 2e-12,
  "transformed_covariance": [
    [
      16,
      -3.0
    ],
    [
      -3.0,
      1.0
    ]
  ],
  "features_rescaled_but_C_frozen": [
    13.14285714285714,
    1.5714285714285712
  ],
  "actual_covariance_fits": 0,
  "checks": {
    "literal_covariance_geometry_reverses_euclidean_neighbor_order": true,
    "covariance_is_not_the_precision_argument": true,
    "independent_exact_quadratic_grid_is_ONE_family": true,
    "common_translation_preserves_fixed_covariance_distances": true,
    "feature_units_and_covariance_must_transform_together": true,
    "changing_features_without_covariance_is_a_different_geometry": true,
    "coordinate_permutation_requires_both_covariance_axes": true,
    "zero_distance_symmetry_and_nonnegative_values": true,
    "batch_columns_keep_candidate_order_without_a_feature_axis_mixup": true,
    "identity_and_diagonal_covariances_have_independent_known_forms": true,
    "covariance_global_scale_changes_squared_distance_reciprocally": true,
    "singular_indefinite_asymmetric_and_nonfinite_covariances_refused": true,
    "shape_exact_type_and_declared_bounds_are_not_silently_coerced": true,
    "one_feature_eight_features_sixty_four_rows_and_inputs_preserved": true
  },
  "unique_check_groups": 14,
  "limits": "Supplied SPD covariance only. Float64 arithmetic, no certified accuracy or exact near-tie ordering. No covariance estimation, learned embeddings, statistical anomaly threshold, relevance judgment, timing or deployment claim."
}
نسخهٔ اجرای واقعی در خروجی ثبت میشود؛ محیطِ آمادهشده Python 3.14.5 و NumPy 2.5.4 دارد. مستنداتِ خواندهشده NumPy 2.5 و SciPy 1.18.0 هستند؛ SciPy اجرا نمیشود. هیچ برازشِ کوواریانس، افزودنِ نویز، دادهٔ خصوصی، زمانسنجی یا آزمونِ محصول نداریم. منابع در ۲۸ مهر ۱۴۰۵ خوانده شدهاند؛ تاریخِ انتشارِ اولیهٔ این صفحههای زنده معلوم نیست و متن خبرِ تازه نیست.
۵. چهار پرسش دربارهٔ مقیاس و مرزِ تفسیر
پرسش اول: آیا بردارِ صفر را مانندِ کسینوس رد کنیم؟ پاسخ: خیر؛ در این فاصله، بردارِ صفر جهتِ واحد لازم ندارد. اگر سند و پرسوجو یکسان باشند، اختلاف و فاصله صفر میشود، به شرطِ معتبر بودنِ مرجع. این مشاهده، درست بودنِ معنای سند یا کامل بودنِ ویژگیها را تضمین نمیکند.
پرسش دوم: اگر فقط ستونِ اول را دو برابر کنیم چه باید تغییر کند؟ پاسخ: با همان تبدیل در سند و پرسوجو، واریانسِ اول چهار برابر و کوواریانسِ مشترک دو برابر میشود؛ واریانسِ دوم ثابت میماند. مرجعِ شاهد سطرهای ۱۶ و شش، سپس شش و چهار میگیرد. با این تبدیلِ سازگار، فاصلهٔ ریاضی حفظ میشود؛ تغییرِ تنها ویژگیها و ثابت گذاشتنِ مرجع، مسئلهٔ دیگری است.
پرسش سوم: اگر مرجع تکین باشد، عددی کوچک به قطر اضافه کنیم؟ پاسخ: این برنامه چنین نمیکند و شکستِ عاملگیری را حفظ میکند. کوواریانسِ مثبتنیمهمعین میتواند مدلِ معتبری باشد، اما وارونِ معمولِ موردنیازِ این قرارداد را نداشته باشد. منظمسازی یا شبهوارون، انتخابِ مدل و فاصلهٔ دیگری است و باید جدا توجیه شود؛ خطا مجوزِ اصلاحِ خاموش نیست.
پرسش چهارم: انتخابِ سندِ نخست، پیشرفتِ جستوجوی معنایی را ثابت میکند؟ پاسخ: خیر؛ اینجا فقط محاسبهٔ هندسی با مرجعِ دادهشده بررسی شده است. برچسبِ انسانیِ ارتباط و دادهٔ آزمون نداریم. درسِ ارزیابیِ رتبهبندی مسئولیتِ مستقلِ قضاوت و معیار را توضیح میدهد. برازشِ مرجع، جلوگیری از نشتِ داده و انتخابِ ویژگی نیز باید در طرحِ واقعی تعریف شوند؛ فاصله بهتنهایی تشخیصِ ناهنجاری، آستانهٔ آماری یا تضمینِ ایمنی نیست.
منابع و مطالعهٔ بیشتر
- SciPy1.18.0؛ تعریفِ فاصله و آرگومانِ وارونِ کوواریانس
- NumPy2.5؛ عاملگیری Cholesky و پیششرطهای ورودی
- NumPy2.5؛ حلِ دستگاهِ مربعی با سمتِ راستِ ماتریسی
بررسی منابع: ۲۸ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.