فهرست مقاله
برای آمادهسازی دانش، بعضی کارها به خروجی کارهای قبلی وابستهاند: نمیتوان پیش از خواندن متن، آن را قطعهبندی کرد. فهرست نامِ مراحل، این وابستگی را نشان نمیدهد. این درس یک برنامهٔ ترتیبدهیِ ایستا برای کارهای کاملاً ساختگی میسازد و نشان میدهد چرخه چگونه پیشروی را متوقف میکند. هیچ فایل، مدل یا نمایهای واقعاً پردازش و فعال نمیشود.
۱. کار و پیشنیاز را با جهت روشن تعریف کنیم
ورودی، نگاشت نام هر کار به فهرست پیشنیازهای آن است. برای مثال، parse به fetch وابسته است؛ جهت یال از fetch به parse میرود. نامهای انگلیسی فقط شناسهٔ نمونهاند. قرارداد ما حداکثر سیودو کار با نام رشتهایِ ناتهی و حداکثر هشت مدخل پیشنیاز برای هر کار دارد. پیشنیاز ناشناخته خطا میدهد و کار پنهانی ساخته نمیشود.
مستندات graphlib پایتون قرارداد گراف پیشنیاز و مفهوم ترتیب توپولوژیک را توضیح میدهد: هر پیشنیاز باید قبل از کار وابسته بیاید. برنامهٔ ما TopologicalSorter را اجرا نمیکند و سیاست ورودیِ خودش را دارد. بهویژه، پذیرش خودکار نامِ پیشنیازِ تعریفنشده را از یک API دیگر به این نمونه منتقل نمیکنیم.
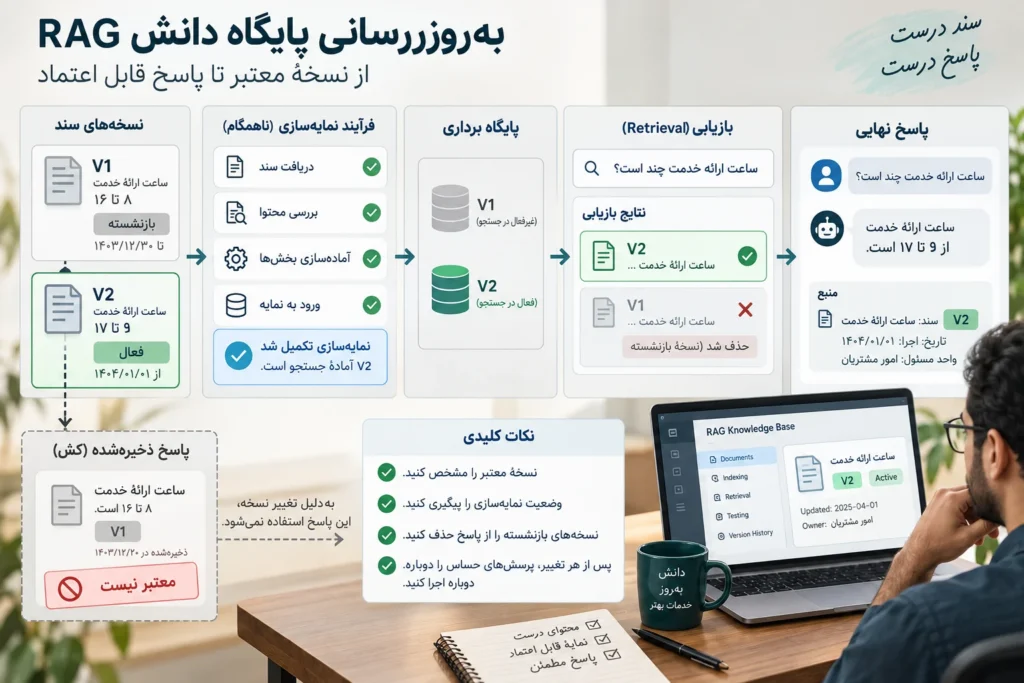
در چرخهٔ بهروزرسانی پایگاه دانش، دریافت و آمادهشدن نمایه دو مرحلهٔ متفاوتاند. اینجا فقط وابستگی میان مرحلههای فرضی را حساب میکنیم. نوشتن نام publish در ترتیب، اعلام انتشار واقعی نیست؛ همانطور که آمدن embed به معنی ساختهشدن یک بردار یا اجرای مدل نیست.
۲. مرحلهٔ آماده را با یک قاعدهٔ قطعی انتخاب کنیم
در نمونهٔ اصلی هشت کار داریم. fetch و health پیشنیاز ندارند؛ parse منتظر fetch است؛ split به parse، embed به split و index به embed وابستهاند. audit نیز پس از parse قرار میگیرد. در پایان، publish هر دو خروجیِ audit و index را لازم دارد. این وابستگیها را نویسنده برای آموزش ساخته است، نه برای توصیف یک محصول عملیاتی.
الگوریتم ابتدا تعداد پیشنیازهای باقیماندهٔ هر کار را میشمارد. کارهای با تعداد صفر آمادهاند. از میان آمادهها، کوچکترین نام در ترتیب رشتهای پایتون انتخاب میشود؛ سپس شمارندهٔ وابستههای مستقیمش کم میشود. این نسخهای از روش Kahn است که صف اولویت heap را برای تکرارپذیری به کار میبرد؛ اولویت نام، اولویت کسبوکار یا زمان اجرا نیست.
در آغاز fetch و health آمادهاند و fetch انتخاب میشود. اکنون health و parse آمادهاند؛ health جلوتر میآید. پس از parse، میان audit و split، نخست audit قرار میگیرد. ترتیب کامل برابر fetch، health، parse، audit، split، embed، index و publish است. مرتبکردن همهٔ نامها از ابتدا همین پاسخ را نمیدهد، چون بعضی نامهای کوچکتر هنوز پیشنیازِ آماده ندارند.
وجود کارهای مستقل باعث میشود پاسخ معتبر لزوماً یکتا نباشد. مثلاً health میتواند پیش از fetch قرار بگیرد و محدودیت هیچ یالی نقض نشود. قاعدهٔ ناممحور فقط یک پاسخِ قابلتکرار انتخاب میکند؛ کمترین زمان پایان، بهترین مصرف منابع یا اجرای موازیِ بهینه را محاسبه نمیکند.
۳. کارِ متوقفشده الزاماً عضو چرخه نیست
برای نمونهٔ خطا، گراف کوچکترِ پنجکاریِ fetch، health، parse، index و publish را جدا میسازیم. در این گراف، parse به fetch و index وابسته است و index به parse؛ publish هم منتظر index میماند. fetch و health هنوز قابلترتیباند، اما پس از آن هیچ کار آمادهای نداریم. فهرست blocked شامل index، parse و publish میشود؛ این فهرست، نام همهٔ کارهایی است که از ترتیب بیرون ماندهاند.
شاهد چرخه، index، parse و دوباره index است؛ هر دو یال در ورودی وجود دارند. publish در این مثال فقط پاییندستِ چرخه است و یالی برای بازگشت به آن دو ندارد. بنابراین برچسبزدن «عضو چرخه» به تمام blockedها، تشخیص نادرستی میدهد. حذف تصادفی وابستگی publish نیز مشکل میان parse و index را برطرف نمیکند.
راهنمای مرتبسازی توپولوژیک NetworkX وجود ترتیب کامل را به گراف جهتدارِ بدون چرخه محدود میکند. کد ما پس از توقف، با پیمایش عمقاول یک مسیر بستهٔ واقعی گزارش میکند. فقط یک شاهد میدهد؛ همهٔ چرخهها یا همهٔ اعضای مؤلفههای قویاً متصل را استخراج نمیکند. نبودن یک کار در همین شاهد، بهتنهایی ثابت نمیکند که آن کار در چرخهٔ دیگری نیست.
۴. کد کامل و مرجع مستقلِ جایگشتها را اجرا کنیم
فایل ingestion_dependency_dag.py با Python 3.14.5 و کتابخانهٔ استاندارد اجرا شده است. پیشنیاز تکراری در شمارش یال دوباره حساب نمیشود. ترتیب ورود کلیدها یا جابهجایی فهرست پیشنیازها نباید خروجی را عوض کند. ردِ انتخابها نیز آمادههای همان گام را نگه میدارد تا علت تقدم هر نام قابل بررسی باشد.
"""Bounded synthetic dependency ordering, never an executing workflow engine."""
import heapq
from itertools import permutations, product
import json
import platform


def valid_name(name):
    return type(name) is str and 1 <= len(name) <= 24 and not any(c.isspace() for c in name)


def dependency_plan(predecessors):
    if type(predecessors) is not dict or len(predecessors) > 32:
        raise ValueError('graph')
    if any(not valid_name(name) for name in predecessors):
        raise ValueError('node_name')
    nodes = sorted(predecessors)
    prerequisites = {}
    for node in nodes:
        items = predecessors[node]
        if type(items) is not list or len(items) > 8:
            raise ValueError('predecessors')
        if any(not valid_name(item) for item in items):
            raise ValueError('node_name')
        if any(item not in predecessors for item in items):
            raise ValueError('unknown_predecessor')
        prerequisites[node] = set(items)
    successors = {node: [] for node in nodes}
    for node in nodes:
        for source in sorted(prerequisites[node]):
            successors[source].append(node)
    remaining = {node: len(prerequisites[node]) for node in nodes}
    ready = [node for node in nodes if remaining[node] == 0]
    heapq.heapify(ready)
    order, choices = [], []
    while ready:
        candidates = sorted(ready)
        node = heapq.heappop(ready)
        choices.append({'ready': candidates, 'selected': node})
        order.append(node)
        for target in successors[node]:
            remaining[target] -= 1
            if remaining[target] == 0:
                heapq.heappush(ready, target)
    blocked = [node for node in nodes if remaining[node] != 0]
    color, stack, stack_index = {}, [], {}
    def witness(node):
        color[node] = 1
        stack_index[node] = len(stack)
        stack.append(node)
        for target in successors[node]:
            if target not in blocked:
                continue
            if color.get(target, 0) == 1:
                return stack[stack_index[target]:] + [target]
            if color.get(target, 0) == 0:
                found = witness(target)
                if found:
                    return found
        stack.pop(); del stack_index[node]
        color[node] = 2
        return None
    cycle = None
    for node in blocked:
        if color.get(node, 0) == 0:
            cycle = witness(node)
            if cycle:
                break
    return {'order': order, 'complete': not blocked, 'blocked': blocked,
            'one_cycle_witness': cycle, 'ready_choices': choices}


def permutation_oracle(predecessors):
    """Independent all whole-node permutations, no in-degree/ready queue."""
    valid = []
    for order in permutations(sorted(predecessors)):
        position = {node: i for i, node in enumerate(order)}
        if all(position[source] < position[node]
               for node, sources in predecessors.items() for source in sources):
            valid.append(order)
    return list(min(valid)) if valid else None


def cycle_edges_valid(graph, cycle):
    return bool(cycle) and len(cycle) >= 2 and cycle[0] == cycle[-1] and all(
        source in graph[target] for source, target in zip(cycle, cycle[1:]))


def rejects(call, message):
    try:
        call()
    except ValueError as error:
        return str(error) == message
    return False


def run_example():
    graph = {'fetch': [], 'parse': ['fetch'], 'split': ['parse'], 'embed': ['split'],
             'index': ['embed'], 'audit': ['parse'], 'publish': ['audit', 'index'], 'health': []}
    untouched = {key: value[:] for key, value in graph.items()}
    good = dependency_plan(graph)
    cycle_graph = {'fetch': [], 'parse': ['fetch', 'index'], 'index': ['parse'],
                   'publish': ['index'], 'health': []}
    bad = dependency_plan(cycle_graph)
    one = dependency_plan({'A': ['A']})
    duplicate = {'A': [], 'B': ['A', 'A']}
    unknown = {'A': ['B']}
    max_nodes = {f'N{i:02}': [] for i in range(32)}
    eight = {str(i): [] for i in range(8)}; eight['target'] = list(eight)
    nine = {str(i): [] for i in range(9)}; nine['target'] = list(nine)
    positions = {node: i for i, node in enumerate(good['order'])}
    cases, oracle_ok = 0, True
    for nodes, possible_edges in [(['A', 'B', 'C'], [(a, b) for a in 'ABC' for b in 'ABC' if a != b]),
                                  (list('ABCD'), [(a, b) for a in 'ABCD' for b in 'ABCD' if a < b])]:
        for present in product((False, True), repeat=len(possible_edges)):
            fixture = {node: [] for node in nodes}
            for (source, target), include in zip(possible_edges, present):
                if include: fixture[target].append(source)
            actual, reference = dependency_plan(fixture), permutation_oracle(fixture)
            if reference is not None:
                oracle_ok &= actual['complete'] and actual['order'] == reference and actual['one_cycle_witness'] is None
            else:
                oracle_ok &= not actual['complete'] and cycle_edges_valid(fixture, actual['one_cycle_witness'])
                emitted = set()
                for node in actual['order']:
                    oracle_ok &= set(fixture[node]) <= emitted
                    emitted.add(node)
                oracle_ok &= set(actual['blocked']) == set(nodes) - emitted
            cases += 1
    altered = dependency_plan(graph); altered['order'].clear(); altered['ready_choices'][0]['ready'].append('fake')
    checks = {
        'hand_dag_lexicographic_ready_order': good['order'] == ['fetch', 'health', 'parse', 'audit', 'split', 'embed', 'index', 'publish'] and good['complete'],
        'every_prerequisite_precedes_dependent': all(positions[source] < positions[node] for node, sources in graph.items() for source in sources),
        'ready_choices_are_not_global_name_sort': good['ready_choices'][:2] == [{'ready': ['fetch', 'health'], 'selected': 'fetch'}, {'ready': ['health', 'parse'], 'selected': 'health'}],
        'cycle_graph_keeps_independent_prefix': bad['order'] == ['fetch', 'health'] and not bad['complete'],
        'cycle_graph_reports_all_blocked_jobs': bad['blocked'] == ['index', 'parse', 'publish'],
        'reported_witness_has_real_closed_directed_edges': bad['one_cycle_witness'] == ['index', 'parse', 'index'] and cycle_edges_valid(cycle_graph, bad['one_cycle_witness']),
        'downstream_blocked_job_not_mislabeled_cycle_member': 'publish' in bad['blocked'] and 'publish' not in bad['one_cycle_witness'],
        'self_loop_is_a_cycle': one['order'] == [] and one['one_cycle_witness'] == ['A', 'A'],
        'empty_graph_is_complete_empty_plan': dependency_plan({}) == {'order': [], 'complete': True, 'blocked': [], 'one_cycle_witness': None, 'ready_choices': []},
        'isolated_jobs_have_deterministic_name_order': dependency_plan({'C': [], 'A': [], 'B': []})['order'] == ['A', 'B', 'C'],
        'duplicate_prerequisites_do_not_add_phantom_edges': dependency_plan(duplicate) == dependency_plan({'A': [], 'B': ['A']}),
        'mapping_and_predecessor_order_do_not_change_output': dependency_plan({key: list(reversed(value)) for key, value in reversed(list(graph.items()))}) == good,
        'unknown_predecessor_rejects_without_implicit_job': rejects(lambda: dependency_plan(unknown), 'unknown_predecessor') and unknown == {'A': ['B']},
        'node_names_are_strict_and_bounded': all(rejects(lambda value=value: dependency_plan({value: []}), 'node_name') for value in [True, 1, '', 'two words', 'x' * 25]),
        'mapping_and_predecessor_collection_shape_reject': rejects(lambda: dependency_plan([]), 'graph') and rejects(lambda: dependency_plan({'A': ()}), 'predecessors') and rejects(lambda: dependency_plan({'A': [True]}), 'node_name'),
        'node_and_predecessor_caps_are_explicit': len(dependency_plan(max_nodes)['order']) == 32 and rejects(lambda: dependency_plan({**max_nodes, 'extra': []}), 'graph') and dependency_plan(eight)['complete'] and rejects(lambda: dependency_plan(nine), 'predecessors'),
        'input_and_fresh_result_are_independent': graph == untouched and dependency_plan(graph) == good,
        'independent_whole_permutation_oracle': cases == 128 and bool(oracle_ok),
    }
    assert len(checks) == 18 and all(type(value) is bool and value for value in checks.values()), checks
    return {'python': platform.python_version(), 'dependencies': 'Python standard library only',
            'scope': 'Static bounded synthetic prerequisite plan only; no task execution, workflow durability, deployment or all-cycle enumeration',
            'results': {'acyclic_predecessors': graph, 'acyclic_plan': good,
                        'cyclic_predecessors': cycle_graph, 'cyclic_plan': bad,
                        'oracle_graphs_inside_one_group': cases,
                        'limits': {'max_nodes': 32, 'max_predecessor_entries_per_node': 8,
                                   'reported_cycles': 'one witness only, not all SCCs/cycle members'}}, 'checks': checks}


if __name__ == '__main__':
    print(json.dumps(run_example(), ensure_ascii=False, indent=2))
مرجع مستقل برای گرافهای حداکثر چهارگرهی، همهٔ جایگشتهای نامها را میسازد و مستقیماً میسنجد هر پیشنیاز جلوتر باشد. سپس کوچکترین ترتیب معتبر را انتخاب میکند؛ صف آماده یا شمارندهٔ ورودیِ الگوریتم اصلی را ندارد. برای گراف چرخهدار، بستهبودن شاهد، وجود یالهایش و معتبرماندن پیشوندِ خروجی با نگاشت اولیه بررسی میشود.
هجده گروه اجرایی شامل پاسخ دستی، چرخه، خودحلقه، کار مستقل، ورودی نامعتبر و کرانها هستند. شصتوچهار گراف جهتدارِ بدون خودحلقهٔ سهگرهی و شصتوچهار گرافِ چهارتایی با یالهای روبهجلو، در یک گروهِ مرجع مقایسه میشوند. این ۱۲۸ گراف، ۱۲۸ گروه تازه نیستند. روش جایگشت برای این نمونههای کوچک انتخاب شده؛ برای سیودو کار، همهٔ جایگشتها را اجرا نمیکنیم.
۵. مرز ترتیبدهی و چهار پرسش پاسخدار را حفظ کنیم
ترتیب درست، اجرای موفق کار را تضمین نمیکند. این کد کارگر، retry، مهلت اجرا، تراکنش، منابع محاسباتی یا رسید تکمیل ندارد. اگر در کاربرد واقعی parse شکست بخورد، صرفِ بودن نام split بعد از آن، اجازهٔ ادامه نیست. همچنین مسئلهٔ سازگاری نسخهٔ نمایه و اسناد جداست؛ ترتیب مرحلهها بهتنهایی یک نسخهٔ سازگار یا انتشار اتمی نمیسازد.
{
  "python": "3.14.5",
  "dependencies": "Python standard library only",
  "scope": "Static bounded synthetic prerequisite plan only; no task execution, workflow durability, deployment or all-cycle enumeration",
  "results": {
    "acyclic_predecessors": {
      "fetch": [],
      "parse": [
        "fetch"
      ],
      "split": [
        "parse"
      ],
      "embed": [
        "split"
      ],
      "index": [
        "embed"
      ],
      "audit": [
        "parse"
      ],
      "publish": [
        "audit",
        "index"
      ],
      "health": []
    },
    "acyclic_plan": {
      "order": [
        "fetch",
        "health",
        "parse",
        "audit",
        "split",
        "embed",
        "index",
        "publish"
      ],
      "complete": true,
      "blocked": [],
      "one_cycle_witness": null,
      "ready_choices": [
        {
          "ready": [
            "fetch",
            "health"
          ],
          "selected": "fetch"
        },
        {
          "ready": [
            "health",
            "parse"
          ],
          "selected": "health"
        },
        {
          "ready": [
            "parse"
          ],
          "selected": "parse"
        },
        {
          "ready": [
            "audit",
            "split"
          ],
          "selected": "audit"
        },
        {
          "ready": [
            "split"
          ],
          "selected": "split"
        },
        {
          "ready": [
            "embed"
          ],
          "selected": "embed"
        },
        {
          "ready": [
            "index"
          ],
          "selected": "index"
        },
        {
          "ready": [
            "publish"
          ],
          "selected": "publish"
        }
      ]
    },
    "cyclic_predecessors": {
      "fetch": [],
      "parse": [
        "fetch",
        "index"
      ],
      "index": [
        "parse"
      ],
      "publish": [
        "index"
      ],
      "health": []
    },
    "cyclic_plan": {
      "order": [
        "fetch",
        "health"
      ],
      "complete": false,
      "blocked": [
        "index",
        "parse",
        "publish"
      ],
      "one_cycle_witness": [
        "index",
        "parse",
        "index"
      ],
      "ready_choices": [
        {
          "ready": [
            "fetch",
            "health"
          ],
          "selected": "fetch"
        },
        {
          "ready": [
            "health"
          ],
          "selected": "health"
        }
      ]
    },
    "oracle_graphs_inside_one_group": 128,
    "limits": {
      "max_nodes": 32,
      "max_predecessor_entries_per_node": 8,
      "reported_cycles": "one witness only, not all SCCs/cycle members"
    }
  },
  "checks": {
    "hand_dag_lexicographic_ready_order": true,
    "every_prerequisite_precedes_dependent": true,
    "ready_choices_are_not_global_name_sort": true,
    "cycle_graph_keeps_independent_prefix": true,
    "cycle_graph_reports_all_blocked_jobs": true,
    "reported_witness_has_real_closed_directed_edges": true,
    "downstream_blocked_job_not_mislabeled_cycle_member": true,
    "self_loop_is_a_cycle": true,
    "empty_graph_is_complete_empty_plan": true,
    "isolated_jobs_have_deterministic_name_order": true,
    "duplicate_prerequisites_do_not_add_phantom_edges": true,
    "mapping_and_predecessor_order_do_not_change_output": true,
    "unknown_predecessor_rejects_without_implicit_job": true,
    "node_names_are_strict_and_bounded": true,
    "mapping_and_predecessor_collection_shape_reject": true,
    "node_and_predecessor_caps_are_explicit": true,
    "input_and_fresh_result_are_independent": true,
    "independent_whole_permutation_oracle": true
  }
}
پرسش اول: چرا audit پیش از fetch نیامد، با اینکه نام کوچکتری دارد؟ پاسخ: audit منتظر parse و parse منتظر fetch است. ترتیب رشتهای فقط میان کارهای همان لحظهٔ آماده اعمال میشود.
پرسش دوم: آیا publish در حالت خطا عضو چرخه است؟ پاسخ: در همین گراف خیر؛ فقط به index وابسته است. چرخهٔ دستی index و parse است و publish از آن آسیب میبیند، بدون اینکه مسیر بازگشت داشته باشد.
پرسش سوم: با A وابسته به خودش چه میشود؟ پاسخ: هیچ ترتیب کاملی وجود ندارد؛ شاهد A، A گزارش میشود و A آماده نمیشود. خودحلقه، یک وابستگیِ قابلصرفنظرکردن نیست.
پرسش چهارم: آیا خروجی کامل، آمادهبودن دانش زنده را اعلام میکند؟ پاسخ: خیر؛ فقط همین گرافِ ایستا چرخهٔ مسدودکننده ندارد. منابع در ۲۴ مهر ۱۴۰۵ خوانده شدند؛ نسخهٔ صفحات Python 3.14.8 و NetworkX 3.7 جدا از اجرای 3.14.5 ثبت شده است. هیچیک از دو API مرجع اجرا نشده و این مطلب آموزش پایه است.
منابع و مطالعهٔ بیشتر
- Python؛ graphlib و قرارداد گراف پیشنیاز و شاهد چرخه
- NetworkX؛ مرتبسازی توپولوژیک و محدودیت گراف چرخهدار
بررسی منابع: ۲۴ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.