فهرست مقاله
در جستوجوی برداری، ممکن است فاصلهٔ همهٔ نامزدهای دیدهشده درست حساب شود، اما نزدیکترین همسایه اصلاً وارد فهرست نامزدها نشده باشد. این درس با شش بردار ساختگی نشان میدهد چگونه انتخابِ نزدیکترین مرکزِ مسیریابی، یک سند نزدیک را حذف میکند. کد و پاسخ دستی را کنار مرجع جستوجوی کامل میگذاریم؛ مدل معنایی، آموزش شبکه و ارزیابی ارتباط انسانی در کار نیست.
۱. بردارها و مرکزهای مسیریابی را از مدل معنایی جدا کنیم
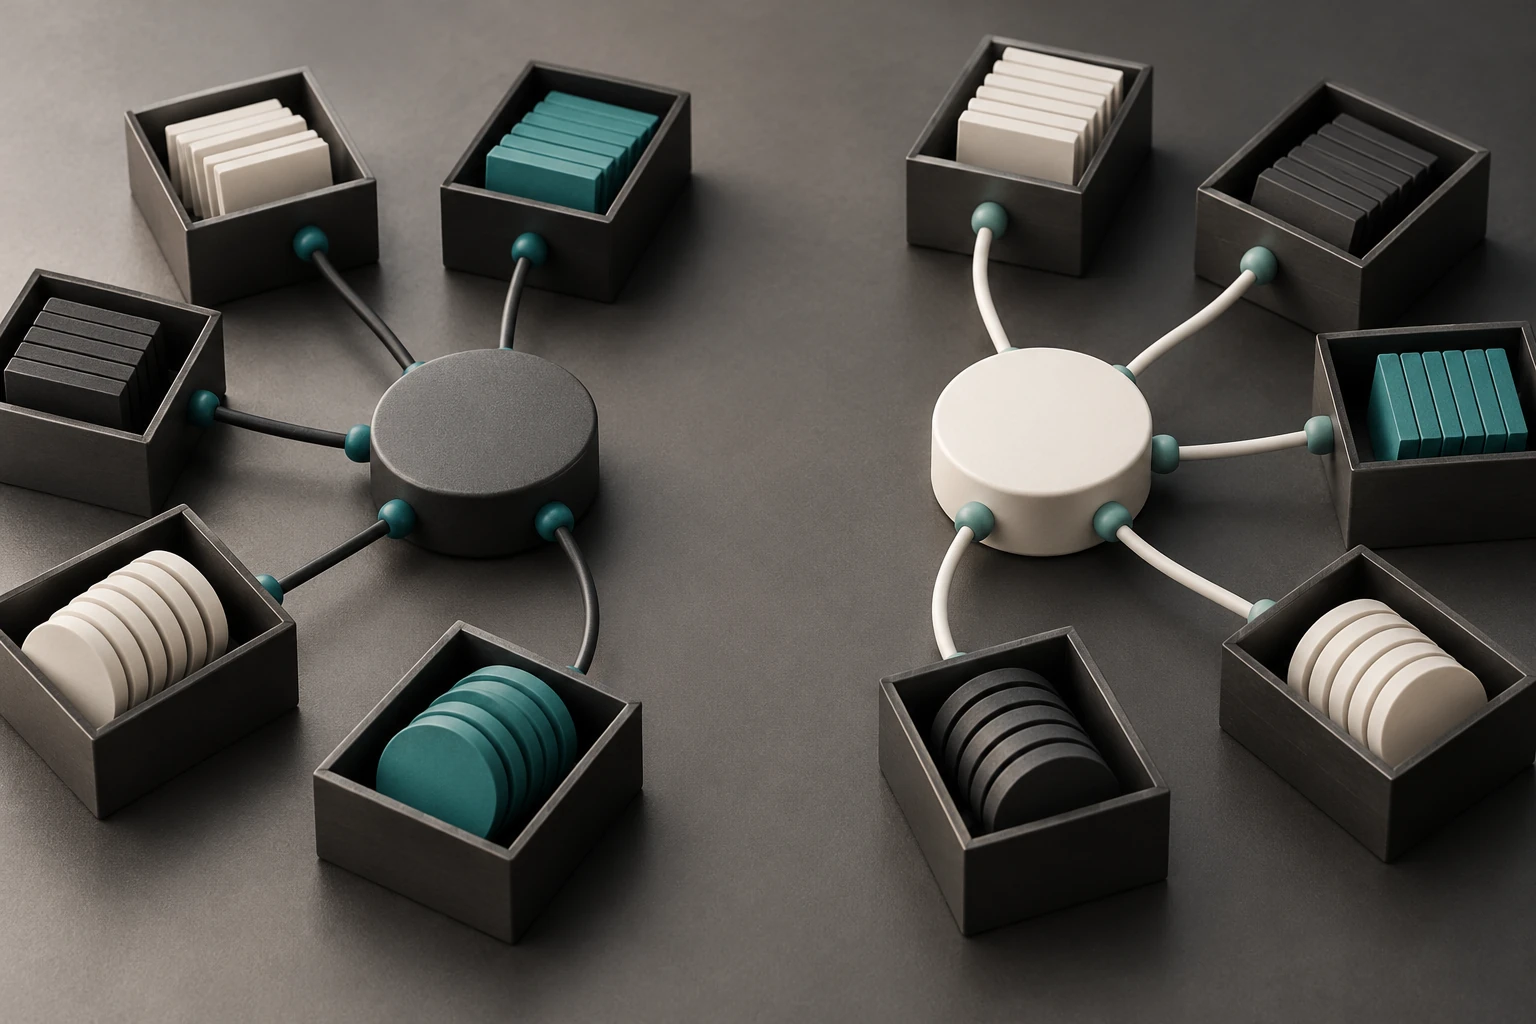
هر سند یک نقطهٔ دوبعدیِ بیواحد است. نامهای A تا F فقط شناسهاند؛ محتوای متنی، زبان و معنای سند را تولید نکردهایم. دو مرکزِ ورودی، صفر و چهار روی محور افقیاند و مؤلفهٔ عمودی هر دو صفر است. این مرکزها لنگرِ مسیریابیِ دادهشده هستند، نه میانگین محاسبهشدهٔ گروهها و نه خروجی آموزش خوشهبندی.
ابتدا هر بردار به مرکزی با کمترین مجموع مربع اختلاف مؤلفهها نسبت داده میشود. فهرست هر سلول شناسهٔ بردارهای آن را نگه میدارد. هنگام پرسوجو، تعدادی مرکز نزدیک انتخاب میشوند و فقط بردارهای سلولهای متناظر نامزد میشوند. بنابراین دو تصمیم داریم: انتخاب نامزد و مرتبکردن فاصلهٔ نامزدهای باقیمانده.
مستند اصلی نمایههای Faiss همین خطرِ حذف سلولِ همسایهٔ واقعی را در توضیح روشهای سلولی مطرح میکند. پیادهسازی حاضر کد آموزشی خودمان با NumPy است؛ Faiss نصب یا اجرا نشده و سازگاری کامل با رابط آن ادعا نمیشود. تنظیم مرکزها، آموزش و ساختار ذخیرهسازیِ کتابخانه هم بازسازی نشدهاند.
۲. نزدیکترین مرکز، نزدیکترین سند را تضمین نمیکند
پرسوجو (1.9,0) است. مربع فاصله تا مرکز صفر، ۳٫۶۱ و تا مرکز چهار، ۴٫۴۱ میشود؛ پس با انتخاب یک سلول، فقط سلول اول دیده میشود. اما سند B=(2.1,0) در سمت مرکز چهار قرار گرفته و مربع فاصلهاش تا پرسوجو فقط ۰٫۰۴ است. نزدیکی دو نقطه به مرز، این حذف را ممکن میکند.
عضوهای سلول اول A,C,F و عضوهای دوم B,D,E هستند. در سلول اول، ترتیب فاصله F,A,C با مربع فاصلههای تقریباً ۱٫۸۱، ۳٫۶۱ و ۴٫۶۱ است. محاسبهٔ این سه درست است، ولی پاسخِ نزدیکترین همسایهٔ کل مجموعه نیست. حتی مرتبسازی بیخطای همین سه نامزد نمیتواند سند غایب را برگرداند.
با دیدن هر دو سلول، سه نتیجهٔ نخست B,E,F با مربع فاصلههای تقریباً ۰٫۰۴، ۱٫۲۱ و ۱٫۸۱ میشوند. از کلمهٔ «تقریباً» استفاده میکنیم چون نمایش شناور، کسرهای دهدهی را همیشه دقیق نگه نمیدارد. فاصلهها احتمال نیستند و ریشه نگرفتن فقط ترتیبِ فاصلهٔ اقلیدسیِ نامنفی را حفظ میکند.
۳. نامزدهای محدود را با جستوجوی کامل مقایسه کنیم
مرجع کامل، تمام شش بردار را با همان فاصله و قاعدهٔ تساوی مرتب میکند. برای سه همسایه، فقط F میان دو پاسخ مشترک است؛ پس بازیابیِ همسایه در این پرسوجو یکسوم است. مخرج، تعداد نتیجهٔ مرجعِ خواستهشده است؛ تعداد نامزدهای موجود یا تعداد اسناد مرتبط انسانی نیست.
اگر شش خروجی بخواهیم ولی فقط سه نامزد داشته باشیم، برنامه همان سه را میدهد و مخرج مرجع شش میماند. انتخاب یک سلولِ خالی نیز فهرست خالی میدهد؛ برنامه بیصدا به جستوجوی کامل برنمیگردد. برای درخواست صفر همسایه، نسبت را تهی برمیگردانیم، چون این نمونه سیاستی برای تقسیم صفر بر صفر تعریف نکرده است.
پارامتر nprobe در این کد تعداد سلولهای بازدیدشده است. افزایش آن تا همهٔ سلولها پاسخ مرجع را برمیگرداند، اما از تعداد سلولها بهتنهایی نمیتوان زمان اجرا را نتیجه گرفت. اندازهٔ سلولها میتواند متفاوت باشد؛ همان مستند Faiss نیز نسبت سادهٔ تعداد سلولهای دیدهشده را تخمینی برای کار میداند. اینجا هیچ زمانسنجی یا شتابِ اندازهگیریشدهای نداریم.
۴. کد و پاسخ دستی را با مرجع اسکالر بسنجیم
فایل coarse_vector_candidates.py با Python 3.14.5 و NumPy 2.4.6 اجرا شده است. آرایهها باید واقعاً float64 باشند؛ تبدیل پنهانیِ رشته، بولی یا آرایهٔ صحیح نداریم. مجموعه یک تا شانزده بردار و یک تا چهار بُعد دارد؛ مرکزها همبُعدند و مقدار مطلق هر مؤلفه حداکثر هزار و متناهی است.
"""Supplied-center candidate pruning; synthetic geometry, not a FAISS run."""
import itertools
import json
import math
import platform
import re

import numpy as np


def _array(value, ndim, name):
    if type(value) is not np.ndarray or value.dtype != np.dtype("float64"):
        raise ValueError(name + " requires an actual float64 ndarray")
    if value.ndim != ndim or not np.isfinite(value).all():
        raise ValueError(name + " shape/finite contract")
    if np.any(np.abs(value) > 1000):
        raise ValueError(name + " coordinates exceed the toy bound")
    return value


def _inputs(ids, vectors, centers, query, k):
    x = _array(vectors, 2, "vectors")
    c = _array(centers, 2, "centers")
    q = _array(query, 1, "query")
    if not (1 <= x.shape[0] <= 16 and 1 <= x.shape[1] <= 4):
        raise ValueError("corpus dimensions")
    if not (1 <= c.shape[0] <= 4 and c.shape[1] == x.shape[1] == q.size):
        raise ValueError("incompatible dimensions")
    if type(ids) not in (list, tuple) or len(ids) != len(x):
        raise ValueError("one identifier per vector")
    if any(type(s) is not str or not re.fullmatch(r"[A-Z][A-Z0-9]{0,7}", s)
           for s in ids) or len(set(ids)) != len(ids):
        raise ValueError("unique bounded ASCII identifiers")
    if type(k) is not int or not 0 <= k <= len(x):
        raise ValueError("k must be an integer in 0..corpus size")
    return x, c, q


def _squared(a, b):
    delta = a - b
    return np.sum(delta * delta, axis=-1, dtype=np.float64)


def _rank(ids, x, q, rows, k):
    if not rows or k == 0:
        return []
    distances = _squared(x[rows], q)
    ordered = sorted(zip(rows, distances), key=lambda z: (float(z[1]), ids[z[0]]))
    return [{"id": ids[i], "distance_squared": float(d)} for i, d in ordered[:k]]


def coarse_search(ids, vectors, centers, query, nprobe, k):
    x, c, q = _inputs(ids, vectors, centers, query, k)
    if type(nprobe) is not int or not 1 <= nprobe <= len(c):
        raise ValueError("nprobe must be an integer in 1..center count")
    # argmin chooses the first center in an exact tie.
    assignment = np.argmin(_squared(x[:, None, :], c[None, :, :]), axis=1)
    center_distances = _squared(c, q)
    probes = sorted(range(len(c)), key=lambda j: (float(center_distances[j]), j))[:nprobe]
    selected = set(probes)
    rows = [i for i, label in enumerate(assignment) if int(label) in selected]
    return {
        "assignment": {s: int(label) for s, label in zip(ids, assignment)},
        "probed_centers": probes,
        "candidate_ids": sorted(ids[i] for i in rows),
        "ranking": _rank(ids, x, q, rows, k),
    }


def full_search(ids, vectors, centers, query, k):
    x, _, q = _inputs(ids, vectors, centers, query, k)
    return _rank(ids, x, q, list(range(len(x))), k)


def neighbor_recall(approximate, exact):
    """Both lists use the same requested k; exact defines the denominator."""
    if not exact:
        return None
    return len({r["id"] for r in approximate} & {r["id"] for r in exact}) / len(exact)


def scalar_reference(ids, vectors, centers, query, nprobe, k):
    """Independent plain loops and fsum, without NumPy reductions/argmin."""
    x, c, q = vectors.tolist(), centers.tolist(), query.tolist()
    def d2(a, b):
        return math.fsum((a[j] - b[j]) ** 2 for j in range(len(q)))
    labels = {s: min(range(len(c)), key=lambda j: (d2(row, c[j]), j))
              for s, row in zip(ids, x)}
    probes = sorted(range(len(c)), key=lambda j: (d2(c[j], q), j))[:nprobe]
    candidates = [s for s in ids if labels[s] in probes]
    scores = {s: d2(row, q) for s, row in zip(ids, x)}
    ranking = sorted(candidates, key=lambda s: (scores[s], s))[:k]
    return {"assignment": labels, "probed_centers": probes,
            "candidate_ids": sorted(candidates),
            "ranking": [{"id": s, "distance_squared": scores[s]} for s in ranking]}


def _rejects(function):
    try:
        function()
    except ValueError:
        return True
    return False


def run_example():
    ids = ["A", "B", "C", "D", "E", "F"]
    x = np.array([[0, 0], [2.1, 0], [0, 1], [4, 1], [3, 0], [1, 1]], dtype=np.float64)
    centers = np.array([[0, 0], [4, 0]], dtype=np.float64)
    query = np.array([1.9, 0], dtype=np.float64)
    def search(nprobe=1, k=3, **kw):
        return coarse_search(kw.get("ids", ids), kw.get("x", x), kw.get("c", centers),
                             kw.get("q", query), nprobe, k)
    def names(rows):
        return [r["id"] for r in rows]
    approximate = search()
    exact = full_search(ids, x, centers, query, 3)
    checks = {}
    checks["hand_cell_membership"] = approximate["assignment"] == {
        "A": 0, "B": 1, "C": 0, "D": 1, "E": 1, "F": 0}
    checks["hand_missed_nearest_and_orders"] = (
        names(exact) == ["B", "E", "F"] and
        names(approximate["ranking"]) == ["F", "A", "C"] and
        math.isclose(exact[0]["distance_squared"], 0.04, abs_tol=1e-14))
    checks["hand_neighbor_recall_one_third"] = neighbor_recall(approximate["ranking"], exact) == 1 / 3
    checks["all_centers_recover_full_reference"] = search(2)["ranking"] == exact
    tied = search(q=np.array([2.0, 0.0], dtype=np.float64))
    tx = np.array([[1, 0], [-1, 0]], dtype=np.float64)
    tc = np.array([[0, 0]], dtype=np.float64)
    tq = np.zeros(2, dtype=np.float64)
    tie_rank = coarse_search(["Z", "A"], tx, tc, tq, 1, 2)["ranking"]
    checks["exact_ties_center_index_and_identifier"] = tied["probed_centers"] == [0] and names(tie_rank) == ["A", "Z"]
    empty = search(c=np.vstack([centers, [100.0, 100.0]]), q=np.array([100.0, 100.0]))
    checks["selected_empty_cell_returns_no_candidates"] = empty["probed_centers"] == [2] and empty["candidate_ids"] == [] and empty["ranking"] == []
    checks["zero_requested_neighbors_undefined_recall"] = search(k=0)["ranking"] == [] and neighbor_recall([], []) is None
    short = search(k=6)
    checks["short_candidate_pool_keeps_full_denominator"] = len(short["ranking"]) == 3 and neighbor_recall(short["ranking"], full_search(ids, x, centers, query, 6)) == 0.5
    zero = search(q=np.zeros(2, dtype=np.float64), k=1)
    checks["zero_vector_is_valid_for_squared_l2"] = zero["ranking"] == [{"id": "A", "distance_squared": 0.0}]
    order = [5, 3, 1, 4, 0, 2]
    permuted = search(ids=[ids[i] for i in order], x=x[order])
    checks["corpus_permutation_preserves_identified_results"] = permuted == approximate
    oracle_cases = 0
    oracle_ok = True
    for a, b, nprobe, k in itertools.product([-1, 0, 1.9, 2, 3, 4, 5], [-1, 0, 1], [1, 2], range(7)):
        q = np.array([a, b], dtype=np.float64)
        got = search(nprobe, k, q=q)
        ref = scalar_reference(ids, x, centers, q, nprobe, k)
        oracle_ok &= all(got[key] == ref[key] for key in ("assignment", "probed_centers", "candidate_ids"))
        oracle_ok &= names(got["ranking"]) == names(ref["ranking"])
        oracle_ok &= all(math.isclose(g["distance_squared"], r["distance_squared"], rel_tol=1e-12, abs_tol=1e-12)
                         for g, r in zip(got["ranking"], ref["ranking"]))
        oracle_cases += 1
    checks["independent_scalar_grid_reference"] = bool(oracle_ok and oracle_cases == 294)
    checks["dtype_contract_rejects_bool_int_float32_and_lists"] = all(_rejects(lambda bad=bad: search(x=bad)) for bad in [x.astype(np.float32), x.astype(np.int64), x.astype(bool), x.tolist()])
    checks["dimensional_contract_rejects_empty_and_mismatch"] = all(_rejects(lambda kw=kw: search(**kw)) for kw in [
        {"x": np.empty((0, 2), dtype=np.float64)}, {"x": np.ones((17, 2), dtype=np.float64)},
        {"x": x.ravel()}, {"c": centers[:, :1]}, {"q": query[None, :]},
        {"c": np.empty((0, 2), dtype=np.float64)}, {"q": np.array([1.0, 2.0, 3.0])}])
    checks["finite_and_coordinate_bound_contract"] = all(_rejects(lambda v=v: search(q=np.array([v, 0.0]))) for v in [float("nan"), float("inf"), -float("inf"), 1000.001]) and not _rejects(lambda: search(q=np.array([1000.0, -1000.0])))
    checks["integer_probe_and_k_bounds"] = all(_rejects(lambda p=p: search(nprobe=p)) for p in [True, 0, 3, 1.0]) and all(_rejects(lambda k=k: search(k=k)) for k in [True, -1, 7, 1.0])
    checks["identifier_count_uniqueness_ascii_contract"] = all(_rejects(lambda bad=bad: search(ids=bad)) for bad in [ids[:-1], ["A"] * 6, ["حسگر"] + ids[1:], [True] + ids[1:]])
    before = (x.copy(), centers.copy(), query.copy(), ids.copy())
    search(2, 6)
    checks["caller_inputs_remain_unchanged"] = all(np.array_equal(old, now) for old, now in zip(before[:3], (x, centers, query))) and before[3] == ids
    assert all(type(v) is bool and v for v in checks.values()), checks
    return {"python": platform.python_version(), "dependencies": {"numpy": np.__version__, "faiss_executed": False},
            "example": {"synthetic_dimensionless_vectors": dict(zip(ids, x.tolist())), "supplied_centers": centers.tolist(), "query": query.tolist(),
                        "nprobe": 1, "k": 3, "coarse_result": approximate, "full_reference": exact,
                        "neighbor_recall_at_3": neighbor_recall(approximate["ranking"], exact),
                        "nprobe_2_ranking": search(2)["ranking"]},
            "oracle_cases_inside_one_group": oracle_cases, "checks": checks,
            "limitations": ["Supplied centers, no model training or FAISS execution", "Squared Euclidean float64 geometry, not human relevance", "Bounded synthetic data; no runtime benchmark"]}


if __name__ == "__main__":
    print(json.dumps(run_example(), ensure_ascii=False, indent=2))
در جمعِ NumPy، محور آخر مشخص شده تا فقط مؤلفههای فاصله جمع شوند. argmin در تساوی دقیق، نخستین کمینه را برمیگرداند؛ پس شمارهٔ کوچکترِ مرکزِ دادهشده برنده است. برای فاصلهٔ مساویِ سندها، شناسهٔ لاتین قاعدهٔ دوم است. مقدارهای فقط نزدیک، مساوی فرض نمیشوند.
هفده گروه بررسی اجرا شدهاند. مرجع مستقل با حلقهٔ اسکالر و جمعِ math.fsum، بدون تابع جمع یا کمینهٔ NumPy، تخصیص و رتبه را دوباره میسازد. ۲۹۴ ترکیبِ پرسوجو، تعداد سلول و تعداد خروجی داخل یک گروه مقایسه میشوند؛ جواب دستی، سلول خالی، ورودی صفر و جابهجایی ترتیب سندها نیز جدا بررسی شدهاند.
تلورانس مقایسهٔ فاصلههای مرجع یکتریلیونیمِ مطلق و نسبی است؛ آستانهٔ ارتباط سند نیست. شناسهها، بُعد، نوع، محدودیت پارامتر و دستنخوردن ورودی هم کنترل میشوند. بردار صفر در فاصلهٔ اقلیدسی مجاز است؛ برخلاف درس کسینوس بردار سند، اینجا تقسیم بر طول و مسئلهٔ جهتِ تعریفنشده نداریم.
۵. recall همسایه را کیفیت معنایی ننامیم
قبولی آزمونها نشان میدهد همین قرارداد هندسیِ محدود طبق پاسخهای مرجع عمل میکند. مشخص نیست ویژگیهای برداری برای نیاز کاربر مفید باشند؛ اصلاً متن یا قضاوت انسانی نداریم. پس یکسوم را نباید درصد پاسخهای درست، کیفیت فارسی یا موفقیت یک موتور جستوجوی واقعی معرفی کرد. پرسوجوهای متعددِ واقعی و برچسب ارتباط مسئولیت جدا دارند.
{
  "python": "3.14.5",
  "dependencies": {
    "numpy": "2.4.6",
    "faiss_executed": false
  },
  "example": {
    "synthetic_dimensionless_vectors": {
      "A": [
        0.0,
        0.0
      ],
      "B": [
        2.1,
        0.0
      ],
      "C": [
        0.0,
        1.0
      ],
      "D": [
        4.0,
        1.0
      ],
      "E": [
        3.0,
        0.0
      ],
      "F": [
        1.0,
        1.0
      ]
    },
    "supplied_centers": [
      [
        0.0,
        0.0
      ],
      [
        4.0,
        0.0
      ]
    ],
    "query": [
      1.9,
      0.0
    ],
    "nprobe": 1,
    "k": 3,
    "coarse_result": {
      "assignment": {
        "A": 0,
        "B": 1,
        "C": 0,
        "D": 1,
        "E": 1,
        "F": 0
      },
      "probed_centers": [
        0
      ],
      "candidate_ids": [
        "A",
        "C",
        "F"
      ],
      "ranking": [
        {
          "id": "F",
          "distance_squared": 1.8099999999999998
        },
        {
          "id": "A",
          "distance_squared": 3.61
        },
        {
          "id": "C",
          "distance_squared": 4.609999999999999
        }
      ]
    },
    "full_reference": [
      {
        "id": "B",
        "distance_squared": 0.04000000000000007
      },
      {
        "id": "E",
        "distance_squared": 1.2100000000000002
      },
      {
        "id": "F",
        "distance_squared": 1.8099999999999998
      }
    ],
    "neighbor_recall_at_3": 0.3333333333333333,
    "nprobe_2_ranking": [
      {
        "id": "B",
        "distance_squared": 0.04000000000000007
      },
      {
        "id": "E",
        "distance_squared": 1.2100000000000002
      },
      {
        "id": "F",
        "distance_squared": 1.8099999999999998
      }
    ]
  },
  "oracle_cases_inside_one_group": 294,
  "checks": {
    "hand_cell_membership": true,
    "hand_missed_nearest_and_orders": true,
    "hand_neighbor_recall_one_third": true,
    "all_centers_recover_full_reference": true,
    "exact_ties_center_index_and_identifier": true,
    "selected_empty_cell_returns_no_candidates": true,
    "zero_requested_neighbors_undefined_recall": true,
    "short_candidate_pool_keeps_full_denominator": true,
    "zero_vector_is_valid_for_squared_l2": true,
    "corpus_permutation_preserves_identified_results": true,
    "independent_scalar_grid_reference": true,
    "dtype_contract_rejects_bool_int_float32_and_lists": true,
    "dimensional_contract_rejects_empty_and_mismatch": true,
    "finite_and_coordinate_bound_contract": true,
    "integer_probe_and_k_bounds": true,
    "identifier_count_uniqueness_ascii_contract": true,
    "caller_inputs_remain_unchanged": true
  },
  "limitations": [
    "Supplied centers, no model training or FAISS execution",
    "Squared Euclidean float64 geometry, not human relevance",
    "Bounded synthetic data; no runtime benchmark"
  ]
}بازرتبهبندی با تنوع MMR نیز روی نامزدهای دادهشده عمل میکند؛ سندی که این مرحله حذف کرده، با تغییر ضریب تنوع ایجاد نمیشود. منابع در ۲۵ مهر ۱۴۰۵ خوانده شدند. تاریخ ویرایش صفحهٔ Faiss، ۲۸ ژوئیهٔ ۲۰۲۵ و نسخهٔ مرجع NumPy، 2.4 است؛ این تاریخها را خبر تازه یا نسخهٔ اجرای Faiss نمینامیم.
پرسش اول: چرا سند نزدیکِ B دیده نشد؟ پاسخ: سلول آن انتخاب نشده بود؛ فاصلهٔ کوچک آن فقط در مرجع کامل محاسبه شد، نه در مجموعهٔ نامزدِ یکسلولی.
پرسش دوم: با دو سلول چه اتفاقی افتاد؟ پاسخ: هر شش بردار نامزد شدند و سه نتیجه با مرجع کامل یکسان شدند؛ این نتیجه برای همین داده و همین معیار است.
پرسش سوم: چرا خروجیِ سهعضویِ درخواست ششتایی، نسبت یک نمیگیرد؟ پاسخ: فقط سه مورد از شش عضو مرجع بازیابی شدهاند؛ کوتاهکردن مخرج، حذف نامزد را پنهان میکند.
پرسش چهارم: آیا بازیابیِ همسایهٔ برابر یک، ارتباط معنایی را ثابت میکند؟ پاسخ: خیر؛ فقط همسانی با نزدیکترینها طبق فاصلهٔ انتخابشده است. مناسببودن نمایش و پاسخگویی به سؤال انسانی هنوز آزموده نشدهاند.
منابع و مطالعهٔ بیشتر
- Faiss؛ نمایههای تخت و روش Cell-probe
- NumPy 2.4؛ جمع روی محور مشخص
- NumPy 2.4؛ argmin و نخستین کمینهٔ مساوی
بررسی منابع: ۲۵ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.