فهرست مقاله
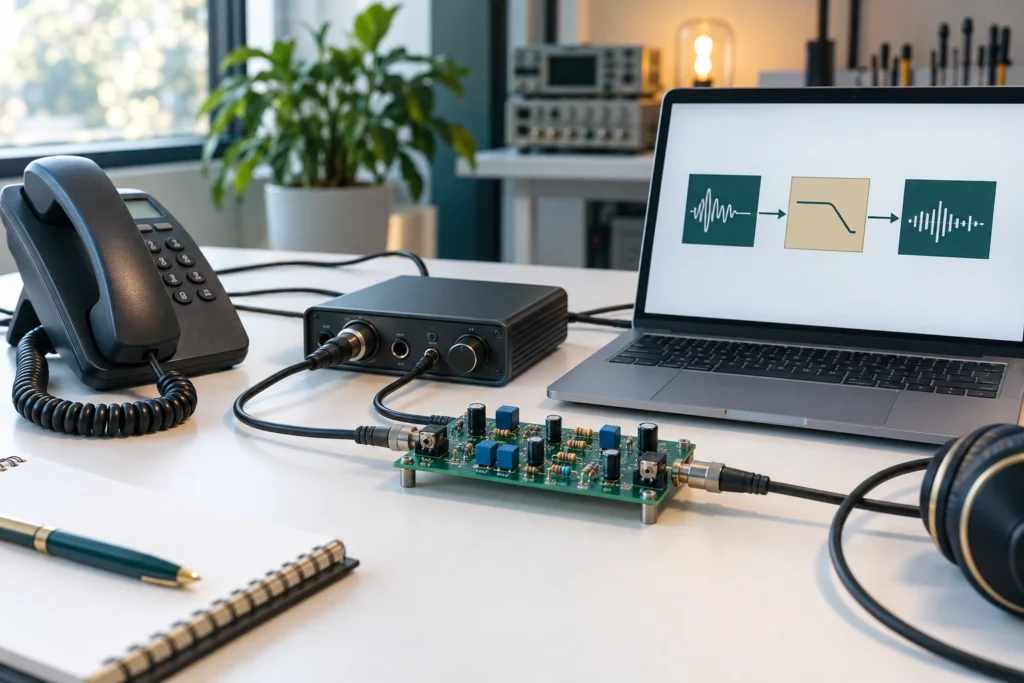
تلفن هوشمندِ متکی بر پایگاه دانش سازمانی، پیش از بازیابی سند و ساخت پاسخ، به ورودی صوتی قابل اتکا نیاز دارد. یک خطای کوچک در نرخ نمونهبرداری میتواند زمان صوت را تغییر دهد یا مؤلفهای را به باند گفتار منتقل کند. این آموزش با یک آزمایش تألیفی و کاملاً مصنوعی، مسیر تبدیل صوت ۴۸ کیلوهرتز به ۱۶ کیلوهرتز را بررسی میکند. نرخ ۱۶ کیلوهرتز در اینجا انتخاب مثال است؛ نرخ موردنیاز هر مدل باید از مشخصات همان مدل خوانده شود. آزمایش حاضر آزمون کیفیت یک محصول، دادهٔ تماس واقعی یا نتیجهٔ تشخیص گفتار نیست.
۱. ابتدا قرارداد ورودی صوت را مشخص کنید
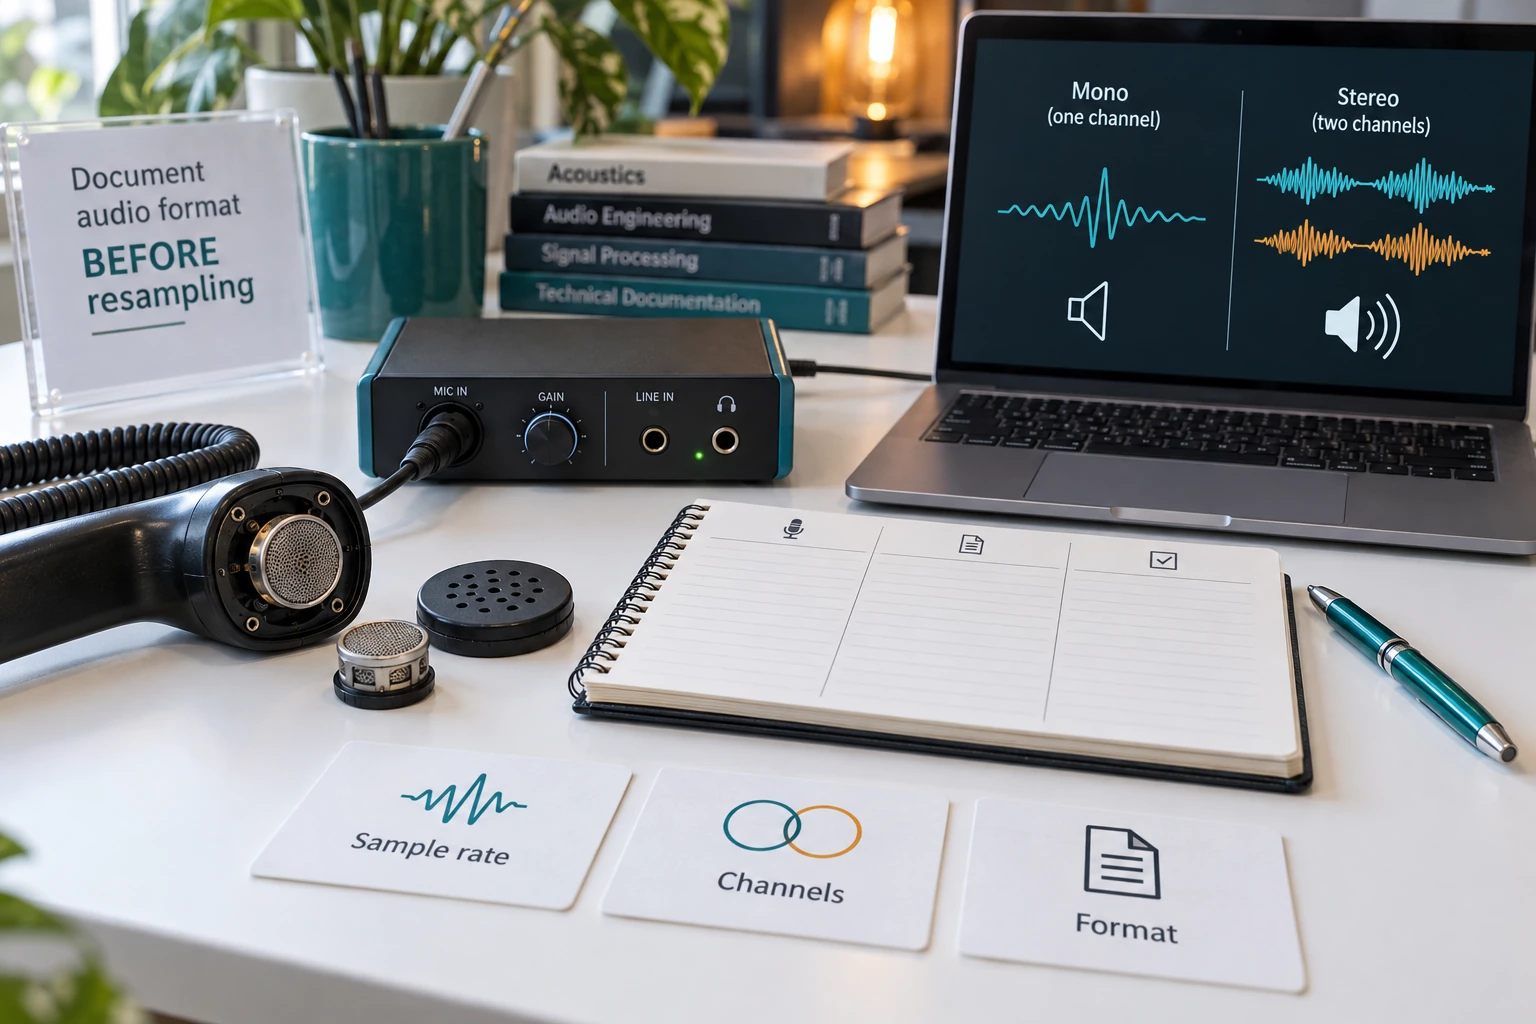
قبل از نوشتن تبدیلکننده، چهار پرسش را پاسخ دهید: نمونهها با چه نرخی ضبط شدهاند، آرایه چند کانال دارد، زمان در کدام محور آرایه است و مقدار نمونه چه معنایی دارد؟ یک آرایهٔ عددی بدون این اطلاعات، قرارداد ورودی کافی نیست. در مثال این مقاله، نرخها برحسب نمونه در ثانیه هستند، زمان روی محور صفر قرار دارد و دادهٔ تککاناله یک بردار است. برای دادهٔ دوکاناله، شکل آرایه «تعداد نمونه × تعداد کانال» خواهد بود.
اگر فایلی با نرخ ۴۸۰۰۰ نمونه در ثانیه دارید، نوشتن عدد ۱۶۰۰۰ در سربرگ آن بهتنهایی تبدیل صوت انجام نمیدهد. یک ثانیهٔ ورودی دارای ۴۸۰۰۰ نمونه است؛ اگر همان نمونهها با نرخ ۱۶۰۰۰ پخش شوند، طول آن به سه ثانیه تبدیل میشود. تبدیل واقعی باید تعداد نمونهها را متناسب با نرخ تازه تغییر دهد و مدت ضبط را حفظ کند. بررسی عدد نمونهها، آزمونی مستقل از گوشدادن به فایل است.
در صوت صحیح با علامت، تبدیل نوع عددی و مقیاسکردن دامنه را هم صریح انجام دهید. افزودن کانال یا میانگینگیری کانالها تصمیم جداگانهای است: میانگین دو کانال با فاز مخالف ممکن است محتوای مطلوب را حذف کند. تبدیل نرخ را با اصلاح تعداد کانال و تنظیم سطح صوت در یک عملیات مبهم مخلوط نکنید. این قرارداد میتواند در ورودی معماری تلفن هوشمند سازمانی بهصورت مشخصات قابل آزمون ثبت شود.
۲. چرا انتخاب هر سومین نمونه کافی نیست؟
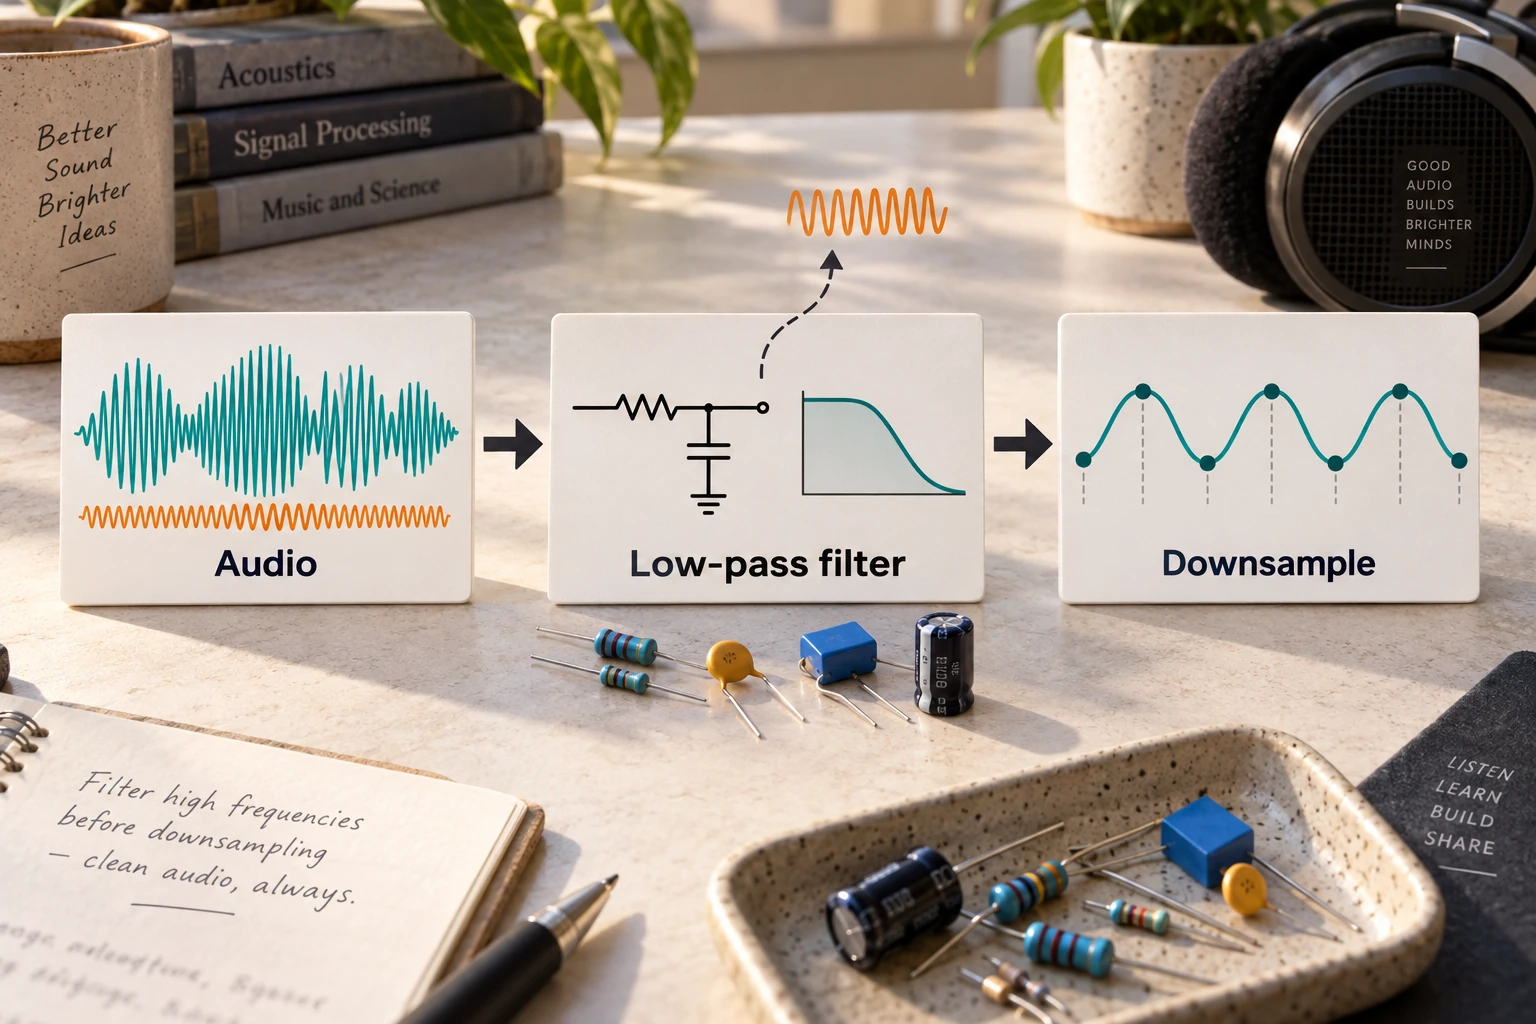
در مثال ۴۸ به ۱۶ کیلوهرتز، انتخاب هر سومین نمونه تعداد نمونهها را درست میکند، اما لزوماً محتوای فرکانسی را درست نگه نمیدارد. فرکانس نایکوئیست خروجی ۸ کیلوهرتز است؛ مؤلفهای که پیش از کاهش نرخ بالاتر از این مرز قرار دارد، میتواند در خروجی به فرکانسی پایینتر تا بخورد. برای موج ۱۳ کیلوهرتز در نرخ خروجی ۱۶ کیلوهرتز، اختلاف ۱۶ و ۱۳ برابر ۳ کیلوهرتز است. همین مؤلفهٔ مزاحم را در آزمایش اندازه میگیریم.
راهحل، محدود کردن باند پیش از کاهش نرخ است. تابع resample_poly در SciPy این کار را با فیلتر FIR در ساختار چندفازی انجام میدهد. نسبت تبدیل در پارامترهای up و down بیان میشود؛ برای مثال حاضر، up برابر یک و down برابر سه است. این تابع را با فیلتر ضدهمپوشانی در مستندات decimate میتوان از نظر هدف پردازش مقایسه کرد؛ این مقاله فقط مسیر resample_poly را اجرا میکند.
فیلتر عملی دارای ناحیهٔ گذار است. انتظار اینکه تمام فرکانسهای کمتر از ۸ کیلوهرتز بدون تغییر بگذرند و تمام فرکانسهای بالاتر فوراً صفر شوند، انتظار فیلتر ایدئال است. انتخاب فیلتر به پهنای باند مفید، تضعیف لازم و محدودیت زمان پردازش بستگی دارد. افزایش نرخ یک ضبط کمباند نیز اطلاعات فرکانسی ازدسترفته را بازسازی نمیکند؛ نمونههای بیشتر معادل جزئیات تازهٔ واقعی نیستند.
۳. مثال کامل پایتون با دادهٔ مصنوعی
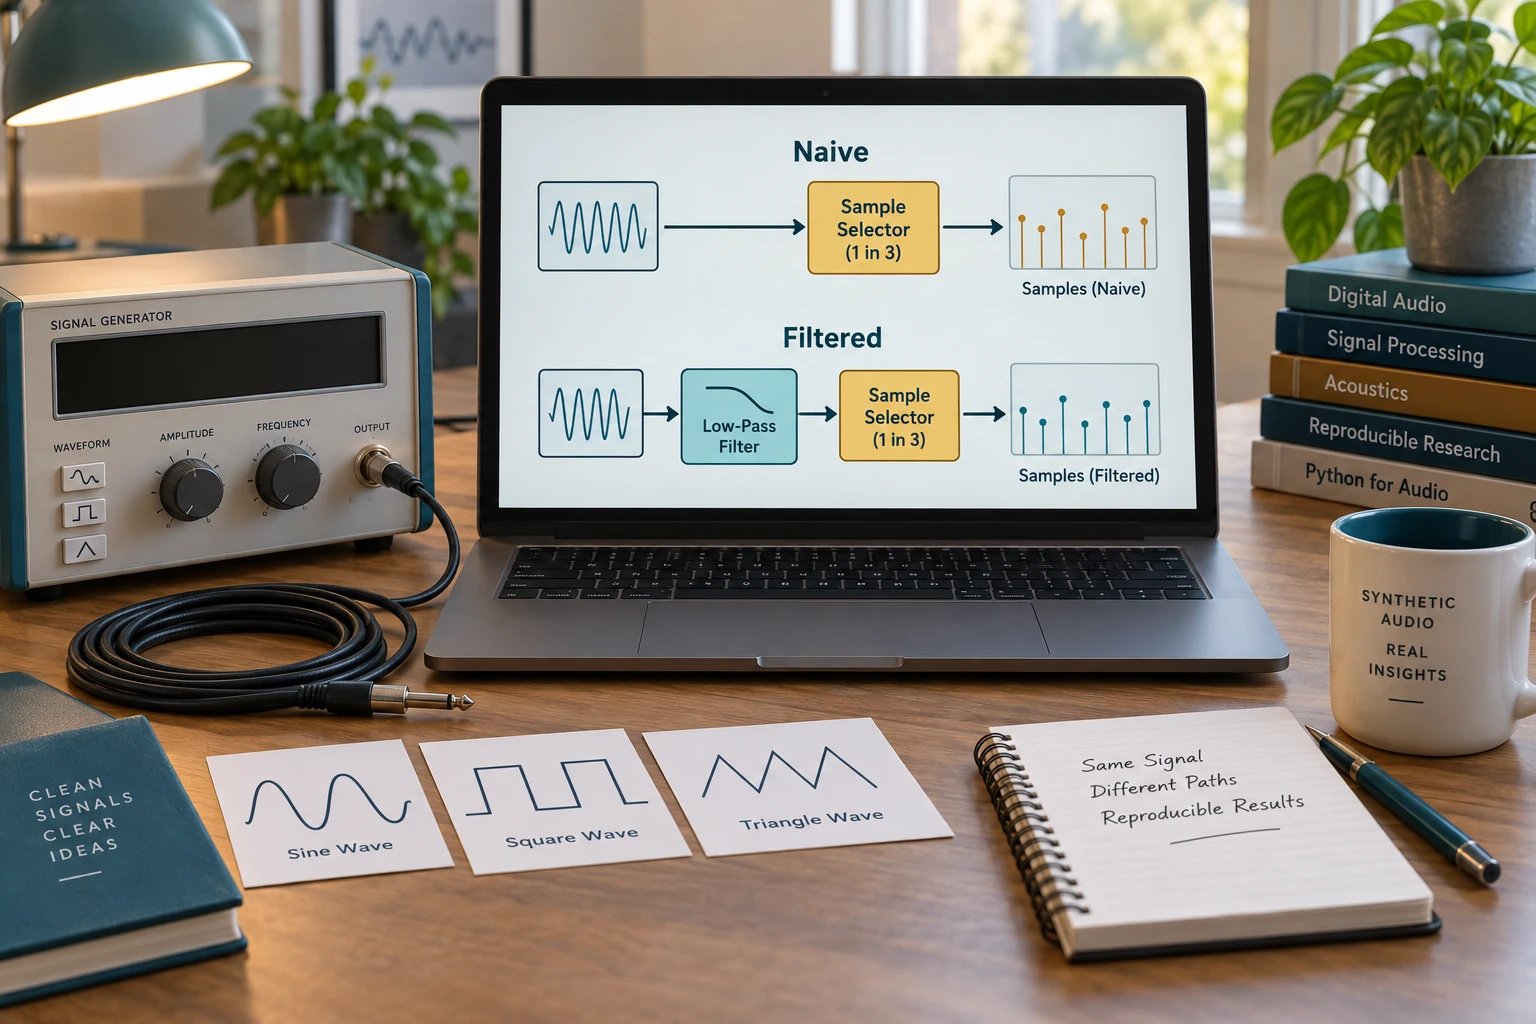
سیگنال ورودی را از مجموع دو موج میسازیم: موج مطلوب یک کیلوهرتز با دامنهٔ ۰٫۵ و موج مزاحم ۱۳ کیلوهرتز با دامنهٔ ۰٫۳. ورودی دقیقاً یک ثانیه طول دارد و هیچ تصادفیسازی در آن نیست. دو مسیر روی همان ورودی اجرا میشوند: حذف سادهٔ نمونهها و تبدیل فیلترشده. برای اندازهگیری دامنه، سینوس و کسینوس فرکانس موردنظر را بر خروجی برازش میکنیم؛ این کار در این مثال، اندازهگیری را به انتخاب ظاهری قلهٔ نمودار وابسته نمیکند.
پنجاه میلیثانیه از ابتدا و انتهای خروجی کنار گذاشته میشود تا اثر مرزی در اندازهگیری دامنه غالب نباشد. این حذف فقط برای اندازهگیری آزمایش است و به معنی بریدن خودکار ابتدا و انتهای تماس در محصول نیست. موجهای آزمون بهطور مصنوعی طراحی شدهاند؛ رفتار خوب روی این دو موج، معیار کافی برای صدای فارسی، نویز محیط، بلندگوی تلفن یا فایل فشردهشده نیست.
کد زیر علاوه بر آزمایش اصلی، تبدیل دوکاناله، نسبت غیرصحیح ۴۴۱۰۰ به ۱۶۰۰۰ و رد ورودی خالی یا نامعتبر را بررسی میکند. نرخها به کسر سادهشده تبدیل میشوند؛ برای نسبت دوم، up برابر ۱۶۰ و down برابر ۴۴۱ است. هنگام اجرا، فایل را با نام audio_resampling.py ذخیره و کتابخانههای NumPy و SciPy را در محیط مستقل پروژه نصب کنید.
"""Authored deterministic educational experiment; synthetic tones, not speech data."""
import json
import platform
from math import gcd
import numpy as np
import scipy
from scipy.signal import resample_poly


def convert_audio(samples, input_rate, output_rate):
    x = np.asarray(samples, dtype=np.float64)
    if x.ndim not in (1, 2) or x.shape[0] == 0 or not np.isfinite(x).all():
        raise ValueError('Expected nonempty finite audio: samples or samples x channels')
    if type(input_rate) is not int or type(output_rate) is not int or min(input_rate, output_rate) <= 0:
        raise ValueError('Sample rates must be positive integers')
    factor = gcd(input_rate, output_rate)
    return resample_poly(x, output_rate // factor, input_rate // factor, axis=0)


def tone_amplitude(samples, sample_rate, frequency):
    # Fit sin/cos on the interior: boundary transients are excluded.
    trim = int(0.05 * sample_rate)
    y = samples[trim:-trim]
    t = np.arange(trim, len(samples) - trim) / sample_rate
    basis = np.column_stack((np.sin(2*np.pi*frequency*t), np.cos(2*np.pi*frequency*t), np.ones(t.size)))
    coefficients, *_ = np.linalg.lstsq(basis, y, rcond=None)
    return float(np.hypot(*coefficients[:2]))


fs_in, fs_out = 48000, 16000
t = np.arange(fs_in) / fs_in
x = 0.5*np.sin(2*np.pi*1000*t) + 0.3*np.sin(2*np.pi*13000*t)
bad = x[::3]
good = convert_audio(x, fs_in, fs_out)
metrics = {
    'input_samples': len(x), 'output_samples': len(good),
    'input_duration_s': len(x)/fs_in, 'output_duration_s': len(good)/fs_out,
    'naive_3khz_alias_amplitude': tone_amplitude(bad, fs_out, 3000),
    'filtered_3khz_alias_amplitude': tone_amplitude(good, fs_out, 3000),
    'filtered_1khz_amplitude': tone_amplitude(good, fs_out, 1000)
}
assert len(good) == 16000
assert abs(metrics['naive_3khz_alias_amplitude'] - 0.3) < 1e-10
assert metrics['filtered_3khz_alias_amplitude'] < 0.005
assert abs(metrics['filtered_1khz_amplitude'] - 0.5) < 0.005
stereo = np.column_stack((x, 0.25*x))
converted = convert_audio(stereo, fs_in, fs_out)
assert converted.shape == (16000, 2)
assert np.allclose(converted[:, 1], 0.25*converted[:, 0])
fractional = convert_audio(np.ones(44100), 44100, 16000)
assert len(fractional) == 16000 and np.allclose(fractional[100:-100], 1, atol=0.002)
for invalid in (np.array([]), np.array([np.nan]), np.zeros((2, 2, 2))):
    try:
        convert_audio(invalid, fs_in, fs_out)
    except ValueError:
        pass
    else:
        raise AssertionError('Invalid audio accepted')
print(json.dumps({'versions': {'python': platform.python_version(), 'numpy': np.__version__, 'scipy': scipy.__version__},
                  'metrics': metrics, 'checks': {'alias_rejected': True, 'passband_preserved': True,
                  'duration_preserved': True, 'stereo_axis': True, 'rational_conversion': True,
                  'invalid_inputs_rejected': True}, 'synthetic_example_only': True}, indent=2))
۴. نتیجهٔ اجرا و پاسخ تمرینها
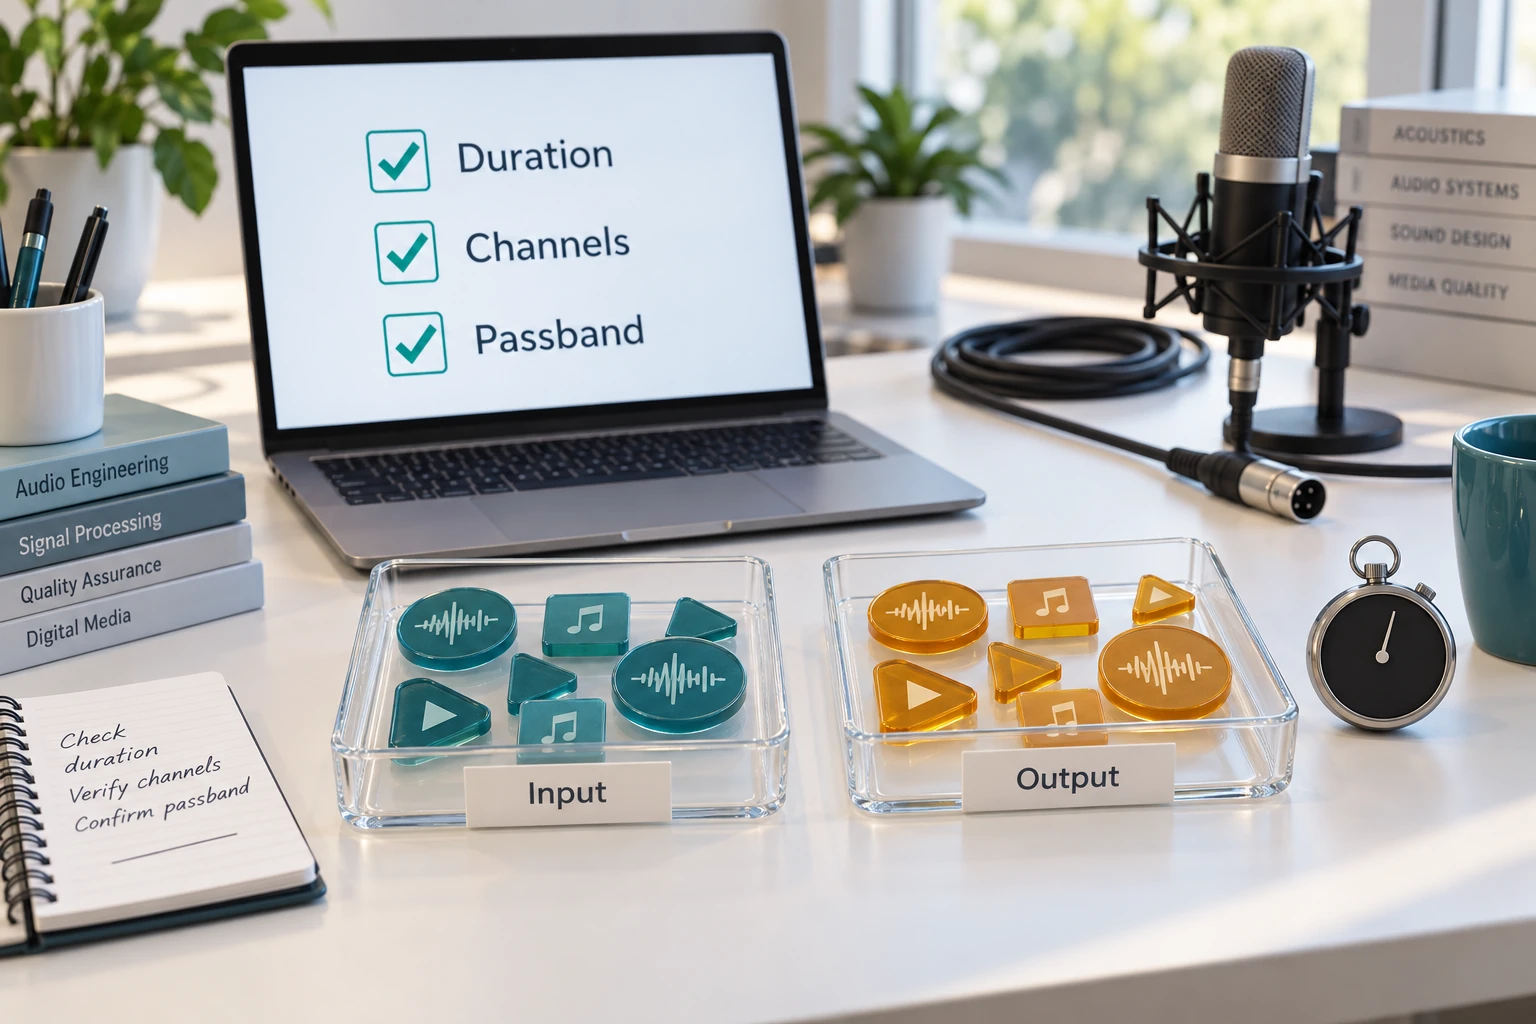
نسخهٔ پایتون و کتابخانهها همراه خروجی ثبت شدهاند. عددهای زیر خروجی اجرای همین مثال هستند و از تصویر مفهومی استخراج نشدهاند. دقت اعشار آخر ممکن است با نسخهٔ کتابخانه و محیط محاسبه تغییر کند؛ آزمونها به همین دلیل تلورانس عددی مشخص دارند.
{
  "versions": {
    "python": "3.14.5",
    "numpy": "2.5.4",
    "scipy": "1.18.1"
  },
  "metrics": {
    "input_samples": 48000,
    "output_samples": 16000,
    "input_duration_s": 1.0,
    "output_duration_s": 1.0,
    "naive_3khz_alias_amplitude": 0.30000000000000127,
    "filtered_3khz_alias_amplitude": 0.00015833687090725863,
    "filtered_1khz_amplitude": 0.5004918637658085
  },
  "checks": {
    "alias_rejected": true,
    "passband_preserved": true,
    "duration_preserved": true,
    "stereo_axis": true,
    "rational_conversion": true,
    "invalid_inputs_rejected": true
  },
  "synthetic_example_only": true
}
تمرین اول: مؤلفهٔ ۱۳ کیلوهرتز در روش انتخاب هر سومین نمونه کجا ظاهر میشود؟ پاسخ: در ۳ کیلوهرتز، با دامنهٔ تقریباً ۰٫۳. این تغییر فرکانس، تبدیل مطلوب سیگنال نیست؛ نشان میدهد حذف نمونه بدون محدود کردن باند، مؤلفهای را در محدودهٔ جدید قرار داده است.
تمرین دوم: آیا درست بودن تعداد ۱۶۰۰۰ نمونه ثابت میکند تبدیل صحیح است؟ پاسخ: خیر. هر دو مسیر این تعداد را دارند. آزمون تعداد، مدت و شکل آرایه را کنترل میکند؛ آزمون دامنهٔ مؤلفهٔ مطلوب و مزاحم، رفتار فرکانسی را میسنجد. این دو نوع آزمون جای یکدیگر را نمیگیرند.
تمرین سوم: برای ۴۴۱۰۰ به ۱۶۰۰۰ چه نسبت صحیحی لازم است؟ پاسخ: بزرگترین مقسومعلیه مشترک دو نرخ، ۱۰۰ است؛ صورت ۱۶۰ و مخرج ۴۴۱ خواهد بود. تبدیل این مثال نیز باید ۱۶۰۰۰ نمونه تولید کند. برای فایلهایی با طول دلخواه، گرد کردن تعداد نمونهها را در قرارداد زمان لحاظ کنید.
اگر برای تحلیل دیگری طیف رسم میکنید، rfft در NumPy برای ورودی حقیقی مناسب است؛ محور فرکانس باید با فاصلهٔ زمانی نمونهها ساخته شود، مطابق rfftfreq. نمودار بدون واحد، نرخ صحیح و روش نرمالسازی، مقایسهٔ قابل اتکایی ایجاد نمیکند.
۵. از مثال آفلاین تا تلفن هوشمند زنده
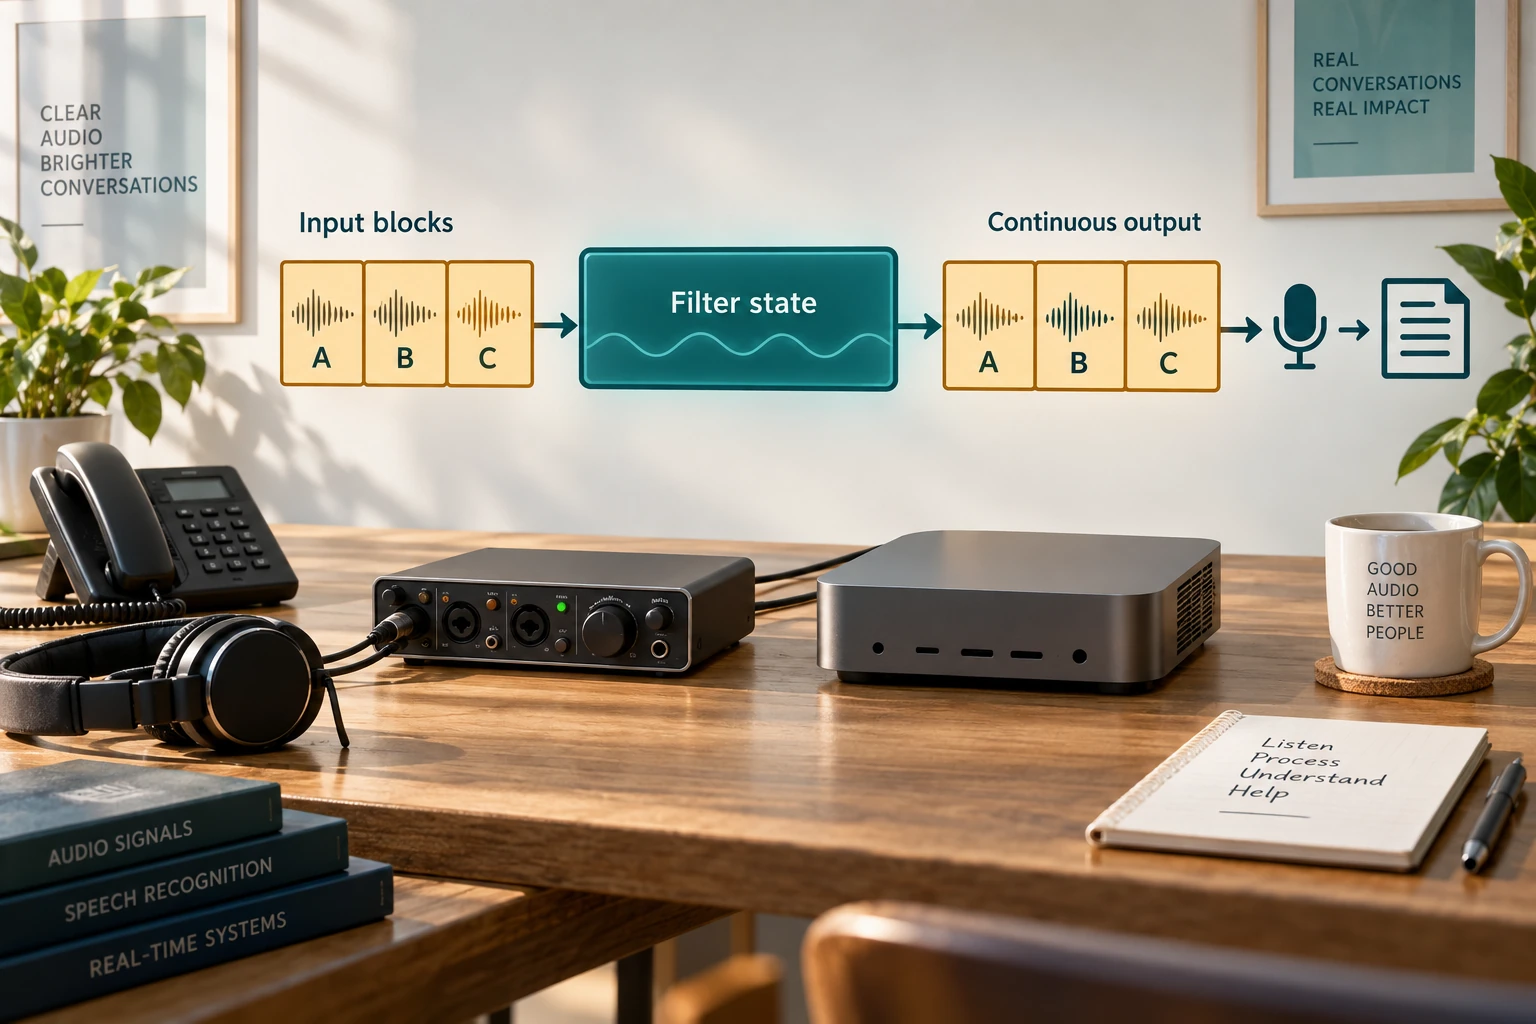
تابع آموزشی بالا روی یک آرایهٔ کامل کار میکند و پیادهسازی آمادهٔ پردازش جریانی تماس نیست. اگر هر بستهٔ کوتاه را جداگانه با حالت اولیهٔ تازه فیلتر کنید، مرزهای بسته میتوانند ناپیوستگی ایجاد کنند. در مسیر زنده باید حالت فیلتر، تاریخچهٔ نمونهها و شمارندهٔ نسبت تبدیل بین بستهها حفظ شود. تأخیر الگوریتمی و رفتار هنگام پایان جریان نیز بخشی از قرارداد سیستم هستند.
برای انتقال این منطق به سرویس واقعی، سه آزمون تکمیلی طراحی کنید: ورودی یکسان را با تقسیمبندیهای مختلف بستهها مقایسه کنید؛ نمونهٔ پایان جریان را با روش تخلیهٔ حالت کنترل کنید؛ و نرخ واقعی تولید نمونه را در برابر ساعت مصرفکننده اندازه بگیرید. تغییرات ساعت میتوانند حتی با عدد اسمی یکسان، ذخیرهٔ میانی را بهتدریج پر یا خالی کنند. رفتار درست روی آرایهٔ یکثانیهای این مسائل را حل نمیکند.
پس از تأیید تبدیل صوت، ارزیابی تشخیص گفتار باید روی مجموعهٔ آزمون مناسب انجام شود؛ مقالهٔ ارزیابی تشخیص گفتار فارسی مرحلهٔ مرتبط بعدی است. نرخ ورودی مدل، کانال، قطعهبندی و تنظیمات تبدیل را در گزارش هر آزمایش نگه دارید. کیفیت بازیابی دانش و کیفیت متن پاسخ را نیز جداگانه بسنجید؛ یک پاسخ نامناسب ممکن است از ورودی صوت، تشخیص گفتار، بازیابی یا تولید متن ناشی شده باشد.
منابع و مطالعهٔ بیشتر
- تبدیل چندفازی؛ مستندات SciPy
- کاهش نرخ با فیلتر ضدهمپوشانی؛ SciPy
- FFT برای ورودی حقیقی؛ NumPy
- محور فرکانس FFT حقیقی؛ NumPy
بررسی منابع: ۲۲ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.