فهرست مقاله
اگر چند ضریبِ یک قاب صوتی را نگه داریم، از کجا بدانیم نمونهها با چه مقیاسی بازسازی میشوند و حذفِ ضریب چه خطایی میسازد؟ در این درس یک تبدیل کسینوسیِ متعامد را روی قابهای کوچکِ ساختگی مینویسیم. پاسخ دستی، مرجع مستقلِ فوریه و ترازِ مجموع مربعها سه شاهدِ جدا فراهم میکنند. هدف، بررسیِ حسابِ قاب است؛ هیچ صدای واقعی، کدک، مدل گفتار یا کیفیتِ تماس در آزمایش حضور ندارد.
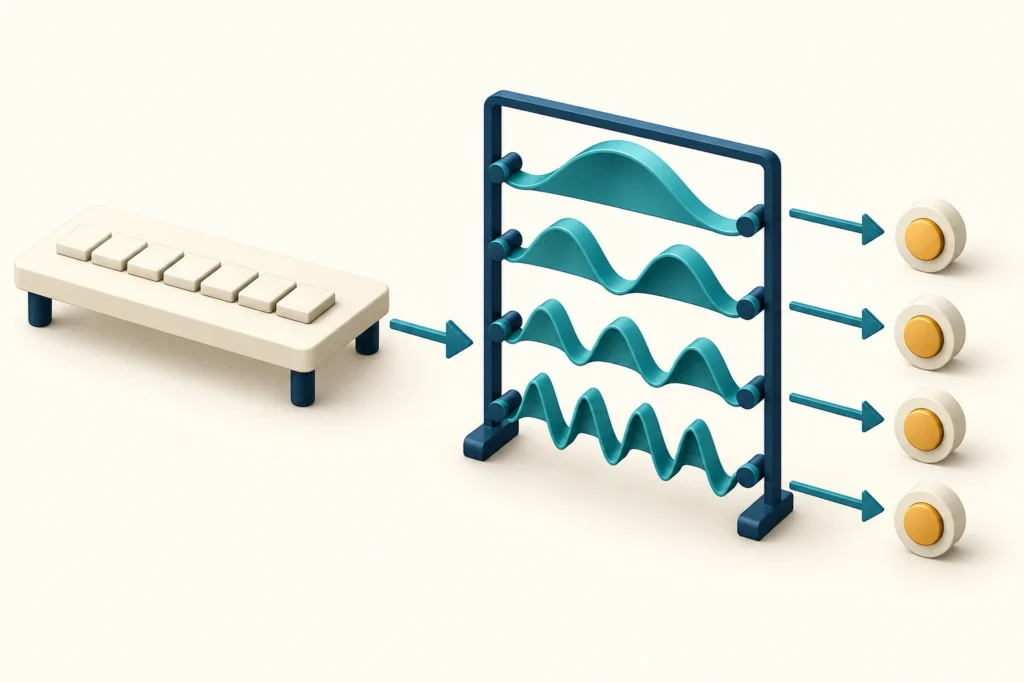
قاب را به ترکیبی از پایههای کسینوسی تبدیل کنیم
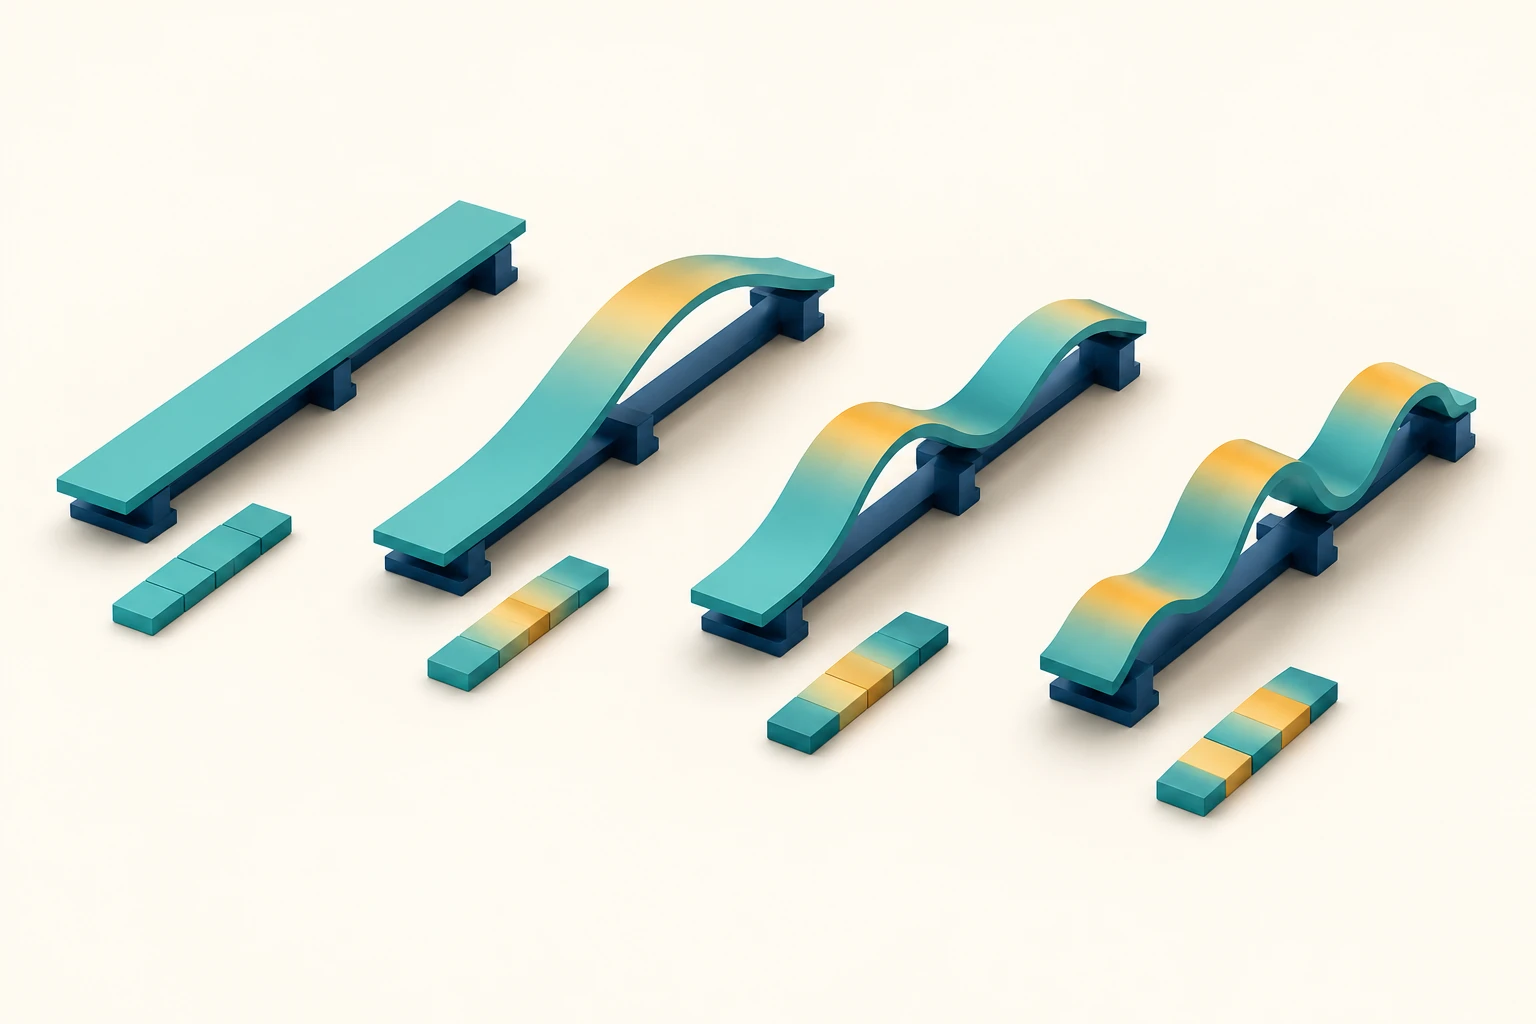
ورودیِ اصلی چهار مقدارِ بیبعدِ یک، منفی یک، منفی یک و یک دارد. نرخ نمونهبرداری تعریف نکردهایم؛ بنابراین چهار نمونه را مدتِ تماس یا ضرایب را فرکانسِ هرتزی نمینامیم. مقدارهای این قاب، ولتاژِ ثبتشده یا فشار صوت نیستند. اگر همین حساب در پروژهٔ واقعی روی نمونهٔ کالیبرهشده انجام شود، واحد، نرخ و منشأ باید جدا همراه داده ثبت شوند.
در DCT نوع دو، هر ضریب، جمع وزندارِ نمونهها با یک پایهٔ کسینوسی است. زاویهٔ پایهٔ شمارهٔ k در نمونهٔ n برابر πk(2n+1)/(2N) است؛ n و k از صفر تا N−1 میروند. نوع تبدیل و قراردادِ مقیاس جزئیات تزئینی نیستند. تعریف DCT در مستندات SciPy چند نوع و چند نرمالسازی را جدا مشخص میکند.
برای همین قاب، در حسابِ ایدهآل ضرایب بهترتیب صفر، صفر، دو و صفرند. پس پایهٔ شمارهٔ دو، با ضریبِ دو، تمام قاب را بازمیسازد. این یک مثالِ انتخابشده برای جواب دستی است؛ نمیگوید دادهٔ گفتاری هم همیشه فقط یک ضریبِ مؤثر دارد. در خروجیِ شناور، دو صفرِ نظری در حدود ده به توان منفی شانزده دیده میشوند و با تلورانس سنجیده میشوند.
درسِ دامنهٔ FFT و پنجرهٔ Hann دربارهٔ مقیاس دامنه، نشت و افزودن صفر بود. اینجا پنجرهٔ Hann، افزودن صفر به قاب و تخمینِ قله نداریم؛ پرسش، بازنماییِ کاملِ همین قاب در پایهای با مقیاس معلوم است. شکلِ خوشظاهرِ طیف، جای کنترلِ بازسازی و مقیاس را نمیگیرد.
مقیاس DC و معکوسِ متعامد را روشن نگه داریم
وزنِ کسینوسی برای k برابر صفر با یک تقسیم بر جذر N مقیاس میگیرد؛ برای بقیه، عاملِ جذرِ نسبتِ دو به N، یعنی sqrt(2/N)، به کار میرود. ردیفِ صفر ثابت است و ضریبِ آن برابر جمع نمونهها تقسیم بر جذر N میشود. مثلاً قابِ چهارعضویِ تماماً یک، ضریبِ ثابتِ دو دارد، نه چهار و نه دو ضرب در جذر دو.
در قراردادِ متعامد، ضربِ داخلیِ هر پایه با خودش یک و با پایهٔ دیگر صفر است. بنابراین معکوس، جمعِ همان پایهها با ضرایب است؛ ماتریسِ تبدیل را ترانهاده میکنیم. برای نمونهٔ اصلی، ضربِ ضریبِ دو در پایهٔ شمارهٔ دو، همان چهار مقدارِ ورودی را میدهد. ترکیبِ یک مقیاسِ جلو با معکوسی از قراردادِ دیگر میتواند عددهای باورپذیر اما نادرست تولید کند.
مرجع SciPy، حالتِ orthogonalize را از norm جدا توضیح میدهد و برای حالتِ متعامد، رفتارِ ویژهٔ ضریبِ صفر را بیان میکند. کدِ این درس جمعِ مستقیمِ تألیفی است؛ تابعِ dct آن کتابخانه اجرا نمیشود. همچنین بازسازی با جمعِ N پایه، ادعای الگوریتمِ سریع، بهرهوریِ پردازنده یا برابریِ بیتی با پیادهسازیِ SciPy و MATLAB نیست.
ضرایب را با مرجعِ تبدیل فوریه مقایسه کنیم
کد با Python 3.14.5 و NumPy 2.4.6 اجرا شده است. فایل را با نام dct_frame_reconstruction.py ذخیره و اجرا کنید. نمونهها باید tuple واقعی با طول یک تا شانزده، شامل int یا float واقعیِ متناهی و قدر مطلق حداکثر هشت باشند. bool، رشته، آرایهٔ ورودی و عدد نامعتبر تبدیلِ ضمنی نمیشوند. اینها کرانِ بازبینیِ تمریناند، نه مشخصاتِ عمومیِ صوت.
"""Finite orthonormal DCT-II frames; independent mirrored-FFT reference."""
import math
import platform
import json
import numpy as np

TOLERANCE = 2e-12  # Absolute tolerance for these bounded double-precision fixtures.


def finite_tuple(values, limit):
    if type(values) is not tuple or not 1 <= len(values) <= 16:
        raise ValueError("an actual tuple of length 1..16 is required")
    if any(type(v) not in (int, float) or abs(v) > limit or not math.isfinite(v)
           for v in values):
        raise ValueError("finite exact int/float elements within the stated bound required")
    return tuple(float(v) for v in values)


def basis(size):
    # Rows are the orthonormal cosine basis; row zero has a different scale.
    return tuple(tuple((1 / math.sqrt(size) if k == 0 else math.sqrt(2 / size))
                       * math.cos(math.pi * k * (2 * n + 1) / (2 * size))
                       for n in range(size)) for k in range(size))


def dct2_ortho(samples):
    data = finite_tuple(samples, 8)
    return tuple(math.fsum(weight * value for weight, value in zip(row, data))
                 for row in basis(len(data)))


def inverse_ortho(coefficients):
    data = finite_tuple(coefficients, 64)
    rows = basis(len(data))
    return tuple(math.fsum(data[k] * rows[k][n] for k in range(len(data)))
                 for n in range(len(data)))


def retain(coefficients, indices):
    data = finite_tuple(coefficients, 64)
    if (type(indices) is not tuple
        or any(type(k) is not int or not 0 <= k < len(data) for k in indices)
        or len(set(indices)) != len(indices)):
        raise ValueError("distinct exact integer coefficient indices required")
    return tuple(value if k in indices else 0.0 for k, value in enumerate(data))


def mirrored_fft_reference(samples):
    """Independent transform route: no cosine matrix, DCT or inverse helper."""
    values = np.array(samples, dtype=np.float64)
    size = len(values)
    even_extension = np.concatenate((values, values[::-1]))
    spectrum = np.fft.rfft(even_extension, norm="backward")
    phase = np.exp(-1j * np.pi * np.arange(size) / (2 * size))
    result = (spectrum[:size] * phase).real * (0.5 * np.sqrt(2 / size))
    result[0] /= np.sqrt(2)  # Orthogonalization, separate from the DFT relation.
    return tuple(float(v) for v in result)


def max_difference(left, right):
    return max(abs(a - b) for a, b in zip(left, right))


def energy(values):
    return math.fsum(value * value for value in values)


def rejects(call):
    try:
        call()
    except ValueError:
        return True
    return False


def run():
    literal = (1, -1, -1, 1)
    coefficients = dct2_ortho(literal)
    checks = {}
    checks["hand_four_sample_coefficient_k_two"] = max_difference(coefficients, (0, 0, 2, 0)) <= TOLERANCE
    constant = dct2_ortho((1, 1, 1, 1))
    checks["constant_frame_dc_has_distinct_scale"] = max_difference(constant, (2, 0, 0, 0)) <= TOLERANCE
    kept_k2 = inverse_ortho(retain(coefficients, (2,)))
    low_prefix = inverse_ortho(retain(coefficients, (0, 1)))
    checks["keeping_known_k_two_reconstructs_hand_frame"] = max_difference(kept_k2, literal) <= TOLERANCE
    prefix_mse = energy(tuple(a - b for a, b in zip(literal, low_prefix))) / len(literal)
    checks["keeping_low_prefix_can_discard_all_hand_energy"] = (
        max(abs(v) for v in low_prefix) <= TOLERANCE and abs(prefix_mse - 1) <= TOLERANCE)

    reference_errors, roundtrip_errors, energy_errors = [], [], []
    for size in range(1, 13):
        frames = (
            (0.25,) * size,
            tuple(((3 * n) % 7 - 3) / 4 for n in range(size)),
            tuple(0.75 if n == size - 1 else 0.0 for n in range(size)),
        )
        for frame in frames:
            transformed = dct2_ortho(frame)
            reference_errors.append(max_difference(transformed, mirrored_fft_reference(frame)))
            roundtrip_errors.append(max_difference(inverse_ortho(transformed), frame))
            energy_errors.append(abs(energy(frame) - energy(transformed)))
    checks["independent_mirrored_fft_36_frames_one_group"] = (
        len(reference_errors) == 36 and max(reference_errors) <= TOLERANCE)
    checks["roundtrip_36_bounded_frames_one_group"] = max(roundtrip_errors) <= TOLERANCE
    checks["parseval_36_bounded_frames_one_group"] = max(energy_errors) <= TOLERANCE

    gram_error = 0.0
    for size in range(1, 13):
        rows = basis(size)
        for i in range(size):
            for j in range(size):
                inner = math.fsum(a * b for a, b in zip(rows[i], rows[j]))
                gram_error = max(gram_error, abs(inner - (1 if i == j else 0)))
    checks["cosine_basis_rows_are_orthonormal_on_tested_sizes"] = gram_error <= TOLERANCE

    mixed = (0.5, 0.25, -0.5, 0.75, -0.25, 0.0)
    mixed_c = dct2_ortho(mixed)
    indices = (0, 2, 4)
    reconstructed = inverse_ortho(retain(mixed_c, indices))
    squared_error = energy(tuple(a - b for a, b in zip(mixed, reconstructed)))
    omitted_energy = energy(tuple(c for k, c in enumerate(mixed_c) if k not in indices))
    checks["omitted_coefficient_energy_equals_squared_reconstruction_error"] = abs(squared_error - omitted_energy) <= TOLERANCE

    raw_fft = np.fft.rfft(np.array(literal + literal[::-1], dtype=np.float64), norm="backward")
    wrong_without_phase_k2 = float(raw_fft[2].real * 0.5 * math.sqrt(2 / len(literal)))
    wrong_dc_without_special_scale = 8 * 0.5 * math.sqrt(2 / 4)
    checks["phase_and_dc_omission_have_visible_counterexamples"] = (
        abs(wrong_without_phase_k2 - math.sqrt(2)) <= TOLERANCE
        and abs(wrong_without_phase_k2 - coefficients[2]) > 0.5
        and abs(wrong_dc_without_special_scale - 2) > 0.8)
    checks["singleton_zero_and_selection_endpoints"] = (
        dct2_ortho((8,)) == (8.0,) and inverse_ortho((8,)) == (8.0,)
        and dct2_ortho((0, 0, 0)) == (0.0, 0.0, 0.0)
        and retain(coefficients, ()) == (0.0,) * 4
        and retain(coefficients, tuple(range(4))) == coefficients)

    bad_samples = ([], (), tuple([0] * 17), (True,), ("1",), (math.nan,),
                   (math.inf,), (-math.inf,), (8.01,), (10**1000,))
    checks["sample_container_type_length_and_range_errors"] = all(
        rejects(lambda v=v: dct2_ortho(v)) for v in bad_samples)
    checks["inverse_coefficient_contract_errors"] = all(
        rejects(lambda v=v: inverse_ortho(v)) for v in ([], (), (True,), (math.nan,), (64.01,)))
    checks["retained_indices_type_duplicates_and_bounds_errors"] = all(
        rejects(lambda v=v: retain(coefficients, v))
        for v in ([0], (True,), (0.0,), (-1,), (4,), (1, 1)))
    checks["linear_scaling_and_original_inputs_preserved"] = (
        max_difference(dct2_ortho(tuple(2 * v for v in literal)), tuple(2 * c for c in coefficients)) <= TOLERANCE
        and literal == (1, -1, -1, 1) and mixed == (0.5, 0.25, -0.5, 0.75, -0.25, 0.0))
    if not all(type(value) is bool and value for value in checks.values()):
        raise AssertionError(checks)
    return dict(
        python=platform.python_version(), numpy=np.__version__,
        scipy_executed=False, matlab_executed=False,
        input_kind="original synthetic dimensionless finite frames; no sampling rate or physical energy unit",
        absolute_tolerance=TOLERANCE, relative_tolerance=0,
        hand_frame=literal, hand_coefficients=coefficients,
        hand_keep_k_two_reconstruction=kept_k2, hand_keep_zero_one_reconstruction=low_prefix,
        hand_low_prefix_mean_squared_error=prefix_mse,
        wrong_reference_without_phase_coefficient_k2=wrong_without_phase_k2,
        wrong_constant_dc_without_special_scale=wrong_dc_without_special_scale,
        independent_reference_frames_inside_one_group=len(reference_errors),
        maximum_fft_reference_difference=max(reference_errors),
        maximum_roundtrip_difference=max(roundtrip_errors),
        maximum_full_energy_difference=max(energy_errors),maximum_basis_gram_error=gram_error,
        mixed_frame=mixed,mixed_coefficients=mixed_c,retained_indices=indices,
        mixed_reconstruction=reconstructed,squared_reconstruction_error=squared_error,
        omitted_coefficient_squared_sum=omitted_energy,
        checks=checks,unique_check_groups=len(checks),all_passed=True,
        limits=["Finite cosine sums, not a fast DCT implementation or SciPy execution",
                "Squared sample sums are dimensionless here, not joules or measured acoustic power",
                "Discarding coefficients is not byte compression or a speech quality evaluation"])


if __name__ == '__main__':
    print(json.dumps(run(),ensure_ascii=False,indent=2,allow_nan=False))
برای مرجعِ مستقل، پس از قاب، نسخهٔ معکوسِ ترتیبِ همان نمونهها را قرار میدهیم؛ طولِ دنباله دو برابر میشود. rfft در NumPy 2.4 روی این آرایهٔ حقیقیِ float64 اجرا میشود. این مسیر از تابعِ DCT، ماتریسِ کسینوسی و تابعِ معکوسِ خودمان برای ساختِ جوابِ انتظار استفاده نمیکند؛ تبدیلِ فوریه و چینشِ آینهای مسیرِ حسابِ دیگری میسازند.
طبق قراردادِ DFT و نرمالسازی NumPy، تبدیلِ جلو با norm برابر backward بدون مقیاسِ طول است. در این چینشِ آینهای، پیش از گرفتنِ قسمتِ حقیقی، ضریبِ k را در عاملِ مختلطِ exp(-i*pi*k/(2*N)) ضرب میکنیم؛ سپس نصف میکنیم و مقیاسِ پایهها را میدهیم. ضریبِ صفر باز هم تنظیمِ جداگانه لازم دارد.
این رابطه، به معنیِ برابر بودنِ بیواسطهٔ قسمتِ حقیقیِ FFT با DCT متعامد نیست. شاهدِ کد نشان میدهد حذفِ تنظیمِ فاز، ضریبِ شمارهٔ دو را در نمونهٔ اصلی حدود ۱٫۴۱۴۲ میدهد، درحالیکه پاسخ دو است. حذفِ مقیاسِ ویژهٔ DC نیز برای قابِ ثابت حدود ۲٫۸۲۸۴ میدهد، نه دو. شاهدها از همین دادهٔ ساختگیاند؛ خطای یک ابزارِ بیرونی گزارش نمیشود.
سه قابِ متفاوت برای هر طولِ یک تا دوازده ساخته شده است: قاب ثابت، دنبالهٔ محدودِ تغییرکننده و ضربه در انتها. سیوشش قاب در یک گروهِ مرجع مقایسه میشوند. بیشترین اختلافِ ضرایب حدود 1.665e-15 شد؛ تلورانسِ انتخابی مطلقِ 2e-12 و نسبی صفر است. این حاشیه، تضمینِ خطای همهٔ طولها و دامنهها نیست.
انرژیِ حذف ضریب را از خطای بازسازی حساب کنیم
در پایهٔ متعامد، مجموعِ مربعِ نمونهها با مجموعِ مربعِ ضرایب برابر است. اگر بعضی ضرایب را صفر کنیم و با همان پایه بازسازی کنیم، مجموعِ مربعِ خطا برابر مجموعِ مربعِ ضرایبِ حذفشده خواهد بود. این نتیجه از ضربِ داخلیِ پایهها میآید؛ در این دادهٔ بیبعد، واژهٔ انرژی فقط نامِ کوتاهِ مجموعِ مربعهاست و ژول یا توانِ آکوستیکیِ اندازهگیریشده نیست.
در قابِ چهارعضوی، نگه داشتنِ فقط ضریبِ شمارهٔ دو، بازسازیِ کامل میدهد. اما نگه داشتنِ فقط دو ضریبِ اول، تقریباً خروجیِ صفر میسازد؛ همهٔ سهمِ قاب در ضریبِ حذفشده بوده است. مجموعِ مربعِ خطا چهار و میانگینِ مربعِ خطا یک میشود. بنابراین شمارِ ضرایبِ باقیمانده بهتنهایی برای قضاوت دربارهٔ خطا کافی نیست.
یک قابِ ششعضویِ دیگر نیز داریم: ۰٫۵، ۰٫۲۵، منفی ۰٫۵، ۰٫۷۵، منفی ۰٫۲۵ و صفر. ضرایبِ صفر، دو و چهار حفظ میشوند. مجموعِ مربعِ خطای ثبتشده حدود ۱٫۰۳۱۲۵ است و با سهمِ ضرایبِ حذفشده در تلورانس برابر میشود. این انتخاب، پیشنهادِ بهترین مجموعهٔ ضرایب یا معیارِ شنیداری نیست؛ فقط ترازِ محاسباتیِ همان حذفِ اعلامشده را بررسی میکند.
{
  "python": "3.14.5",
  "numpy": "2.4.6",
  "scipy_executed": false,
  "matlab_executed": false,
  "input_kind": "original synthetic dimensionless finite frames; no sampling rate or physical energy unit",
  "absolute_tolerance": 2e-12,
  "relative_tolerance": 0,
  "hand_frame": [
    1,
    -1,
    -1,
    1
  ],
  "hand_coefficients": [
    0.0,
    -5.551115123125783e-17,
    2.0,
    1.6653345369377348e-16
  ],
  "hand_keep_k_two_reconstruction": [
    1.0000000000000002,
    -1.0,
    -1.0000000000000002,
    0.9999999999999998
  ],
  "hand_keep_zero_one_reconstruction": [
    -3.6264407168206574e-17,
    -1.5021209280491252e-17,
    1.502120928049125e-17,
    3.6264407168206574e-17
  ],
  "hand_low_prefix_mean_squared_error": 1.0,
  "wrong_reference_without_phase_coefficient_k2": 1.4142135623730951,
  "wrong_constant_dc_without_special_scale": 2.8284271247461903,
  "independent_reference_frames_inside_one_group": 36,
  "maximum_fft_reference_difference": 1.6653345369377348e-15,
  "maximum_roundtrip_difference": 1.887379141862766e-15,
  "maximum_full_energy_difference": 3.552713678800501e-15,
  "maximum_basis_gram_error": 2.065188298150389e-15,
  "mixed_frame": [
    0.5,
    0.25,
    -0.5,
    0.75,
    -0.25,
    0.0
  ],
  "mixed_coefficients": [
    0.3061862178478973,
    0.2961763564428564,
    0.12499999999999993,
    0.5103103630798288,
    0.21650635094610987,
    -0.826506442332767
  ],
  "retained_indices": [
    0,
    2,
    4
  ],
  "mixed_reconstruction": [
    0.25000000000000006,
    -7.884766335219964e-17,
    0.12500000000000014,
    0.12500000000000017,
    -9.652391733094807e-17,
    0.24999999999999992
  ],
  "squared_reconstruction_error": 1.0312499999999998,
  "omitted_coefficient_squared_sum": 1.0312500000000002,
  "checks": {
    "hand_four_sample_coefficient_k_two": true,
    "constant_frame_dc_has_distinct_scale": true,
    "keeping_known_k_two_reconstructs_hand_frame": true,
    "keeping_low_prefix_can_discard_all_hand_energy": true,
    "independent_mirrored_fft_36_frames_one_group": true,
    "roundtrip_36_bounded_frames_one_group": true,
    "parseval_36_bounded_frames_one_group": true,
    "cosine_basis_rows_are_orthonormal_on_tested_sizes": true,
    "omitted_coefficient_energy_equals_squared_reconstruction_error": true,
    "phase_and_dc_omission_have_visible_counterexamples": true,
    "singleton_zero_and_selection_endpoints": true,
    "sample_container_type_length_and_range_errors": true,
    "inverse_coefficient_contract_errors": true,
    "retained_indices_type_duplicates_and_bounds_errors": true,
    "linear_scaling_and_original_inputs_preserved": true
  },
  "unique_check_groups": 15,
  "all_passed": true,
  "limits": [
    "Finite cosine sums, not a fast DCT implementation or SciPy execution",
    "Squared sample sums are dimensionless here, not joules or measured acoustic power",
    "Discarding coefficients is not byte compression or a speech quality evaluation"
  ]
}
پانزده گروه بررسی اجرا شدند؛ پاسخ دستی، DC، مرجعِ فوریه، رفتوبرگشت، ترازِ مربعها، ضربِ داخلیِ پایهها، شاهدِ فاز و خطاهای ورودی را پوشش میدهند. برای معکوس، مقدارِ ضریب به قدر مطلق ۶۴ محدود است و فهرستِ اندیسهای حفظشده باید tuple با اعداد صحیحِ یکتا و مجاز باشد. صفر کردنِ همه یا نگه داشتنِ همه، حالتِ مرزیِ صریح دارد.
بازسازی قاب را فشردهسازی یا کیفیت گفتار ننامیم
پرسش اول: چرا قابِ ثابتِ چهارعضوی، ضریبِ صفرِ دو دارد؟ پاسخ: جمعِ چهار مقدارِ یک، چهار است و تقسیم بر جذرِ چهار، دو میدهد؛ دیگر پایهها با پایهٔ ثابت متعامدند.
پرسش دوم: چرا حفظِ دو ضریبِ اولِ نمونهٔ اصلی کافی نیست؟ پاسخ: ضریبِ غیرصفر در اندیسِ دو قرار دارد؛ دو اندیسِ اول صفر و یکاند و آن سهم را حذف میکنند. میانگینِ مربعِ خطا در همین شاهد یک است.
پرسش سوم: آیا نرمالسازیِ FFT بهتنهایی مرجع را آماده میکند؟ پاسخ: خیر؛ ترتیبِ آینهای، فازِ نیمنمونه و مقیاسِ ویژهٔ صفر نیز در این رابطه لازماند. کد برای حذفِ عمدیِ دو عامل شاهدِ عددی دارد.
پرسش چهارم: آیا صفر کردنِ ضریب یعنی فایل کمحجمتر یا گفتار بهتر شده است؟ پاسخ: خیر؛ آرایه هنوز همان طول را دارد و هیچ بستهبندیِ بایتی، کوانتیزهسازی یا ارزیابیِ گفتاری نداریم. بازسازیِ چند قابِ همپوشان با STFT نیز مسئلهٔ جداگانهٔ مرز و وزن دارد که این تبدیلِ تکقاب آن را حل نمیکند.
منابع در ۲۶ مهر ۱۴۰۵ خوانده شدند. مستنداتِ SciPy نسخهٔ ۱٫۱۸٫۰ و NumPy نسخهٔ ۲٫۴ از نسخهٔ اجرای واقعی جدا ثبتاند؛ تاریخِ انتشارِ اولیهٔ این صفحهها مشخص نشده است. آموزش، پایه و تألیفی است؛ نه خبر تازه، نه اجرای MATLAB و نه نتیجهٔ کیفیتِ محصول. برای کاربرد واقعی، قراردادِ قاب و معیارِ مرتبط با همان وظیفه باید جدا ارزیابی شود.
منابع و مطالعهٔ بیشتر
- SciPy؛ تعریف DCT نوع دو، نرمالسازی و مقیاس ویژهٔ ضریب صفر
- NumPy 2.4؛ تعریف تبدیل فوریه و جهت نرمالسازی
- NumPy 2.4؛ rfft برای آرایهٔ حقیقی و طول خروجی
بررسی منابع: ۲۶ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.