فهرست مقاله
در یک موتور جستوجوی دانش سازمانی، ظاهر مناسب فهرست نتایج بهتنهایی نشان نمیدهد کاربر سند موردنیاز را پیدا کرده است. باید یک مجموعهٔ آزمون مشخص، قضاوت دربارهٔ ارتباط سندها و قرارداد محاسبهٔ معیار داشته باشیم. این آموزش با داده و رتبهبندیهای ساختگی، سه معیار Precision@3، Recall@3 و nDCG@3 را محاسبه و پیادهسازی را با scikit-learn کنترل میکند. عددهای مثال، اندازهگیری عملکرد موتور جستوجوی 00f.ir یا محصول دیگری نیستند. هدف، یادگیری روش ارزیابی است.
۱. مجموعهٔ پرسش، سند و قضاوت را ثابت کنید
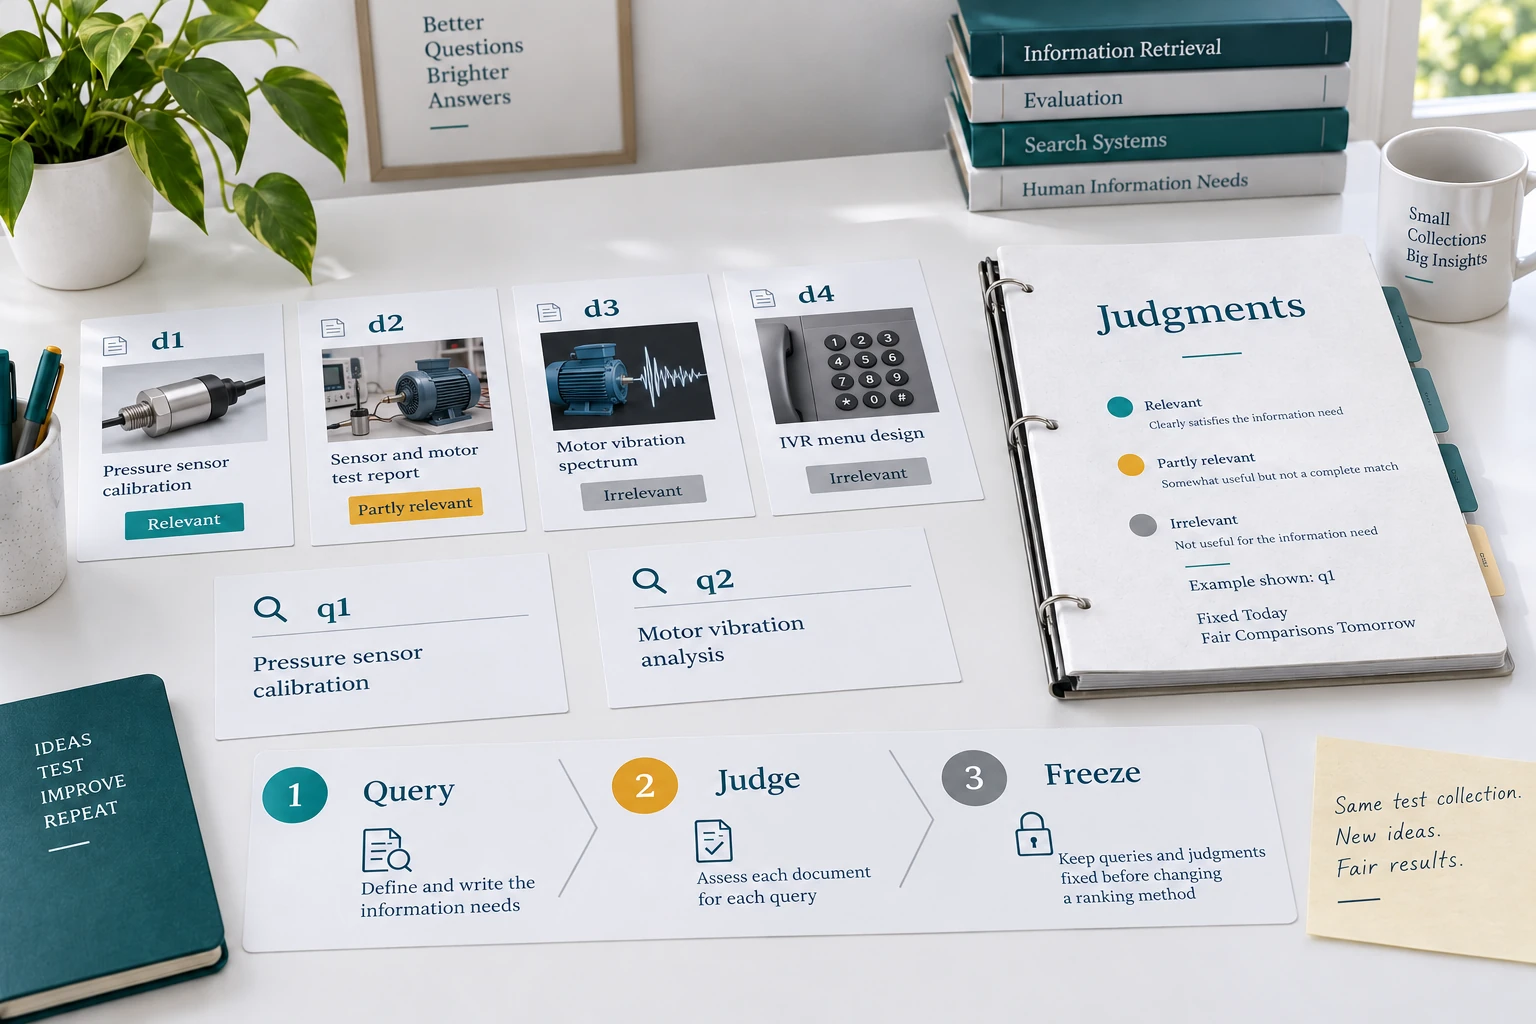
ابتدا مشخص کنید کاربر برای هر پرسش چه نیازی دارد. یک سند ممکن است برای پرسش کالیبراسیون حسگر مفید باشد و برای طراحی منوی تلفن گویا بیارتباط باشد. بنابراین ارتباط، ویژگی ثابتِ خود سند نیست؛ به پرسش و زمینهٔ کار وابسته است. در مثال، چهار شناسهٔ سند تعریف میکنیم و برای هر پرسش، امتیاز مستقل هر سند را در یک فرهنگ داده نگه میداریم.
قضاوتهای آموزشی این مقاله، امتیاز صفر برای بیارتباط و امتیازهای مثبت برای ارتباط دارند. درجههای یک و دو نشاندهندهٔ فایدهٔ جزئی و درجهٔ سه نشاندهندهٔ ارتباط بیشتر در همین قراردادند. در محاسبهٔ Precision و Recall، هر درجهٔ مثبت «مرتبط» شمرده میشود؛ در nDCG، مقدار درجه نیز اهمیت دارد. این آستانه و مقیاس باید پیش از مقایسهٔ رتبهبندیها ثبت شوند.
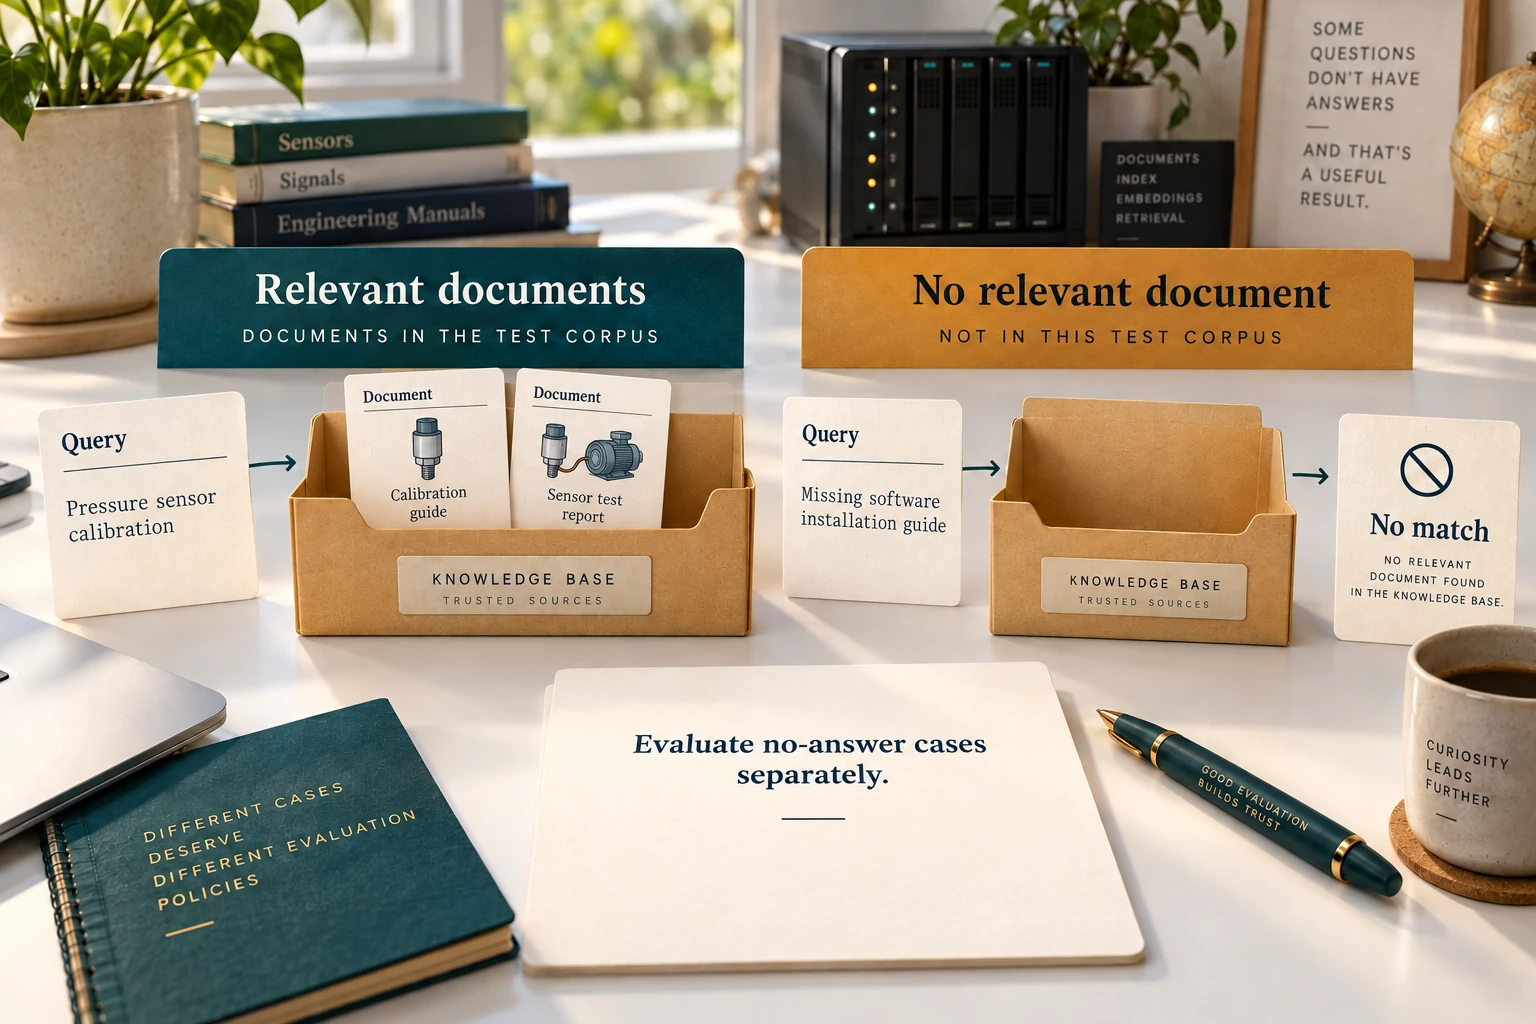
دو پرسش دارای سند مرتبط و یک پرسشِ بدون سند مرتبط در مجموعه داریم. عنوانها و قضاوتها را خودمان برای آموزش ساختهایم؛ ارزیاب انسانی یا مشتری واقعی در این مثال حضور نداشته است. در ارزیابی یک سامانهٔ واقعی، پرسشها باید نیازهای نمایندهٔ کاربران را پوشش دهند و اختلاف ارزیابها ثبت شود. پیش از این مرحله، مقالهٔ از نمایهٔ واژهها تا جستوجوی معنایی مسیر تولید نتایج جستوجو را توضیح میدهد.
۲. معیارها و قرارداد عمق فهرست را مشخص کنید
تعریف پایهٔ Precision و Recall در کتاب بازیابی اطلاعات استنفورد، تعداد سندهای مرتبطِ پیداشده را به دو مخرج متفاوت مرتبط میکند. Precision به نتایج بازگرداندهشده نگاه میکند؛ Recall به سندهای مرتبطِ شناختهشده در مجموعه. در این آموزش، Precision@3 برابر تعداد موارد مرتبط در سه جایگاه اول تقسیم بر سه است. اگر فقط یک نتیجه بازگردد، دو جایگاه خالی را نیز در مخرج ثابت حساب میکنیم.
Recall@3 برابر همان تعداد پیداشده تقسیم بر تعداد کل سندهای مرتبطِ شناختهشده برای پرسش است. این تعداد در مجموعهٔ کوچک ما کامل است. در مجموعهٔ واقعی، قضاوتهای ناقص میتوانند تفسیر Recall را محدود کنند. وضعیت پرسشی که هیچ سند مرتبطی ندارد نیز باید قرارداد صریح داشته باشد؛ اینجا Recall و nDCG آن پرسش را نامعین ثبت میکنیم.
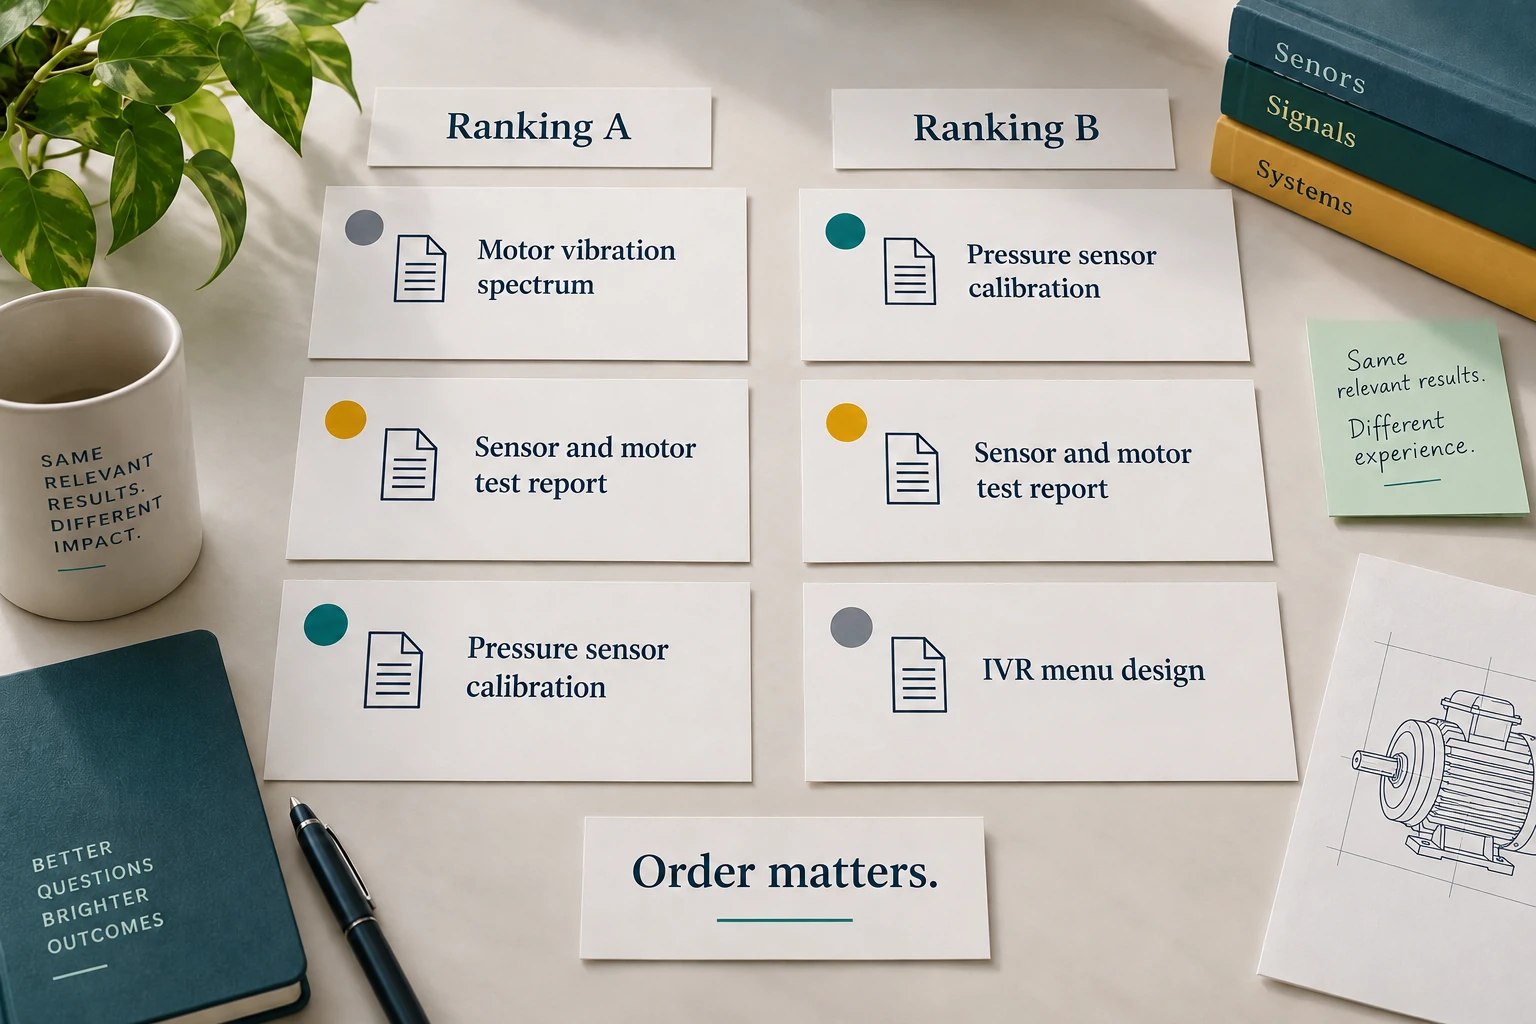
تعداد نتایج مرتبط، ترتیب آنها را نشان نمیدهد. ارزیابی فهرست رتبهبندیشده این موضوع را مطرح میکند. برای nDCG، فایدهٔ هر سند با جایگاهش تنزیل و مجموع حاصل با ترتیب ایدئال مقایسه میشود. کد حاضر از «فایده برابر درجهٔ ارتباط» استفاده میکند، مطابق مسیر خطی در dcg_score. قرارداد دیگری با فایدهٔ نمایی نیز وجود دارد؛ هنگام مقایسهٔ دو گزارش، یکسان بودن این قرارداد را کنترل کنید.
۳. کد کامل و کنترل مستقل پیادهسازی
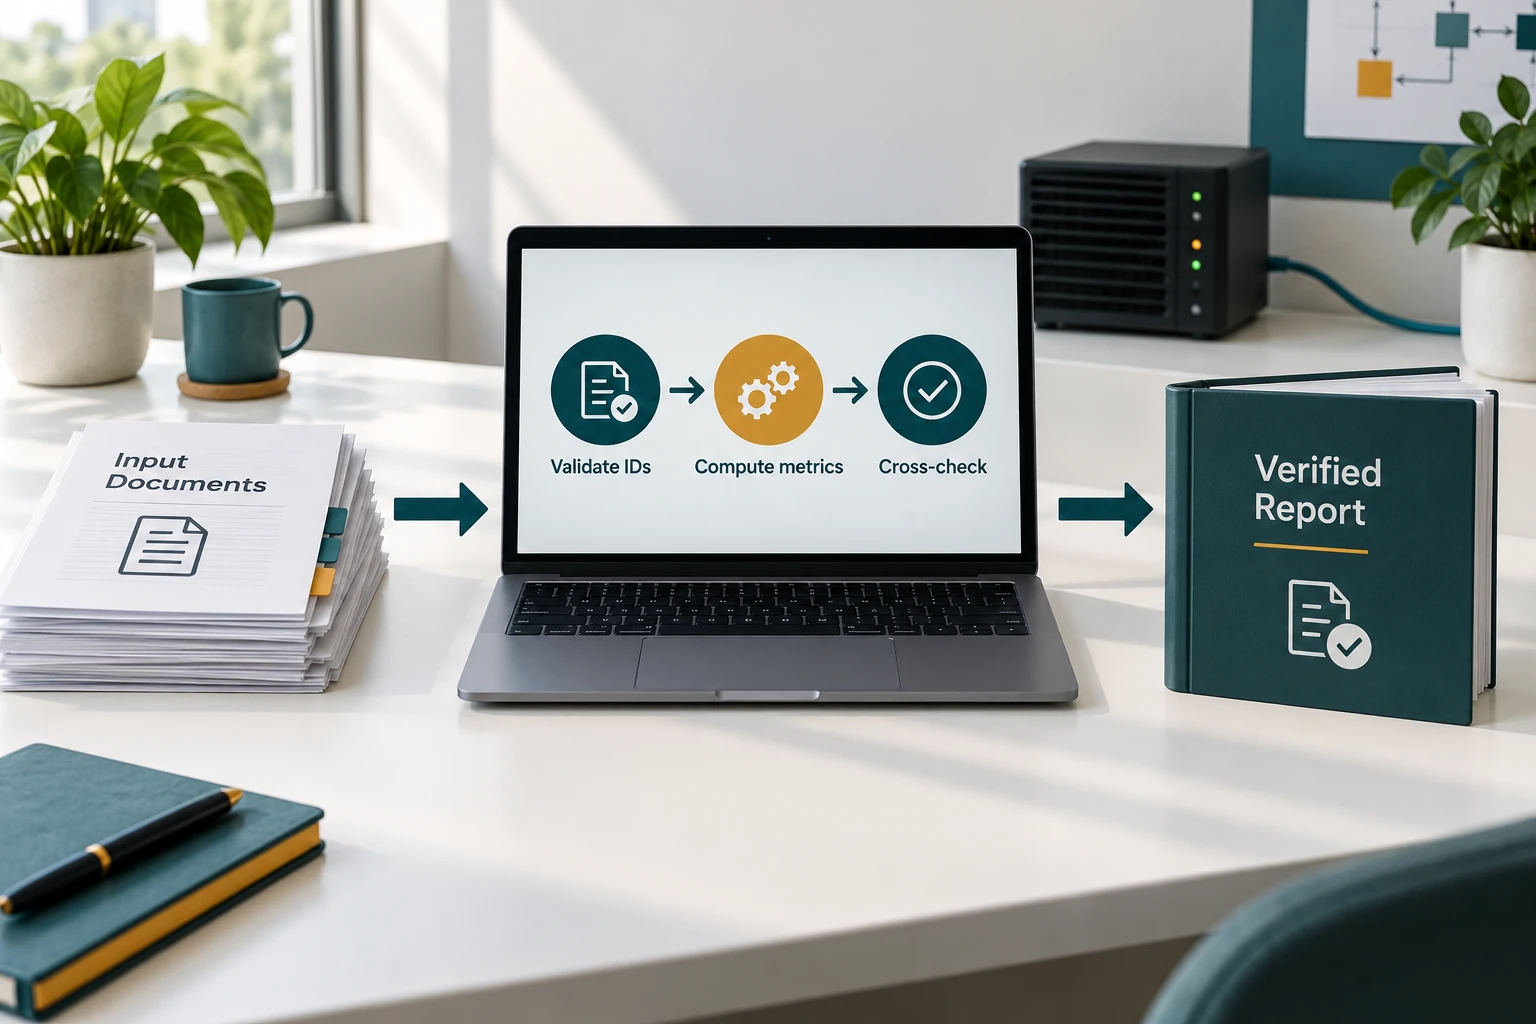
دو مجموعهٔ فهرست با نامهای A و B در کد آمدهاند. این فهرستها خروجی مدل آموزشدیده یا اجرای موتور جستوجو نیستند؛ نمونههای تألیفیاند که رفتار معیار را آشکار میکنند. برای هر پرسش، تابع تعداد سند مرتبط، تعداد نتیجهٔ بازگشتی و سه معیار را گزارش میکند. کد شناسهٔ تکراری، سند ناشناخته، درجهٔ نامتناهی یا منفی و مقدار نامعتبر k را نمیپذیرد.
برای کنترل nDCG، در چهار حالتِ مربوط به دو پرسش و دو فهرست، یک ماتریس درجهٔ ارتباط و یک ماتریس امتیاز بدون تساوی میسازیم. سپس نتیجهٔ تابع خودمان را با ndcg_score در scikit-learn مقایسه میکنیم. تطبیق این عددها، پیادهسازی معیار را در همین حالتها بررسی میکند؛ کیفیت قضاوت دربارهٔ ارتباط را تأیید نمیکند.
فایل را با نام search_ranking_evaluation.py ذخیره و NumPy و scikit-learn را در محیط پروژه نصب کنید. همهٔ دادههای آموزشی در خود فایل هستند و نیازی به کلید API، حساب کاربری یا پایگاه دادهٔ خصوصی ندارید. میانگین گزارش، فقط روی دو پرسش دارای سند مرتبط محاسبه میشود. تعداد نتایج پرسش بدون پاسخ جداگانه نمایش داده میشود تا پشت میانگین پنهان نماند.
"""Authored toy retrieval evaluation. Rankings and judgments are synthetic fixtures."""
import json
import math
import platform
import numpy as np
import sklearn
from sklearn.metrics import ndcg_score
DOCUMENTS={
'd1':'راهنمای کالیبراسیون حسگر فشار',
'd2':'گزارش آزمون حسگر فشار و موتور آزمایشگاهی',
'd3':'روش تحلیل طیف ارتعاش موتور',
'd4':'آموزش طراحی منوی تلفن گویا'
}
JUDGMENTS={
'q1':{'d1':3,'d2':1,'d3':0,'d4':0},
'q2':{'d1':0,'d2':2,'d3':3,'d4':0},
'q3':{'d1':0,'d2':0,'d3':0,'d4':0}
}
QUERIES={'q1':'کالیبراسیون حسگر فشار','q2':'تحلیل ارتعاش موتور','q3':'دستور نصب نرمافزاری که در مجموعه نیست'}
RANKINGS={
'A':{'q1':['d3','d2','d1','d4'],'q2':['d1','d4','d3','d2'],'q3':['d4','d1']},
'B':{'q1':['d1','d2','d4','d3'],'q2':['d2','d3','d4','d1'],'q3':[]}
}
def metrics_at_k(ranking,grades,k):
if type(k) is not int or k<=0 or k>len(grades):
raise ValueError('k must be a positive integer no larger than the corpus')
if len(ranking)!=len(set(ranking)) or any(d not in grades for d in ranking):
raise ValueError('Ranking must contain unique known document IDs')
if any(not math.isfinite(v) or v<0 for v in grades.values()):
raise ValueError('Relevance grades must be finite and nonnegative')
relevant={d for d,g in grades.items() if g>0}
top=ranking[:k]
hits=sum(d in relevant for d in top)
# Missing top-k slots count as zero; use a fixed k denominator.
dcg=sum(grades[d]/math.log2(rank+1) for rank,d in enumerate(top,1))
ideal=sum(g/math.log2(rank+1) for rank,g in enumerate(sorted(grades.values(),reverse=True)[:k],1))
return {'precision_at_k':hits/k,'recall_at_k':hits/len(relevant) if relevant else None,
'ndcg_at_k':dcg/ideal if ideal else None,'returned_count':len(top),'relevant_found':hits}
k=3
report={}
for system,runs in RANKINGS.items():
per_query={q:metrics_at_k(r,JUDGMENTS[q],k) for q,r in runs.items()}
evaluable=[m for m in per_query.values() if m['recall_at_k'] is not None]
aggregate={name:sum(m[name] for m in evaluable)/len(evaluable)
for name in ('precision_at_k','recall_at_k','ndcg_at_k')}
report[system]={'queries':per_query,'mean_over_positive_judgment_queries':aggregate,
'positive_queries':len(evaluable),'no_relevant_query_returned_count':per_query['q3']['returned_count']}
for q in ('q1','q2'):
ids=list(DOCUMENTS)
true=np.array([[JUDGMENTS[q][d] for d in ids]],dtype=float)
scores=np.array([[len(ids)-runs[q].index(d) for d in ids]],dtype=float)
external=float(ndcg_score(true,scores,k=k))
assert math.isclose(per_query[q]['ndcg_at_k'],external,abs_tol=1e-12)
assert math.isclose(report['A']['queries']['q1']['precision_at_k'],2/3)
assert report['A']['queries']['q2']['recall_at_k']==0.5
assert report['B']['queries']['q1']['ndcg_at_k']==1
assert report['B']['queries']['q3']['recall_at_k'] is None
assert report['B']['no_relevant_query_returned_count']==0
short=metrics_at_k(['d1'],JUDGMENTS['q1'],3)
assert math.isclose(short['precision_at_k'],1/3)
for invalid in (['d1','d1'],['unknown']):
try: metrics_at_k(invalid,JUDGMENTS['q1'],3)
except ValueError: pass
else: raise AssertionError('Invalid document list accepted')
print(json.dumps({'versions':{'python':platform.python_version(),'numpy':np.__version__,'scikit_learn':sklearn.__version__},
'k':k,'gain_convention':'linear relevance grade, not 2**grade-1','synthetic_example_only':True,
'rankings_are_authored_fixtures_not_model_outputs':True,'results':report,
'checks':{'manual_precision_case':True,'manual_recall_case':True,'ideal_ranking_ndcg':True,
'ndcg_cross_checked_with_sklearn':True,'no_relevance_policy':True,
'fixed_k_for_short_list':True,'duplicates_and_unknown_ids_rejected':True}},ensure_ascii=False,indent=2))
۴. خروجی اجرا و پاسخ تمرینها
گزارش زیر از اجرای همین کد به دست آمده است. همهٔ امتیازها به چهار سند، قضاوتهای ساختگی و قرارداد سه جایگاه اول محدودند. برای مقایسهٔ محصول واقعی باید خروجی همان محصول روی مجموعهٔ آزمون ثبت و سپس معیارها محاسبه شوند.
{
  "versions": {
    "python": "3.14.5",
    "numpy": "2.5.4",
    "scikit_learn": "1.9.1"
  },
  "k": 3,
  "gain_convention": "linear relevance grade, not 2**grade-1",
  "synthetic_example_only": true,
  "rankings_are_authored_fixtures_not_model_outputs": true,
  "results": {
    "A": {
      "queries": {
        "q1": {
          "precision_at_k": 0.6666666666666666,
          "recall_at_k": 1.0,
          "ndcg_at_k": 0.58688267143572,
          "returned_count": 3,
          "relevant_found": 2
        },
        "q2": {
          "precision_at_k": 0.3333333333333333,
          "recall_at_k": 0.5,
          "ndcg_at_k": 0.35195904451706733,
          "returned_count": 3,
          "relevant_found": 1
        },
        "q3": {
          "precision_at_k": 0.0,
          "recall_at_k": null,
          "ndcg_at_k": null,
          "returned_count": 2,
          "relevant_found": 0
        }
      },
      "mean_over_positive_judgment_queries": {
        "precision_at_k": 0.5,
        "recall_at_k": 0.75,
        "ndcg_at_k": 0.46942085797639366
      },
      "positive_queries": 2,
      "no_relevant_query_returned_count": 2
    },
    "B": {
      "queries": {
        "q1": {
          "precision_at_k": 0.6666666666666666,
          "recall_at_k": 1.0,
          "ndcg_at_k": 1.0,
          "returned_count": 3,
          "relevant_found": 2
        },
        "q2": {
          "precision_at_k": 0.6666666666666666,
          "recall_at_k": 1.0,
          "ndcg_at_k": 0.9134015924715543,
          "returned_count": 3,
          "relevant_found": 2
        },
        "q3": {
          "precision_at_k": 0.0,
          "recall_at_k": null,
          "ndcg_at_k": null,
          "returned_count": 0,
          "relevant_found": 0
        }
      },
      "mean_over_positive_judgment_queries": {
        "precision_at_k": 0.6666666666666666,
        "recall_at_k": 1.0,
        "ndcg_at_k": 0.9567007962357772
      },
      "positive_queries": 2,
      "no_relevant_query_returned_count": 0
    }
  },
  "checks": {
    "manual_precision_case": true,
    "manual_recall_case": true,
    "ideal_ranking_ndcg": true,
    "ndcg_cross_checked_with_sklearn": true,
    "no_relevance_policy": true,
    "fixed_k_for_short_list": true,
    "duplicates_and_unknown_ids_rejected": true
  }
}
تمرین اول: فهرست A برای پرسش اول، دو نتیجهٔ مرتبط در سه جایگاه اول دارد و هر دو سند مرتبطِ مجموعه را یافته است. Precision@3 و Recall@3 چه هستند؟ پاسخ: Precision برابر دو سوم و Recall برابر یک است. این دو عدد به مخرجهای متفاوت اشاره میکنند و یکسان نبودن آنها خطای محاسباتی نیست.
تمرین دوم: چرا Precision@3 پرسش اول برای A و B برابر است، اما nDCG آنها تفاوت دارد؟ پاسخ: هر دو دو نتیجهٔ مرتبط دارند، ولی B سند با درجهٔ سه را در جایگاه اول میآورد. nDCG علاوه بر درجهٔ ارتباط، موقعیت را نیز لحاظ میکند. مقدار یک برای B فقط نشاندهندهٔ ترتیب ایدئال همان پرسش و همان قرارداد است.
تمرین سوم: اگر فقط d1 بازگردد، Precision@3 در این کد چه میشود؟ پاسخ: یک سوم؛ مخرج قراردادی سه است. اگر گزارش دیگری مخرج را تعداد واقعی نتایج بگیرد، عدد متفاوتی میدهد. نام معیار بهتنهایی برای مقایسهٔ گزارشها کافی نیست و قرارداد فهرست کوتاه نیز باید مشخص باشد.
تمرین چهارم: برای پرسش سوم چرا Recall و nDCG مقدار null دارند؟ پاسخ: سند مرتبطی در قضاوتهای این مجموعه وجود ندارد و مخرج مناسب تعریف نمیشود. در قرارداد این مثال، این پرسش از میانگین پرسشهای مثبت کنار گذاشته میشود؛ تعداد نتیجهٔ بازگشتی آن جدا ثبت میشود. فهرست A دو نتیجه و B صفر نتیجه بازمیگرداند. این سیاست باید در گزارش روشن بماند.
۵. معیار را با وظیفه و نسخهٔ نمایه هماهنگ کنید
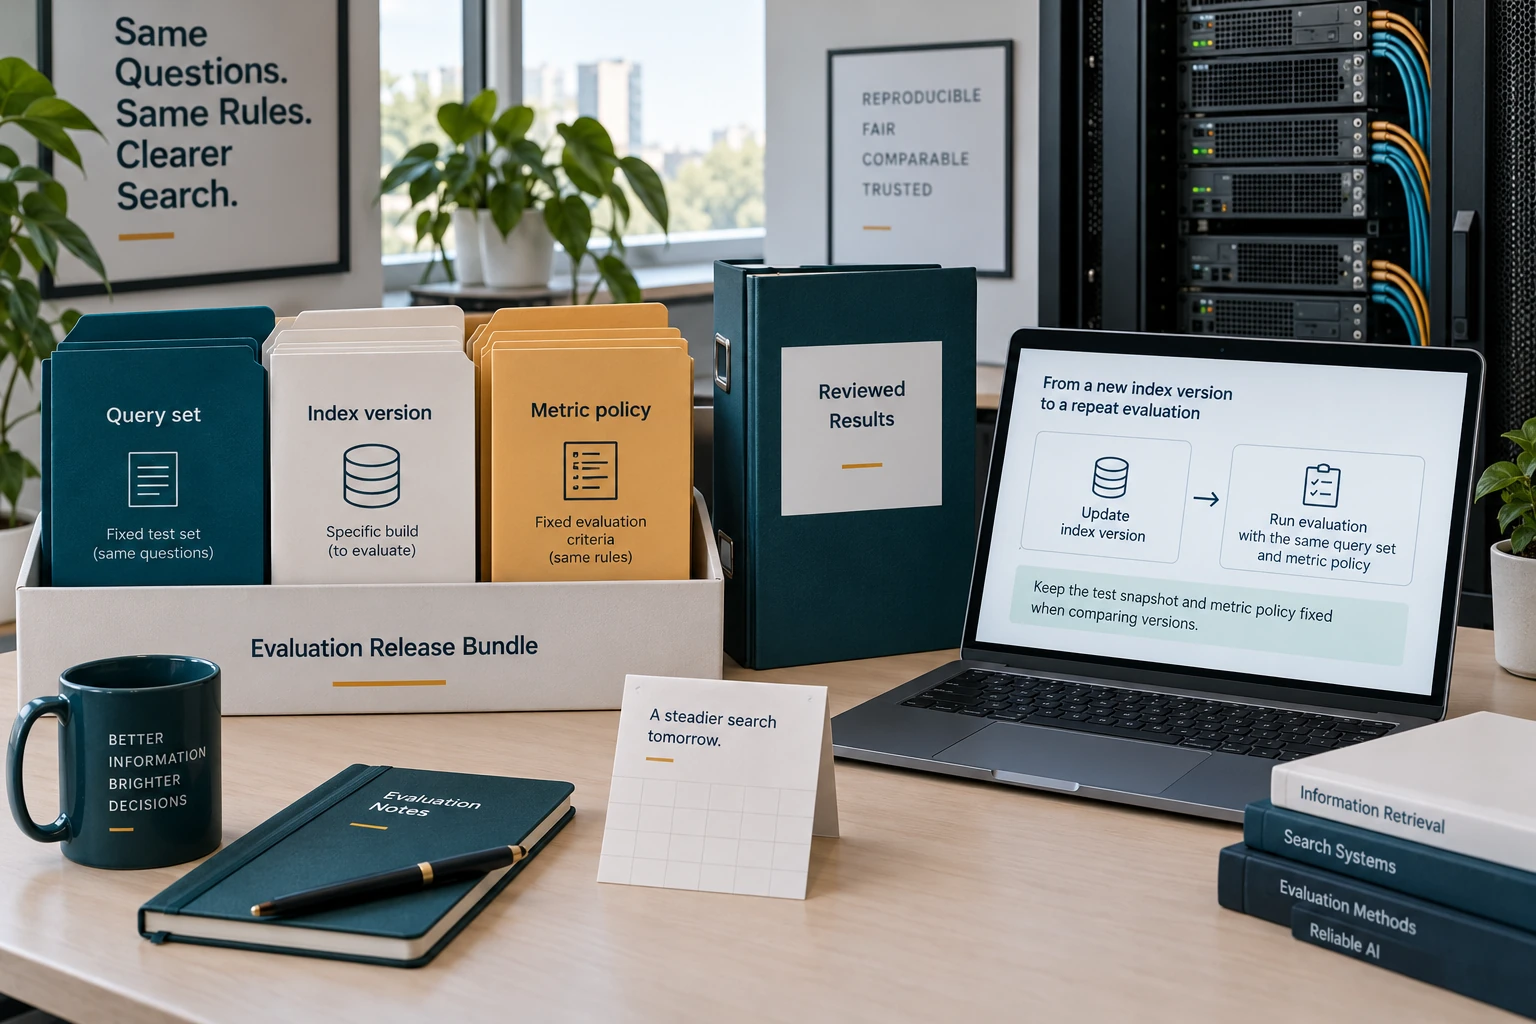
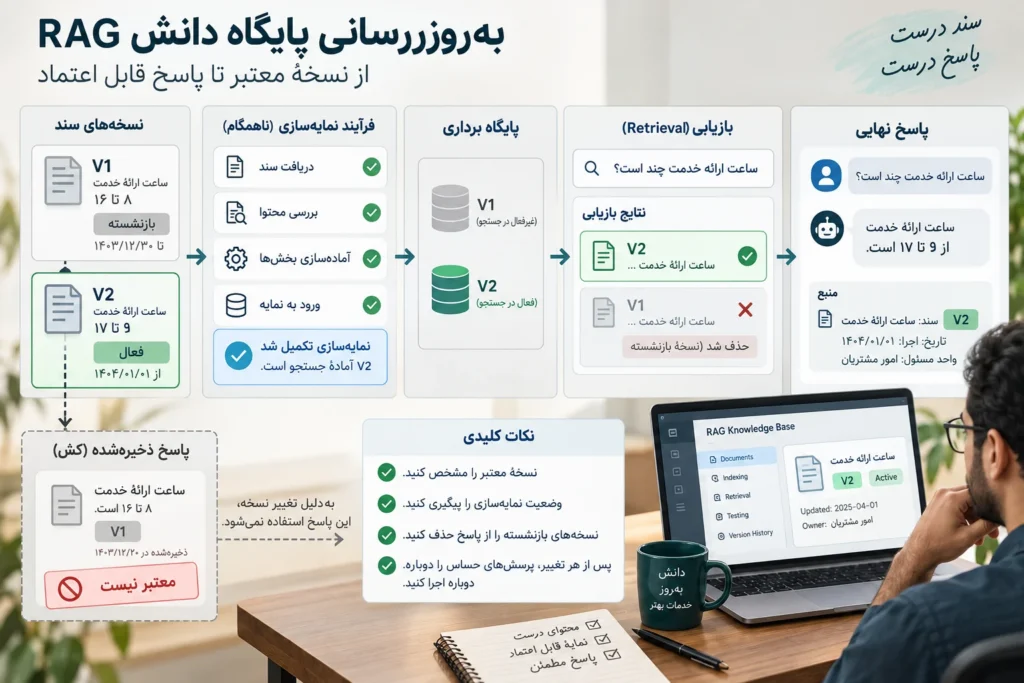
برای مقایسهٔ دو نسخه، مجموعهٔ پرسش، قضاوتها، قرارداد معیار و نسخهٔ سندها را ثبت کنید. پس از تغییر نمایه، حذف سند یا تغییر پیشپردازش، معلوم باشد آیا همان آزمایش تکرار شده یا مجموعهٔ ورودی نیز تغییر کرده است. مقالهٔ بازبینی نمایه پس از تغییر دانش سازمانی به همین مرحلهٔ مرتبط در بهرهبرداری میپردازد.
در گزارش پژوهشی Retrieve-for-Train، منتشرشده در ۱۵ سپتامبر ۲۰۲۶ توسط Google Research، نویسندگان بازیابی مجموعهای از نتایج را با توجه به ویژگیهایی مانند تنوع و هماهنگی با پرسش بررسی میکنند. برداشت کاربردی برای طراحی آزمون ما این است که «نتیجهٔ خوب» باید با وظیفهٔ کاربر تعریف شود. مثال حاضر اجرای آن پژوهش نیست و ادعای سرعت یا کیفیت آن را به محصول دیگری منتقل نمیکند.
گزارش عملی را با مثالهای شکست همراه کنید: پرسش بیپاسخ، سند همنام ولی بیارتباط، نتیجهٔ تکراری، سند خارج از دسترسی کاربر و فهرست کوتاه. معیارهای ارتباط، بهتنهایی تأخیر، تازگی سند، دسترسی مجاز یا کیفیت پاسخ تولیدشده را نمیسنجند. در سامانهٔ متکی بر هوش مصنوعی، ارزیابی بازیابی و ارزیابی پاسخ را جدا ثبت کنید تا علت خطا قابل بررسی باشد.
منابع و مطالعهٔ بیشتر
- معیارهای Precision و Recall؛ کتاب بازیابی اطلاعات دانشگاه استنفورد
- ارزیابی نتایج رتبهبندیشده؛ کتاب بازیابی اطلاعات استنفورد
- nDCG در scikit-learn
- DCG در scikit-learn
- گزارش پژوهش Retrieve-for-Train؛ Google Research
بررسی منابع: ۲۲ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.