فهرست مقاله
پاسخگوی تلفنی هوشمند فقط نباید جملهای روان تولید کند؛ باید بداند چه زمانی ادامهٔ پاسخ خودکار مناسب نیست و تماس باید به کارشناس برسد. برای بررسی این تصمیم، میتوان یک وظیفهٔ دوحالتی تعریف کرد: «ارجاع لازم است» یا «ارجاع لازم نیست». در این آموزش یک آزمایش کوچک و کاملاً مصنوعی میسازیم تا اثر آستانه، تعریف خطا و هزینهٔ تصمیم روشن شود. هیچ تماس واقعی، مدل آموزشدیده یا خروجی محصول شرکت در این مثال وجود ندارد. هدف، ساختن روشی قابل بازبینی برای تحلیل تصمیم است؛ روشی که بعداً با داده و معیارهای معتبر سازمان تکمیل میشود.
۱. امتیاز مدل با تصمیم ارجاع یکسان نیست
فرض کنید یک سامانه برای هر تماس عددی بین صفر و یک برمیگرداند. بزرگتر بودن عدد صرفاً یعنی گرایش بیشتر به ارجاع در قرارداد این مثال؛ عدد ۰٫۸ را احتمال ۸۰ درصدی معنا نمیکنیم. برای چنین تعبیر احتمالاتی باید کالیبراسیون و دادهٔ مناسب جداگانه بررسی شوند. مطابق راهنمای تنظیم آستانهٔ scikit-learn، تولید امتیاز و تبدیل آن به اقدام دو مسئلهٔ متفاوتاند. ما برای سادگی قانون «امتیاز بزرگتر یا مساوی آستانه» را انتخاب میکنیم؛ این قرارداد برابری را نیز صریحاً آزمایش خواهیم کرد.
برچسب مرجع یک یعنی بازبین انسانیِ فرضی، ارجاع را لازم میداند و صفر یعنی لازم نمیداند. در یک پروژهٔ واقعی باید دستورالعمل برچسبگذاری روشن باشد: خارج بودن سؤال از اختیار سامانه، نبود منبع کافی یا درخواست مستقیم تماسگیرنده میتوانند دلایل متفاوتی باشند. همهٔ این دلایل را نباید بدون بررسی در یک امتیاز مبهم ادغام کرد. همچنین خطای تشخیص گفتار با خطای ارجاع یکسان نیست؛ برای آن مسئله، راهنمای ارزیابی تشخیص گفتار فارسی را جدا بخوانید.
۲. چهار حالت خطا و هزینهٔ قابل توضیح
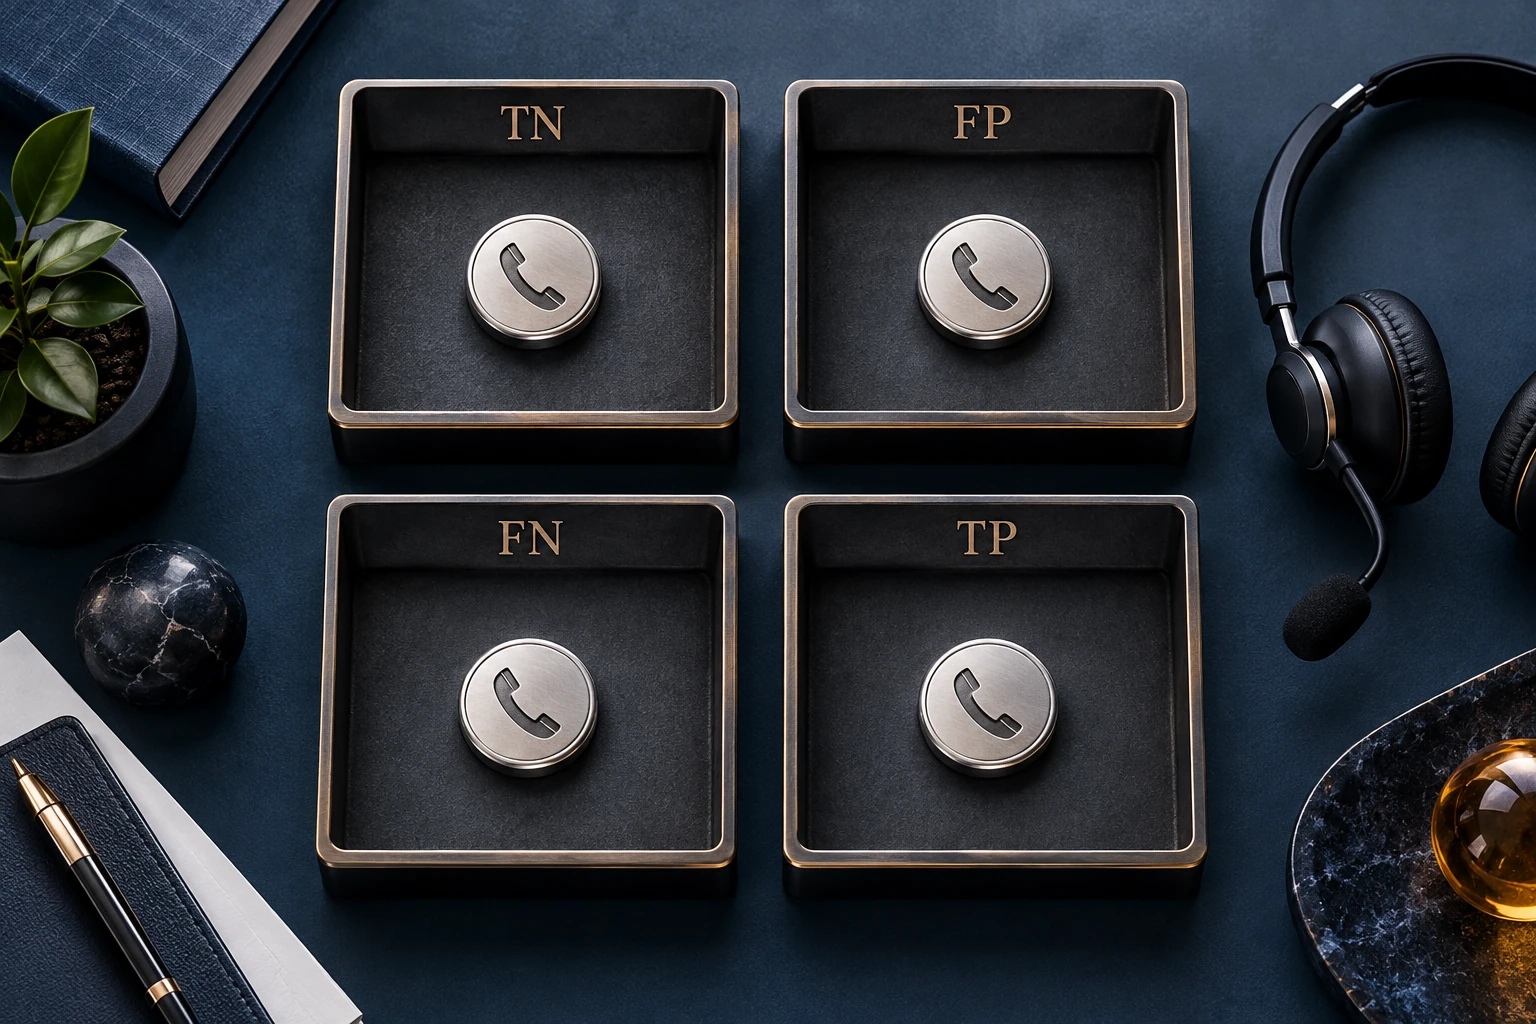
در ماتریس این آموزش، سطر برچسب واقعی و ستون تصمیم سامانه است و ترتیب هر دو محور صفر، سپس یک است. این همان قرارداد مرجع confusion_matrix است: خانهٔ بالا چپ TN، بالا راست FP، پایین چپ FN و پایین راست TP. مثبت کاذب یعنی تماس بینیاز از ارجاع را به کارشناس فرستادهایم؛ منفی کاذب یعنی تماس نیازمند کارشناس را خودکار نگه داشتهایم. تغییر معنای برچسب مثبت، معنای تمام این تعبیرها را تغییر میدهد.
هزینهٔ آموزشی را با رابطهٔ C = cFP × FP + cFN × FN تعریف میکنیم. در حالت نخست، هزینهٔ مثبت کاذب یک و هزینهٔ منفی کاذب پنج واحد قراردادی است. این اعداد پول، ثانیه، نرخ قانونی یا پیشنهاد عملیاتی برای سازمان شما نیستند. هزینهٔ واقعی به ظرفیت کارشناسان، نوع درخواست و پیامد پاسخ اشتباه وابسته است؛ حتی ممکن است جمع سادهٔ دو هزینه برای آن کافی نباشد. مشخص کردن فرضها پیش از دیدن نتیجه، از انتخاب معیاری که فقط خروجی فعلی را زیبا نشان دهد جلوگیری میکند.
در ده تماس مصنوعیِ اعتبارسنجی، سه تماس برچسب یک دارند. سامانهای که همیشه صفر بگوید، Accuracy برابر ۷۰ درصد میگیرد اما هیچکدام از سه ارجاع لازم را پیدا نمیکند و هزینهاش ۱۵ واحد است. بنابراین صحت کلی بهتنهایی پاسخ مسئله را نمیدهد. Precision سهم ارجاعهای واقعاً لازم از همهٔ ارجاعهای انجامشده و Recall سهم موارد پیداشده از تمام ارجاعهای لازم است. تعریف ریاضی این دو نسبت در مرجع معیارهای scikit-learn آمده است. وقتی هیچ ارجاعی انجام نشده، مخرج Precision صفر است؛ کد ما مقدار None برمیگرداند تا نامعین بودن را پنهان نکند.
۳. کد کامل و انتخاب آستانه فقط با اعتبارسنجی
کد زیر فقط به کتابخانهٔ استاندارد پایتون وابسته است. در این نوبت با Python 3.14.5 اجرا شده و نه گروه بررسی آن موفق بودهاند؛ scikit-learn در این اجرای محلی نصب یا اجرا نشده است و مستندات آن صرفاً مرجع تعریفها هستند. سه آستانهٔ ۰٫۲۵، ۰٫۵۰ و ۰٫۷۵ از قبل تعیین شدهاند. انتخابگر تنها برچسب و امتیاز مجموعهٔ اعتبارسنجی را دریافت میکند. اگر هزینه مساوی شود، ابتدا مثبت کاذب کمتر و سپس آستانهٔ بالاتر را ترجیح میدهیم؛ این ترتیب نیز قرارداد ازپیشنوشتهٔ همین تمرین است.
در کاربرد واقعی، آموزش مدل، تنظیم آستانه و گزارش نهایی باید دادههای مستقل و طراحی متناسب با مسئله داشته باشند. مستندات رسمی دربارهٔ تنظیم روی همان دادهٔ آموزش هشدار میدهند. در مثال حاضر اصلاً آموزش انجام نمیشود؛ امتیازها دستی و صرفاً برای قابلمحاسبه بودن ساخته شدهاند. نمونههای آزمون پس از انتخاب آستانه ارزیابی میشوند و در ورودی انتخابگر حضور ندارند. این جداسازی را با راهنمای ارزیابی سامانهٔ هوش مصنوعی تکمیل کنید.
"""Authored synthetic call-triage exercise; no trained model or real call data."""
import json
import math
import platform


def binary_report(labels, scores, threshold, *, fp_cost=1, fn_cost=5):
    if not labels or len(labels) != len(scores):
        raise ValueError('Nonempty, aligned labels and scores required')
    if any(type(y) is not int or y not in (0, 1) for y in labels):
        raise ValueError('Labels must be integer 0 or 1')
    numbers = [*scores, threshold, fp_cost, fn_cost]
    if any(type(x) not in (int, float) or not math.isfinite(x) for x in numbers):
        raise ValueError('Finite real scores, threshold and costs required')
    if any(not 0 <= x <= 1 for x in [*scores, threshold]):
        raise ValueError('Scores and threshold must lie in [0, 1]')
    if fp_cost < 0 or fn_cost < 0:
        raise ValueError('Costs cannot be negative')
    predictions = [int(s >= threshold) for s in scores]
    tn = sum(y == 0 and p == 0 for y, p in zip(labels, predictions))
    fp = sum(y == 0 and p == 1 for y, p in zip(labels, predictions))
    fn = sum(y == 1 and p == 0 for y, p in zip(labels, predictions))
    tp = sum(y == 1 and p == 1 for y, p in zip(labels, predictions))
    return {
        'threshold': threshold, 'matrix_true_rows_pred_cols': [[tn, fp], [fn, tp]],
        'tn': tn, 'fp': fp, 'fn': fn, 'tp': tp,
        'accuracy': (tn + tp) / len(labels),
        'precision': tp / (tp + fp) if tp + fp else None,
        'recall': tp / (tp + fn) if tp + fn else None,
        'cost_units': fp_cost * fp + fn_cost * fn,
    }


def choose_threshold(validation_labels, validation_scores, candidates, **costs):
    if not candidates:
        raise ValueError('At least one candidate threshold required')
    reports = [binary_report(validation_labels, validation_scores, t, **costs)
               for t in candidates]
    # Predeclared tie policy: lower cost, fewer false positives, higher threshold.
    chosen = min(reports, key=lambda r: (r['cost_units'], r['fp'], -r['threshold']))
    return chosen['threshold'], reports


def rejects(function):
    try:
        function()
    except ValueError:
        return True
    return False


def run_example():
    # 1 means a synthetic reference reviewer requires a human handoff.
    validation_y = [1, 1, 1, 0, 0, 0, 0, 0, 0, 0]
    validation_s = [.90, .70, .40, .80, .60, .35, .20, .10, .05, .02]
    candidates = [.25, .50, .75]
    selected, validation = choose_threshold(validation_y, validation_s, candidates)
    # Test fixtures are evaluated AFTER selection and cannot enter the selector.
    test_y = [1, 1, 0, 0, 0, 0, 0, 0]
    test_s = [.85, .20, .70, .30, .22, .10, .05, .01]
    test = binary_report(test_y, test_s, selected)
    test_default = binary_report(test_y, test_s, .50)
    expensive_fp, other_validation = choose_threshold(
        validation_y, validation_s, candidates, fp_cost=4, fn_cost=1)
    baseline = binary_report(validation_y, [0.] * 10, .50)
    boundary = binary_report([0, 1], [.49, .50], .50)
    reversed_report = binary_report(validation_y[::-1], validation_s[::-1], .25)
    tie, _ = choose_threshold([0], [.10], [.25, .75])
    checks = {
        'validation_counts_match_hand_calculation':
            [r['matrix_true_rows_pred_cols'] for r in validation] ==
            [[[4, 3], [0, 3]], [[5, 2], [1, 2]], [[6, 1], [2, 1]]],
        'validation_costs_and_selection_match':
            [r['cost_units'] for r in validation] == [3, 7, 11] and selected == .25,
        'held_out_test_counts_and_cost_match':
            test['matrix_true_rows_pred_cols'] == [[4, 2], [1, 1]] and
            test['cost_units'] == 7 and test['accuracy'] == .625 and
            math.isclose(test['precision'], 1 / 3) and test['recall'] == .5,
        'changed_costs_change_validation_choice':
            expensive_fp == .75 and [r['cost_units'] for r in other_validation] == [12, 9, 6],
        'all_negative_precision_is_undefined':
            baseline['accuracy'] == .7 and baseline['precision'] is None and baseline['recall'] == 0,
        'equality_is_positive_and_tie_policy_fixed':
            boundary['tp'] == 1 and boundary['tn'] == 1 and tie == .75,
        'paired_permutation_preserves_metrics': reversed_report == validation[0],
        'invalid_input_contracts_rejected': all([
            rejects(lambda: binary_report([], [], .5)),
            rejects(lambda: binary_report([1], [], .5)),
            rejects(lambda: binary_report([2], [.1], .5)),
            rejects(lambda: binary_report([True], [.1], .5)),
            rejects(lambda: binary_report([1], [float('nan')], .5)),
            rejects(lambda: binary_report([1], [float('inf')], .5)),
            rejects(lambda: binary_report([1], [1.1], .5)),
            rejects(lambda: binary_report([1], [.1], -.1)),
            rejects(lambda: binary_report([1], [.1], .5, fp_cost=-1)),
            rejects(lambda: choose_threshold([1], [.1], [])),
        ]),
        'selection_not_rewritten_to_improve_test_result':
            selected == .25 and test_default['cost_units'] == 6 < test['cost_units'],
    }
    if not all(checks.values()):
        raise AssertionError(checks)
    return {
        'python': platform.python_version(), 'dependencies': 'Python standard library only',
        'fixture': 'Authored synthetic scores, not model probabilities or real call outcomes',
        'positive_label': 'human_handoff_required', 'decision_rule': 'score >= threshold',
        'cost_unit': 'arbitrary teaching unit, not currency or duration',
        'validation': validation, 'selected_threshold': selected,
        'held_out_test': test, 'held_out_test_at_default_0_5': test_default,
        'validation_with_fp_cost_4_fn_cost_1': other_validation,
        'all_negative_baseline': baseline, 'checks': checks,
    }


if __name__ == '__main__':
    print(json.dumps(run_example(), indent=2))
۴. خروجی اجرا و دلیل بهتر نبودن تضمینی آستانه
محاسبهٔ دستی اعتبارسنجی را کنار خروجی کد بگذارید. در آستانهٔ ۰٫۲۵، مقادیر TN=4، FP=3، FN=0 و TP=3 هستند و هزینه سه واحد است. در آستانهٔ ۰٫۵۰، شمارشها بهترتیب ۵، ۲، ۱ و ۲ میشوند و هزینه هفت است. در آستانهٔ ۰٫۷۵، شمارشها ۶، ۱، ۲ و ۱ و هزینه یازده است. Accuracy در هر سه حالت ۰٫۷ باقی میماند، اما Recall از یک به دوسوم و سپس یکسوم تغییر میکند. پس برابر بودن یک معیار به معنای برابر بودن تصمیمها نیست.
با هزینههای نخست، آستانهٔ انتخابی ۰٫۲۵ است. روی هشت تماس مستقلِ مصنوعیِ آزمون، نتیجه TN=4، FP=2، FN=1 و TP=1 میشود: Accuracy برابر ۰٫۶۲۵، Precision برابر یکسوم، Recall برابر ۰٫۵ و هزینه هفت واحد است. برای مقایسهٔ ازپیشتعریفشده، آستانهٔ ۰٫۵۰ روی همان آزمون هزینه شش دارد. این نتیجهٔ نامطلوب را پنهان نمیکنیم و آستانه را پس از دیدن آزمون عوض نمیکنیم؛ چنین تغییری آزمون را به بخشی از تنظیم تبدیل میکند. انتخاب خوب در اعتبارسنجی، برتری تضمینشده در دادهٔ دیگر نمیآورد.
اگر هزینهها را در اعتبارسنجی به cFP=4 و cFN=1 تغییر دهیم، هزینهٔ سه گزینه بهترتیب ۱۲، ۹ و ۶ میشود و انتخاب به ۰٫۷۵ جابهجا میشود. این خروجی، اثر تابع تصمیم را نشان میدهد؛ ادعای شناخت هزینههای واقعی تماس نیست. دادهٔ بسیار کوچک، نبود مدل واقعی و امتیازهای دستی اجازهٔ برآورد کیفیت عملیاتی، فاصلهٔ اطمینان معنادار برای محصول یا ادعای کاهش هزینهٔ شرکت را نمیدهند.
۵. تمرینهای حلشده و مرز انتشار عملیاتی
تمرین اول: در آستانهٔ ۰٫۵۰ و هزینههای نخست، چرا هزینه هفت است؟ پاسخ: دو مثبت کاذب هرکدام یک واحد و یک منفی کاذب پنج واحد دارد؛ بنابراین ۲×۱ + ۱×۵ = ۷. تمرین دوم: امتیاز دقیقاً برابر ۰٫۵۰ چگونه طبقهبندی میشود؟ پاسخ: با قرارداد بزرگتر یا مساوی این کد، مثبت است. این رفتار را نباید از نام یک تابع حدس زد؛ مقایسهٔ مرزی در کد بهصورت مستقل بررسی شده است.
تمرین سوم: آیا هزینهٔ شش در آزمون کافی است که آستانه را فوراً به ۰٫۵۰ تغییر دهیم؟ پاسخ: خیر؛ آزمون برای گزارش کنار گذاشته شده بود. برای چرخهٔ اصلاح، باید فرض تازه را ثبت و با اعتبارسنجی مناسب و مجموعهٔ نهایی دستنخورده بررسی کرد. تمرین چهارم: Precision سامانهٔ همیشهمنفی چقدر است؟ پاسخ: در این قرارداد نامعین و معادل None است؛ Recall صفر و Accuracy هفتدهم است. نداشتن مثبت کاذب را نباید با مفید بودن سامانه اشتباه گرفت.
پیش از استفادهٔ واقعی، مجموعههای متنوع و دارای مجوز، اختلاف نظر برچسبگذاران، تغییر توزیع درخواستها، ظرفیت صف و امکان مداخلهٔ انسانی باید بررسی شوند. این کد هیچ تماس را منتقل نمیکند، متن یا صوت خصوصی دریافت نمیکند و ظرفیت مرکز تماس را شبیهسازی نمیکند. نه بررسیِ آن صحت شمارش، قرارداد ورودی، رفتار مرزی و جداسازی روش انتخاب را پوشش میدهند؛ تصاویر همراه نیز توضیح مفهومیاند و نمودار نتیجهٔ اجرای کد نیستند. ارزش این تمرین در روشن بودن فرض و امکان بازبینی است.
منابع و مطالعهٔ بیشتر
- تفکیک امتیاز مدل و تصمیم؛ تنظیم آستانه در scikit-learn
- تعریف جهت سطرها و ستونهای ماتریس درهمریختگی
- تعریف Precision و Recall و مدیریت مخرج صفر
بررسی منابع: ۲۳ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.