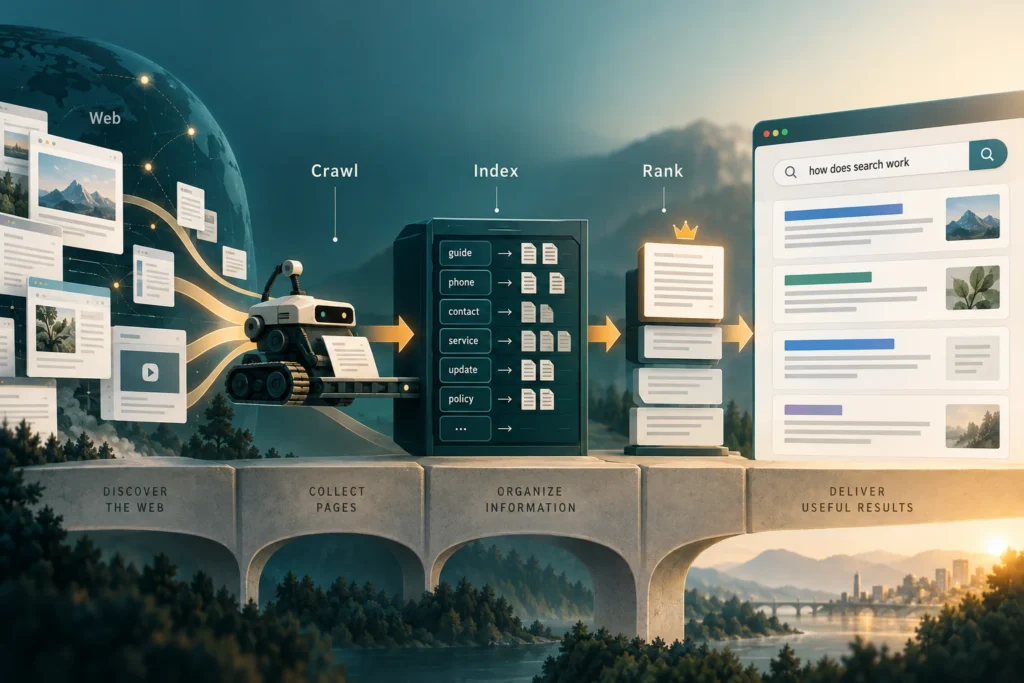
موتور جستوجو میان پرسش کاربر و مجموعهای از منابع ارتباط برقرار میکند. پشت صفحهٔ نتایج، دستکم سه مسئله وجود دارد: منابع چگونه پیدا میشوند، چه نمایهای برای بازیابی ساخته میشود و کدام نتیجه پیش از بقیه نمایش داده میشود؟ این مقاله این اجزا را با مثالهای کوچک توضیح میدهد و یک نقطهٔ مهم از تاریخ جستوجوی وب را بررسی میکند. موضوع، سازوکار عمومی است؛ الگوریتم همهٔ موتورهای جستوجو یا گزارش عملکرد محصول مشخصی نیست.
برای مقایسهٔ جستوجوی واژگانی، معنایی و پاسخ تولیدشده، ابتدا خروجی هر کدام را مشخص کنید. پیدا کردن یک سند با نوشتن پاسخی بر پایهٔ آن فرق دارد. ممکن است فهرست نتایج درست باشد اما پاسخ تولیدشده بخشی از منبع را نادیده بگیرد. از طرف دیگر، پاسخ روانی که هیچ شاهد مناسبی پشت آن نیست، موفقیت جستوجو محسوب نمیشود. این تفکیک، معیارهای ارزیابی و انتخاب معماری را روشنتر میکند.
۱. کشف منبع، نمایهسازی و نمایش نتیجه
راهنمای رسمی نحوهٔ کار جستوجوی گوگل سه مرحلهٔ کلی را بیان میکند: خزیدن، نمایهسازی و ارائهٔ نتایج. کشف نشانی میتواند از پیوندهای شناختهشده یا نقشهٔ سایت انجام شود. این توضیح دربارهٔ همان سامانه است و ضمانتی برای خزش، نمایه شدن یا رتبهٔ یک صفحه نمیدهد. در یک موتور اختصاصی نیز باید مشخص شود مجموعهٔ منابع چیست و کدام منابع اجازهٔ ورود به فرایند را دارند.
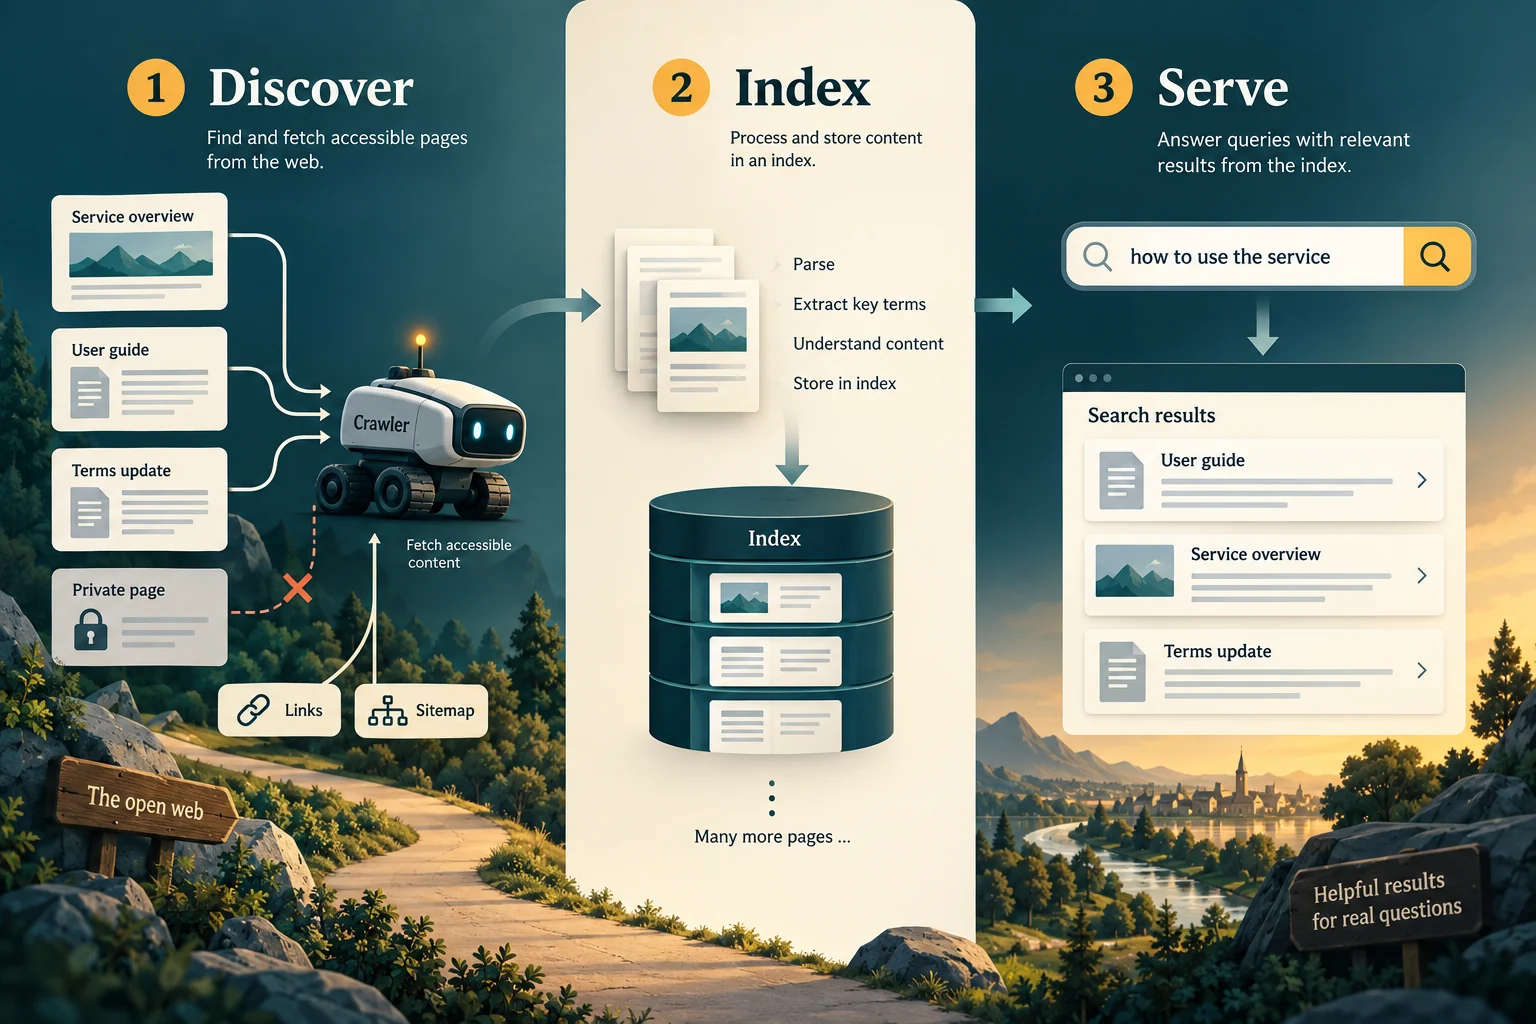
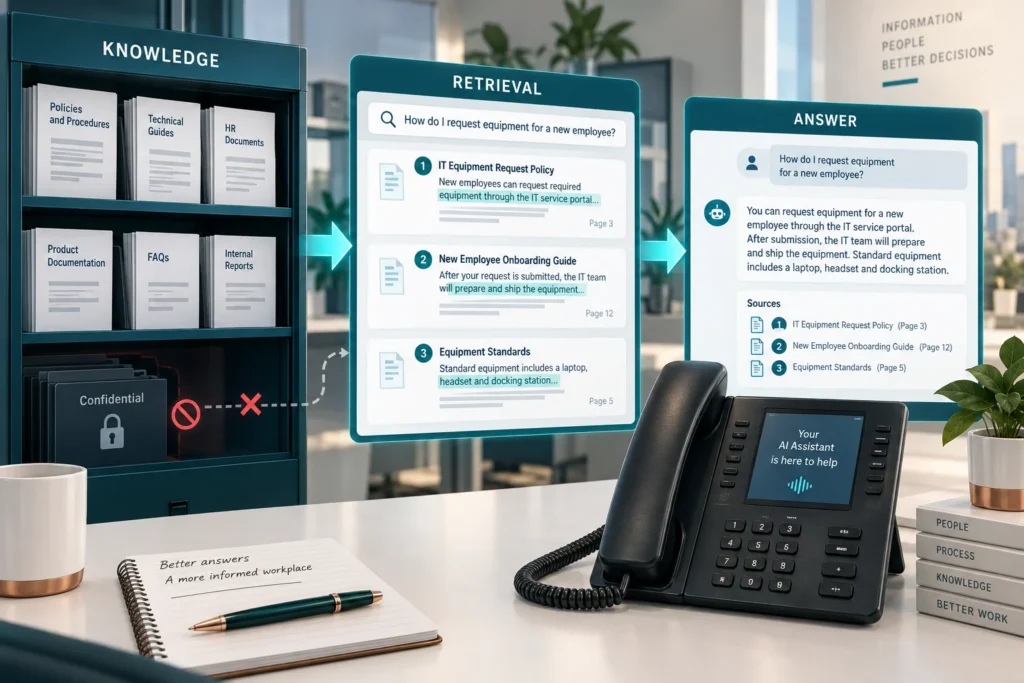
مثال فرضی را با سه صفحه آغاز کنید: معرفی خدمت، راهنمای استفاده و اطلاعیهٔ تغییر شرایط. ابتدا دریافت موفق متن را بررسی کنید، سپس ثبت نسخه در نمایه و در پایان رفتار پرسشهای نمونه را. اگر اطلاعیه دریافت نشده، عوض کردن روش رتبهبندی مشکل را حل نمیکند. برای هر مرحله یک وضعیت قابل مشاهده نگه دارید. صفحهٔ خصوصی یا اطلاعاتی که کاربر اجازهٔ دیدن آن را ندارد، نباید صرفاً به دلیل قابل دریافت بودن وارد نتایج عمومی شود.
۲. نمایهٔ معکوس؛ واژه به کدام سند میرسد؟
کتاب بازیابی اطلاعات استنفورد ساخت نمایهٔ معکوس را با جمعآوری سند، جداسازی واحدهای متن، نرمالسازی و ثبت رابطهٔ عبارت و شناسهٔ سند توضیح میدهد. در مثال سادهٔ این مقاله، اگر عبارت «تلفن» در دو سند باشد، نمایه برای آن عبارت فهرست همان دو شناسه را نگه میدارد. هدف این سازماندهی، جلوگیری از خواندن دوبارهٔ همهٔ اسناد برای هر پرسش است. این مثال آموزشی، همهٔ جزئیات یک نمایهٔ عملیاتی را نمایش نمیدهد.
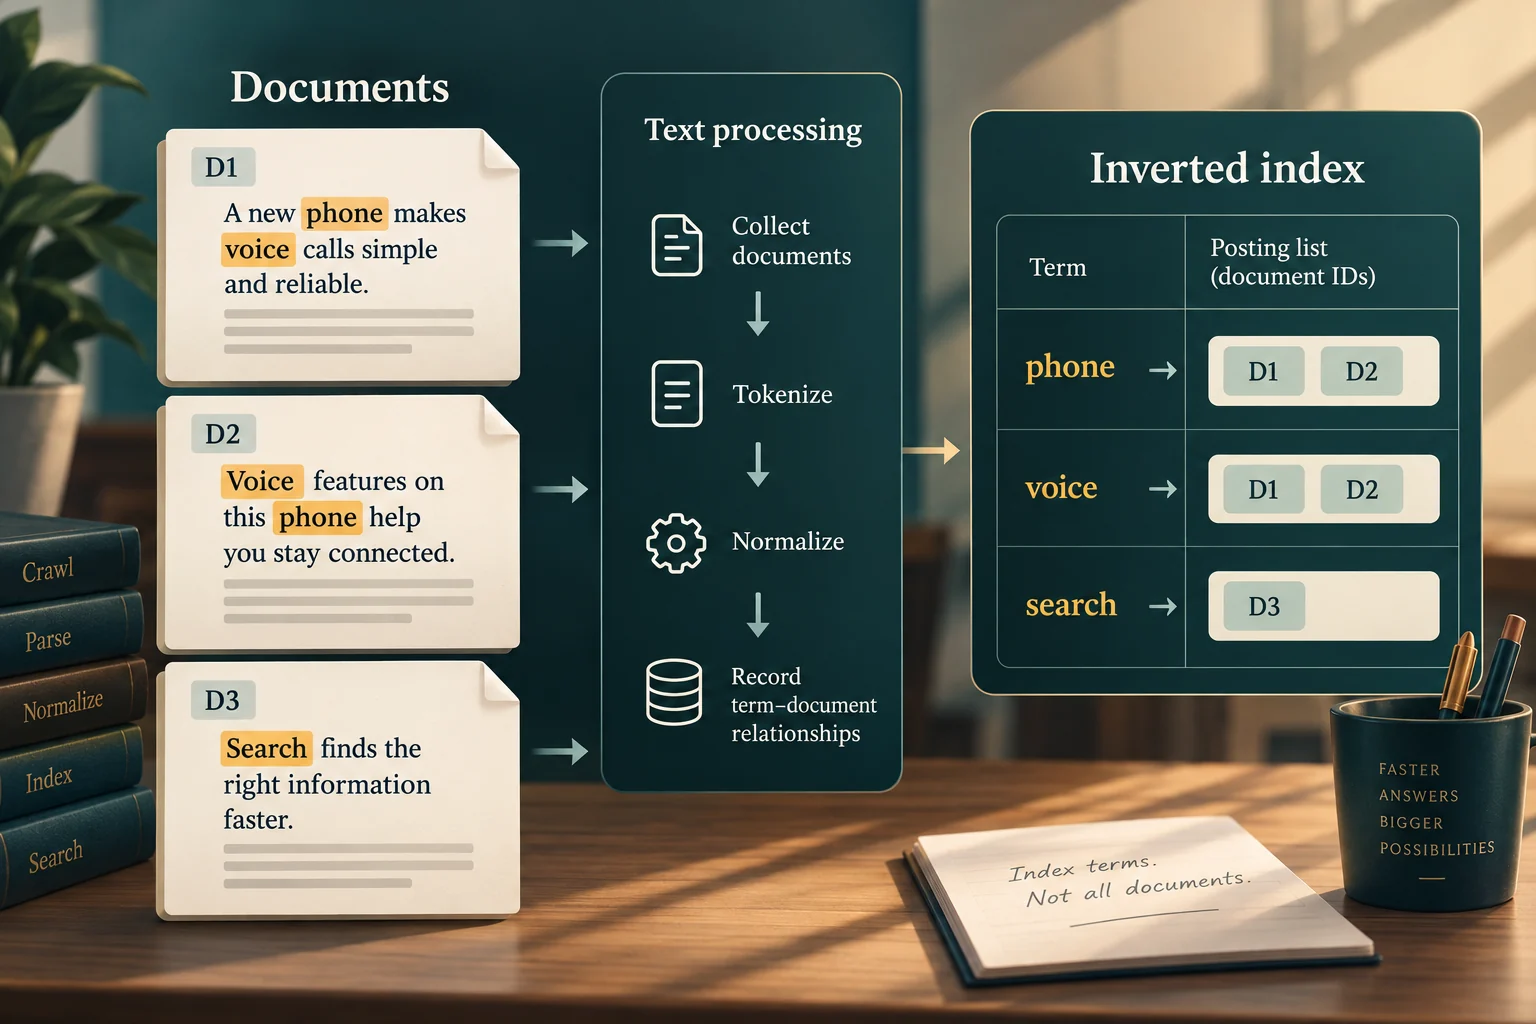
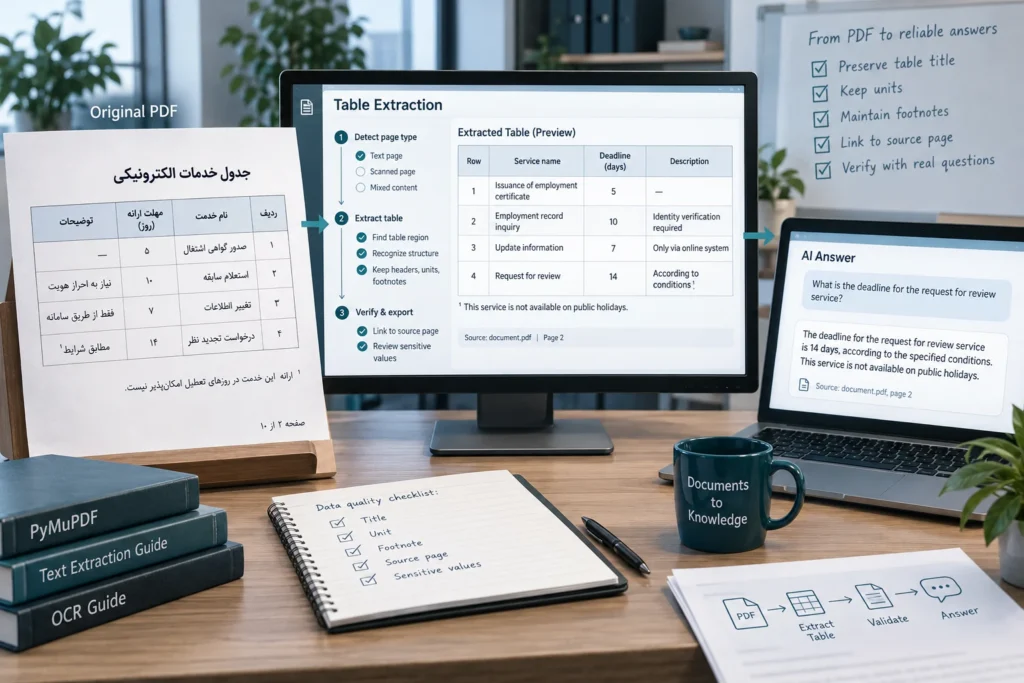
برای متن فارسی، تصمیم دربارهٔ شکل نویسهها و نیمفاصله میتواند بر تطبیق اثر بگذارد. «هوشمند» و صورتهای نوشتاری یک ترکیب باید در مجموعهٔ آزمون باشند. نرمالسازی را با نمونههای واقعی همان مجموعه بررسی کنید؛ یکسانسازی بیش از حد هم ممکن است تمایز مفید را از بین ببرد. شناسهٔ پایدار سند و ثبت نسخه، پیگیری نتیجه را آسان میکنند. برای متن استخراجشده از PDF، ابتدا مطمئن شوید جدول و سطرها درست خوانده شدهاند؛ نمایهٔ سریع روی ورودی نادرست، نتیجهٔ معتبر ایجاد نمیکند.
۳. رتبهبندی وب؛ فراتر از وجود یک واژه
مقالهٔ معماری یک موتور جستوجوی بزرگ وب نوشتهٔ سرگئی برین و لارنس پیج، نمونهای تاریخی از توجه به متن و ساختار پیوندهای وب است. انتشار آن به اواخر دههٔ ۱۳۷۰ خورشیدی برمیگردد. مقاله یک نمونهٔ پژوهشی و معماری آن دوره را شرح میدهد؛ نباید از آن، توضیح کامل سامانهٔ امروزی گوگل را نتیجه گرفت. ارزش مطالعهٔ آن، دیدن تفاوت میان پیدا شدن یک سند و تصمیم دربارهٔ ترتیب نتایج است.
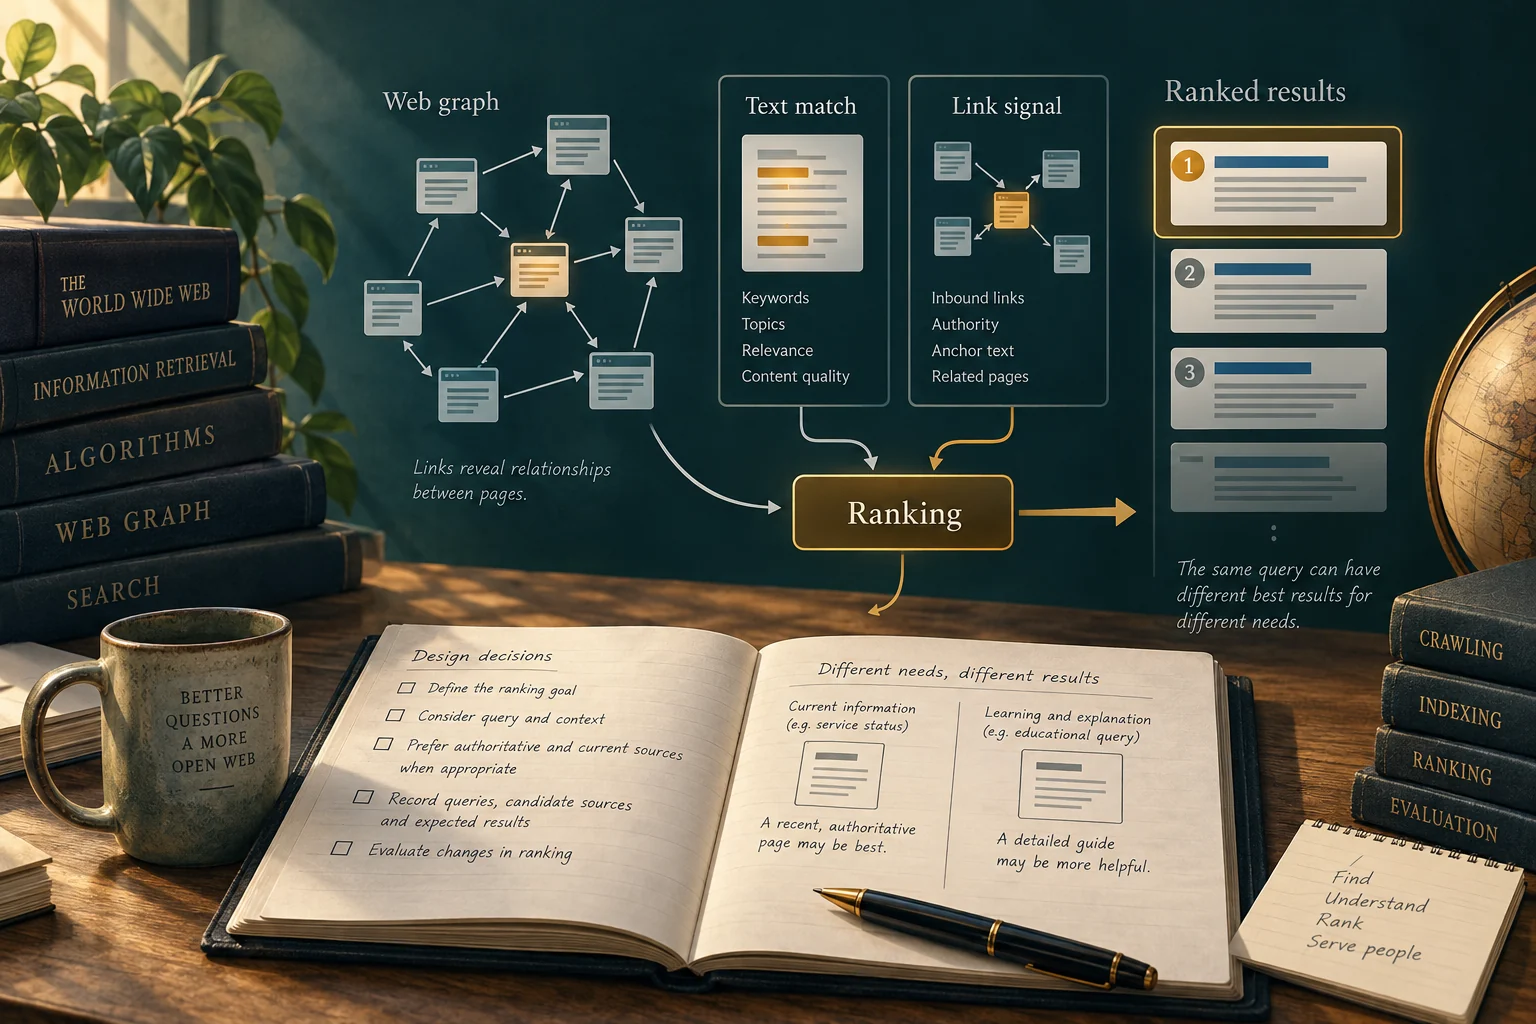
در طراحی موتور اختصاصی، بهجای تقلید یک معیار نامشخص، هدف رتبهبندی را تعریف کنید. برای پرسش دربارهٔ شرایط فعلی خدمت، سند معتبر و جاری ممکن است از یک متن قدیمی بلند مناسبتر باشد. برای پرسش آموزشی، یک راهنمای توضیحی میتواند اولویت دیگری داشته باشد. اینها مثال تصمیم طراحی هستند، نه قانون رتبهبندی همهٔ موتورهای وب. پرسش، مجموعهٔ منابع و پاسخ مورد انتظار را کنار هم ثبت کنید تا تغییر ترتیب نتایج قابل ارزیابی باشد.
۴. جستوجوی معنایی و پاسخ مبتنی بر شاهد
راهنمای بازیابی OpenAI جستوجوی معنایی بر پایهٔ نمایش برداری محتوا را توضیح میدهد. این رویکرد میتواند برای پرسشهایی مفید باشد که واژههای کاربر با متن منبع یکسان نیستند. با این حال، شباهت معنایی بهتنهایی اعتبار، تازگی یا مجاز بودن سند را ثابت نمیکند. در طراحی پیشنهادی، این قواعد مستقل باقی میمانند و نتایج بازیابی پیش از استفاده در پاسخ، با دامنهٔ کاربر و وضعیت منبع بررسی میشوند.
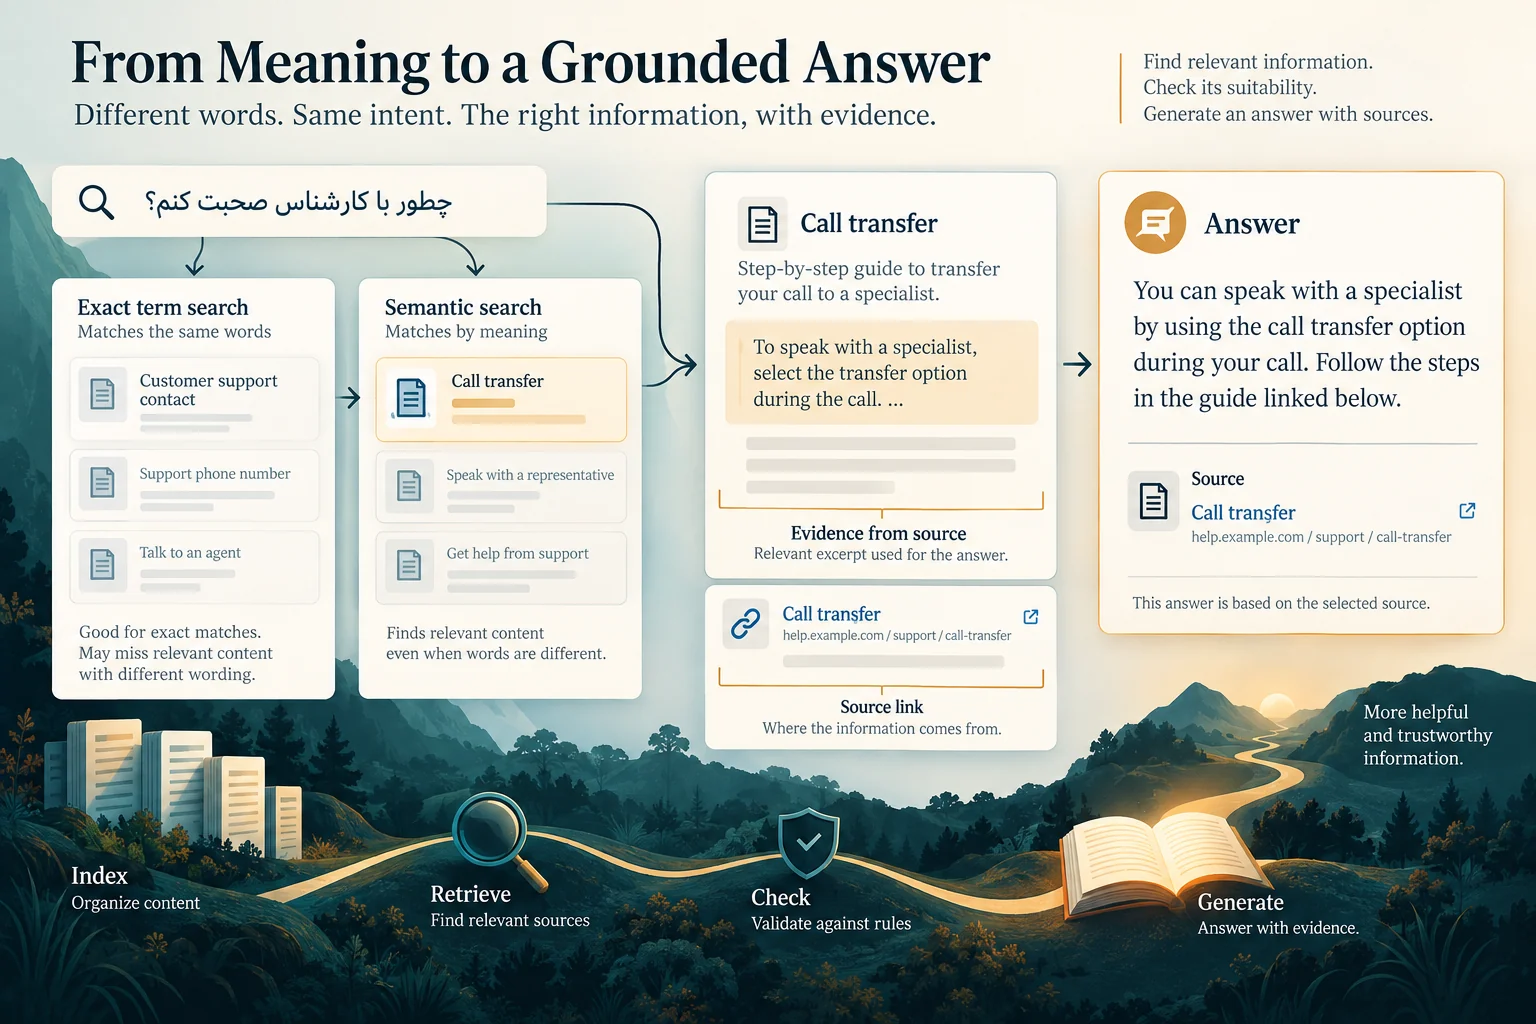
برای مقایسه، پرسش فرضی «چطور با کارشناس صحبت کنم؟» را کنار سندی با عنوان «انتقال تماس» قرار دهید. بازیابی واژگانی، معنایی یا ترکیبی را با همین نمونه و نمونههای متفاوت امتحان کنید. سپس در مسیر پاسخ مبتنی بر RAG بررسی کنید پاسخ واقعاً از شاهد منتخب استفاده کرده است یا خیر. مرحلهٔ بازیابی و مرحلهٔ تولید، معیارهای جدا میخواهند؛ یک پاسخ زیبا بهتنهایی دلیل درستی انتخاب منبع نیست.
۵. موتور اختصاصی را با تازگی و نتیجهٔ وظیفه بسنجید
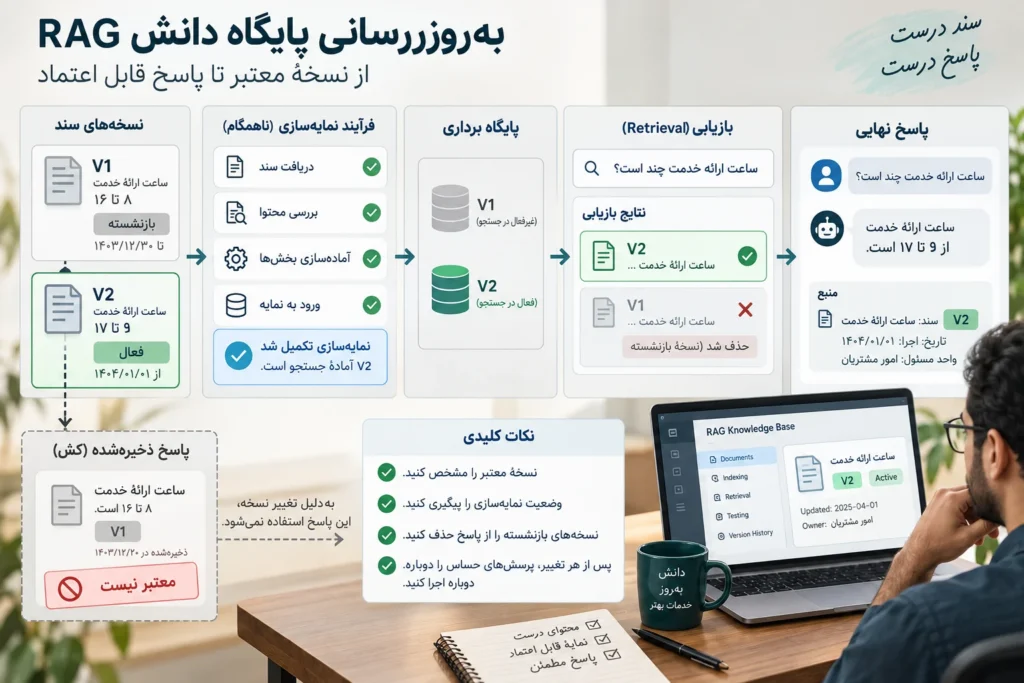
در موتور سازمانی، اضافه شدن سند جدید پایان کار نیست. باید بدانیم چه زمانی برای جستوجو آماده شده و نسخهٔ قبلی چگونه از پاسخ خارج میشود. راهنمای بهروزرسانی پایگاه دانش و نمایه این چرخه را بررسی میکند. برای ورودیهای جدولی هم آمادهسازی جدولهای PDF مفید است. خطای ورودی، خطای نمایه و خطای رتبهبندی را جدا ثبت کنید تا اصلاح دقیقاً به لایهٔ مرتبط برسد.
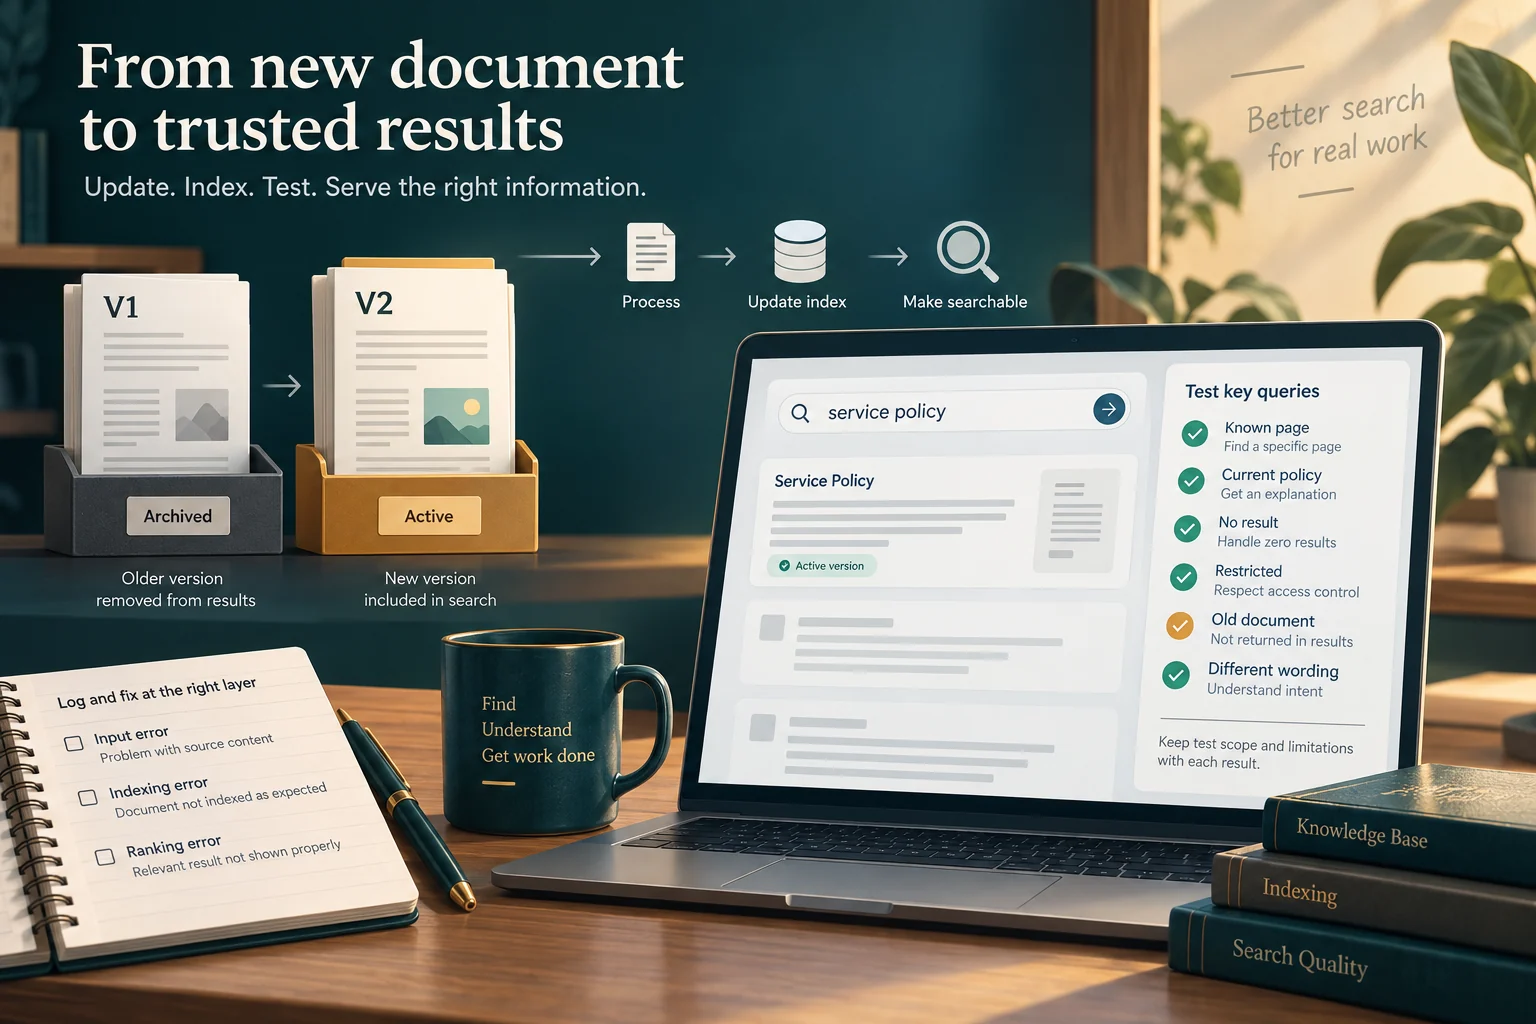
مجموعهٔ آزمون را از نیاز واقعی کاربر بسازید: یافتن صفحهٔ مشخص، دریافت توضیح و پیدا کردن شرایط معتبر خدمت. نمونهٔ بدون نتیجه، سند قدیمی، نوشتار متفاوت و دسترسی محدود را نیز اضافه کنید. برای معرفی حوزهٔ محصول، صفحهٔ موتور جستوجوی پیدا را ببینید. این مقاله وعدهٔ رتبه یا میزان دقت محصول نمیدهد؛ چارچوبی برای بررسی فرایند کشف، بازیابی و نمایش نتیجه ارائه میکند. دامنهٔ آزمون و محدودیتهای آن باید کنار هر نتیجهٔ ارزیابی باقی بمانند.
منابع و مطالعهٔ بیشتر
- نحوهٔ کار جستوجوی گوگل؛ مستندات رسمی
- ساخت نمایهٔ معکوس؛ کتاب بازیابی اطلاعات استنفورد
- مقالهٔ اصلی معماری موتور جستوجوی وب؛ برین و پیج
- جستوجوی معنایی؛ مستندات بازیابی OpenAI
بررسی منابع: ۲۲ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.