فهرست مقاله
اگر یک شناسه در انتهای قطعهٔ نخست آغاز و در قطعهٔ بعد تمام شود، جستوجوی جداگانهٔ هر قطعه میتواند آن را نبیند. تکرارهای همپوشان هم دامِ دیگری هستند: یافتن یک رخداد، دلیلِ حذف شروعهای داخل همان رخداد نیست. در این درس، KMP را برای یک الگوی ثابت و متنِ قطعهای پیاده میکنیم؛ حافظهٔ تطبیق و جایگاه مطلق را نگه میداریم و پاسخ را با جستوجوی مستقل میسنجیم. دادهها متنِ ساختگیاند، نه گزارش تجهیزات یا اجرای موتور جستوجوی شرکت.
۱. زیررشتهٔ دقیق را از واژه و پیشنهاد جدا کنیم
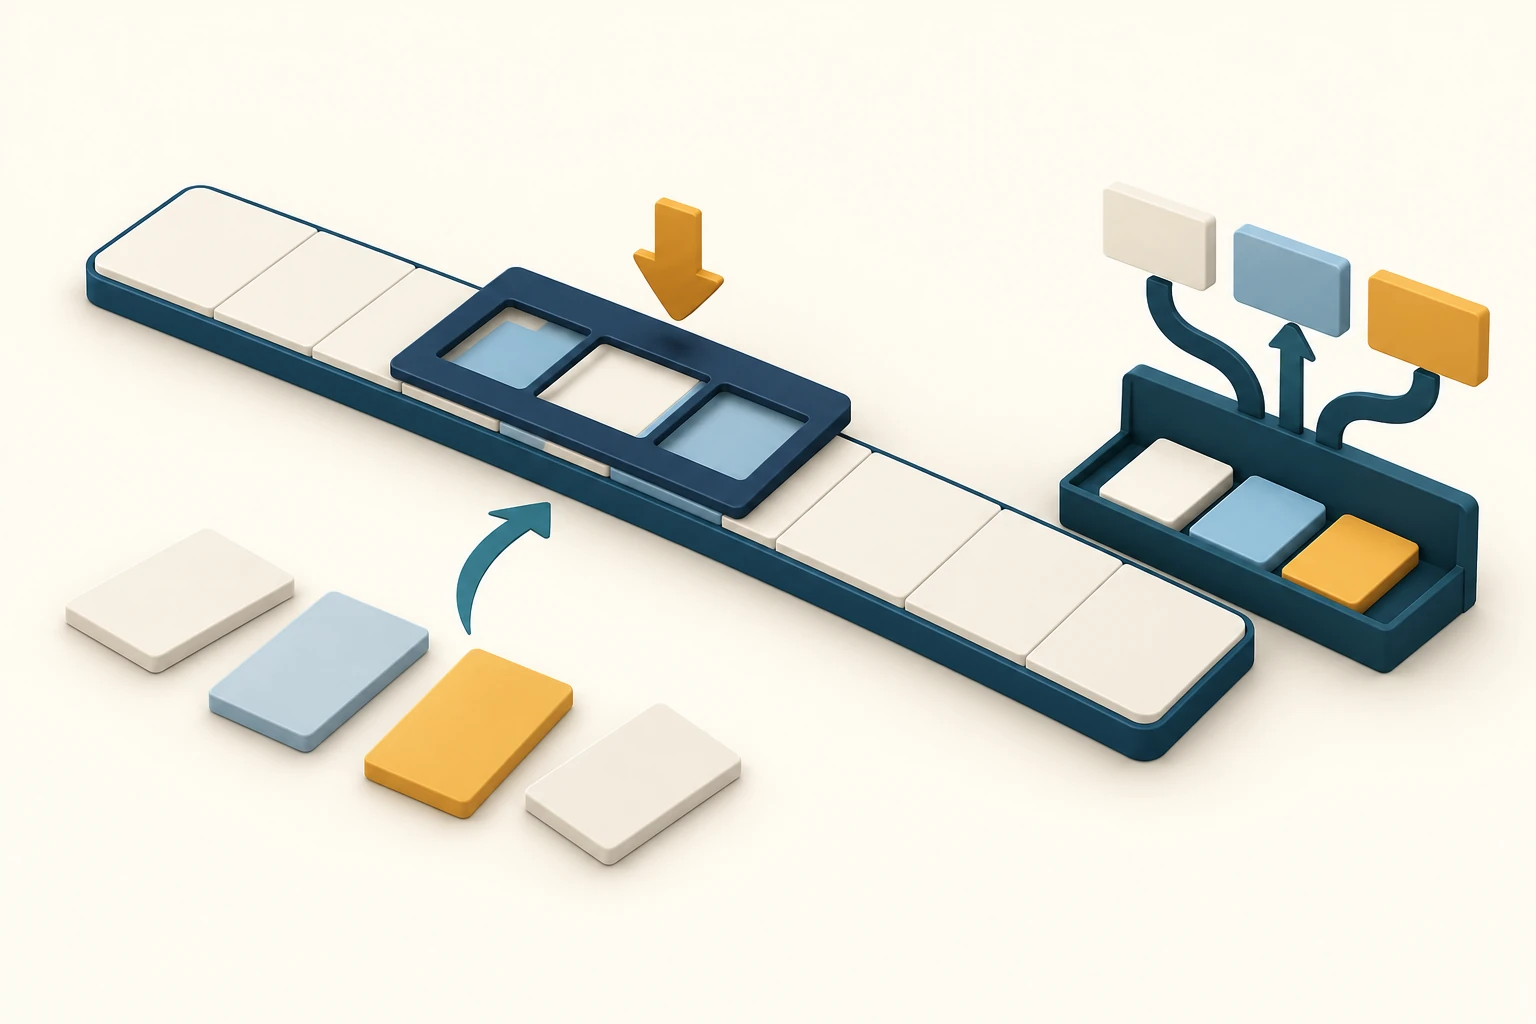
ورودیِ هر مرحله یک رشتهٔ پایتون است و الگو نیز یک رشتهٔ ناتهی. تابع باید همهٔ بازههایی را بدهد که متنِ آنها دقیقاً برابر الگوست؛ آغاز بازه داخل و پایان آن خارج بازه است. این قراردادِ نیمهباز، طول رخداد را با تفاضل پایان و آغاز برابر میکند. نامگذاریِ جستوجوی دقیق، مرز واژه، معنای شناسه یا ارتباطِ محتوایی به آن اضافه نمیکند.
مثلاً الگوی R1 داخلِ متنِ XR17 از جایگاه یک تا پیش از سه پیدا میشود. این نتیجه درستِ زیررشته است، اما تطبیق کاملِ نام قطعه نیست. در جستوجوی عبارت با نمایهٔ مکانی واحد، شمارهٔ واژه و مجاورتِ واژهها بود؛ اینجا اصلاً واژهسازی یا نمایهٔ سند نداریم.
همچنین تکمیل پیشوند با Trie از واژهنامه، مدخلِ آغازشونده پیشنهاد میکرد. این برنامه یک متن را از چپ به راست میخواند و محلِ الگوی دادهشده را گزارش میکند. اشتراکِ کلمهٔ «پیشوند» در توضیح دو روش، آنها را یک کار نمیکند؛ جدول پیشوندِ این درس دربارهٔ بخشهای خودِ الگوست، نه شاخههای یک واژهنامه.
۲. جدول پیشوند و مسیرِ بازگشت را بسازیم
درس دانشگاه کرنل دربارهٔ جستوجوی رشته، استفاده از پیشوندِ تطبیقیافته هنگام ناسازگاری را شرح میدهد. در جدولِ ما، خانهٔ i طولِ بلندترین پیشوندِ سرهٔ الگوست که پسوندِ بخشِ پایانیافته در i نیز هست. سره یعنی کلِ همان بخش را به عنوان پیشوندِ خودش انتخاب نکنیم؛ مسیرِ بازگشت باید واقعاً کوتاهتر شود.
برای الگوی 101، جدول (0,0,1) است. پس از دیدنِ سه نمادِ کامل، آخرین یک میتواند آغازِ رخدادِ بعدی هم باشد. بهجای صفر کردنِ حافظه، طولِ تطبیق را یک میگذاریم. با یک ناسازگاری نیز همین ایده را روی بخشِ تطبیقیافته به کار میبریم؛ تا جایی عقب میرویم که ادامهٔ ممکن باقی بماند یا طول به صفر برسد.
متغیرِ تطبیق، تعداد نمادهای آغازِ الگوست که با پسوندِ متنِ خواندهشده برابر ماندهاند. این عدد، تعداد کلِ رخدادها یا تعداد نمادهای قطعه نیست. بعد از هر رخداد نیز به یک پیشوندِ سره برمیگردیم تا حالتِ ذخیرهشده از طول الگو کوچکتر بماند. جدولِ درس کرنل با طولِ پیشوند شمارهگذاری شده است؛ جدولِ کد ما با جایگاهِ آخرین نماد، پس اندیسِ بازگشت یک واحد تفاوتِ قراردادی دارد.
۳. حالت و جایگاه را از مرز قطعه عبور دهیم
متنِ دستی 11010101 را در قطعههای ('11','010','','101') میدهیم. اینها نویسههای یک گزارش دودوییِ ساختگیاند؛ شمارهٔ نویسه را زمان، ولتاژ یا نمونهٔ کالیبرهشده نمینامیم. پس از قطعهٔ نخست، دو نویسه خوانده شده و فقط یک نماد از آغاز الگو با انتهای متن سازگار است. پس از قطعهٔ دوم، پنج نویسه خوانده شده و طولِ تطبیقِ باقیمانده دو است.
همان نمونهٔ جستوجو باید قطعهٔ بعدی را بگیرد؛ ساختنِ نمونهٔ تازه برای هر قطعه، این دو عدد را پاک میکند. قطعهٔ خالی هیچ نمادِ تازهای ندارد، پس نه جایگاه جلو میرود و نه رخدادِ قبلی دوباره صادر میشود. رشتهٔ خالی علامتِ پایانِ سند نیست. این رابط، زمانمهر یا پیامِ شبکه را نمیشناسد؛ فقط تکههای مرتبِ یک متنِ منطقی را دریافت میکند.
در هر رخداد، پایان برابر شمارِ نویسههای خواندهشده و آغاز برابر پایان منهای طول الگوست. پاسخِ دستی، بازههای [1,4),[3,6),[5,8) است. اگر هر قطعه را جدا جستوجو کنیم و فقط offset را جابهجا کنیم، تنها بازهٔ آخر باقی میماند. جبرانِ جایگاه، تطبیقِ ازدسترفته در مرز را بازیابی نمیکند؛ حافظهٔ تطبیق باید واقعاً منتقل شود.
۴. رخدادِ همپوشان را با مرجع مستقل بسنجیم
فایل kmp_streaming_substring.py با Python 3.14.5 و فقط کتابخانهٔ استاندارد اجرا شده است. الگو و قطعه باید str واقعی باشند؛ عدد، bytes، None و زیرکلاسِ str تبدیلِ ضمنی نمیشوند. حدِ طول یا الفبای دلخواهی اضافه نکردهایم. قطعهٔ نامعتبر پیش از تغییر حالت رد میشود؛ خطای نوع، جایگاهِ یک تطبیقِ نیمهتمام را خراب نمیکند.
"""Original chunked raw-string KMP; all spans are half-open codepoint offsets."""
from dataclasses import asdict, dataclass
from itertools import product
import json
import platform


def prefix_table(pattern):
    if type(pattern) is not str:
        raise TypeError('actual str pattern required')
    if not pattern:
        raise ValueError('empty pattern is outside this interface')
    table = [0] * len(pattern)
    length = 0
    for i in range(1, len(pattern)):
        while length and pattern[length] != pattern[i]:
            length = table[length - 1]
        if pattern[length] == pattern[i]:
            length += 1
        table[i] = length
    return tuple(table)


@dataclass(frozen=True)
class ChunkResult:
    matches: tuple
    matched_prefix: int
    processed: int


class KMPStream:
    """Feed chunks in order for one logical string; do not modify private state.

    Private attributes are a Python convention, not a security boundary.
    No text normalization, decoder, document boundary or thread safety is added.
    """
    def __init__(self, pattern):
        self._prefix = prefix_table(pattern)
        self._pattern = pattern
        self._matched = 0
        self._processed = 0

    @property
    def prefix(self):
        return self._prefix

    @property
    def state(self):
        return self._matched, self._processed

    def feed(self, chunk):
        if type(chunk) is not str:
            raise TypeError('actual str chunk required; decoding is separate')
        matched, processed = self._matched, self._processed
        spans = []
        for char in chunk:
            while matched and self._pattern[matched] != char:
                matched = self._prefix[matched - 1]
            if self._pattern[matched] == char:
                matched += 1
            processed += 1
            if matched == len(self._pattern):
                spans.append((processed - len(self._pattern), processed))
                # Keep the longest proper border so overlapping matches survive.
                matched = self._prefix[matched - 1]
        self._matched, self._processed = matched, processed
        return ChunkResult(tuple(spans), matched, processed)


def run_chunks(pattern, chunks):
    matcher = KMPStream(pattern)
    results = tuple(matcher.feed(chunk) for chunk in chunks)
    return tuple(span for result in results for span in result.matches), results


def find_reference(text, pattern):
    """Whole-string native search; independent of prefix tables/state loops."""
    found, start = [], 0
    while True:
        index = text.find(pattern, start)
        if index == -1:
            return tuple(found)
        found.append((index, index + len(pattern)))
        start = index + 1  # Advance one codepoint, allowing overlaps.


def slice_reference(text, pattern):
    return tuple((i, i + len(pattern))
                 for i in range(len(text) - len(pattern) + 1)
                 if text[i:i + len(pattern)] == pattern)


def brute_prefix_reference(pattern):
    """Try all proper prefix lengths separately for every pattern prefix."""
    result = []
    for end in range(1, len(pattern) + 1):
        options = [k for k in range(end)
                   if pattern[:k] == pattern[end-k:end]]
        result.append(max(options))
    return tuple(result)


def rejected(call, expected):
    try:
        call()
    except expected:
        return True
    return False


def main():
    pattern = '101'
    chunks = ('11', '010', '', '101')
    spans, trace = run_chunks(pattern, chunks)
    checks = {}
    checks['literal_prefix_and_three_overlapping_half_open_spans'] = (
        prefix_table(pattern) == (0, 0, 1)
        and spans == ((1, 4), (3, 6), (5, 8)))
    checks['literal_carried_prefix_and_absolute_count_for_each_chunk'] = (
        tuple((r.matched_prefix, r.processed) for r in trace)
        == ((1, 2), (2, 5), (2, 5), (1, 8))
        and tuple(r.matches for r in trace)
        == ((), ((1, 4),), (), ((3, 6), (5, 8))))
    reset_spans, offset = [], 0
    for chunk in chunks:
        result = KMPStream(pattern).feed(chunk)
        reset_spans.extend((a + offset, b + offset) for a, b in result.matches)
        offset += len(chunk)
    checks['resetting_at_chunk_boundaries_loses_two_crossing_matches'] = (
        tuple(reset_spans) == ((5, 8),) and tuple(reset_spans) != spans)
    patterns = tuple(''.join(p) for size in range(1, 4)
                     for p in product('01', repeat=size))
    texts = tuple(''.join(p) for size in range(6)
                  for p in product('01', repeat=size))
    pairs = segmented_cases = 0
    agree = True
    for pat in patterns:
        for text in texts:
            expected = find_reference(text, pat)
            agree &= expected == slice_reference(text, pat)
            pairs += 1
            for cut in range(len(text) + 1):
                actual, _ = run_chunks(pat, (text[:cut], '', text[cut:]))
                agree &= actual == expected
                segmented_cases += 1
    checks['independent_find_and_slice_4494_segmentations_one_group'] = (
        bool(agree) and pairs == 882 and segmented_cases == 4494)
    prefix_cases = 0
    table_agrees = True
    for size in range(1, 6):
        for letters in product('01', repeat=size):
            pat = ''.join(letters)
            table_agrees &= prefix_table(pat) == brute_prefix_reference(pat)
            prefix_cases += 1
    checks['independent_brute_border_tables_62_patterns_one_group'] = (
        bool(table_agrees) and prefix_cases == 62)
    fallback = KMPStream('1101100')
    first = fallback.feed('110110')
    mismatch = fallback.feed('X')
    final = fallback.feed('1101100')
    checks['multiple_fallbacks_discard_only_impossible_prefixes'] = (
        fallback.prefix == (0, 1, 0, 1, 2, 3, 0)
        and first.matched_prefix == 6 and mismatch.matched_prefix == 0
        and final.matches == ((7, 14),))
    single = KMPStream('N')
    checks['single_codepoint_pattern_reports_each_occurrence_then_empty_emits_none'] = (
        single.feed('NNN').matches == ((0, 1), (1, 2), (2, 3))
        and single.feed('').matches == () and single.state == (0, 3))
    future = KMPStream('10101')
    pending = future.feed('101')
    later = future.feed('01')
    checks['unfinished_longer_pattern_is_carried_until_future_completion'] = (
        pending.matches == () and pending.matched_prefix == 3
        and later.matches == ((0, 5),) and later.matched_prefix == 3)
    unicode_spans, _ = run_chunks('R17', ('⚡R', '17🙂', 'R17'))
    checks['absolute_positions_are_codepoints_not_utf8_bytes'] = (
        unicode_spans == ((1, 4), (5, 8))
        and len('⚡'.encode('utf-8')) == 3 and len('⚡') == 1)
    checks['substring_inside_component_label_has_no_word_boundary_rule'] = (
        KMPStream('R1').feed('XR17').matches == ((1, 3),))
    checks['raw_canonical_forms_are_not_silently_normalized'] = (
        KMPStream('é').feed('e\u0301|é').matches == ((3, 4),))
    class StrChild(str):
        pass
    checks['empty_pattern_and_nonactual_string_constructor_contract'] = (
        rejected(lambda: KMPStream(''), ValueError)
        and all(rejected(lambda x=x: KMPStream(x), TypeError)
                for x in (None, b'101', 101, ['1'], StrChild('101'))))
    guarded = KMPStream('101')
    guarded.feed('10')
    errors = all(rejected(lambda x=x: guarded.feed(x), TypeError)
                 for x in (None, b'1', 1, ['1'], StrChild('1')))
    checks['invalid_chunk_does_not_poison_partial_match_or_position'] = (
        errors and guarded.state == (2, 2)
        and guarded.feed('1').matches == ((0, 3),))
    assert all(type(value) is bool and value is True for value in checks.values()), checks
    output = {
        'python': platform.python_version(), 'dependencies': 'stdlib only',
        'pattern': pattern, 'prefix_table': prefix_table(pattern), 'chunks': chunks,
        'concatenated_hand_text': ''.join(chunks), 'matches': spans,
        'trace': [asdict(r) for r in trace], 'wrong_reset_matches': reset_spans,
        'position_unit': 'absolute Python str Unicode codepoint index; half-open [start,end)',
        'oracle_pattern_text_pairs_inside_one_group': pairs,
        'oracle_segmentations_inside_one_group': segmented_cases,
        'brute_prefix_patterns_inside_one_group': prefix_cases,
        'unicode_fixture_matches': unicode_spans,
        'checks': checks, 'unique_check_groups': len(checks), 'all_passed': True,
        'limits': ['One logical raw string, one nonempty exact pattern',
                   'No byte decoding, normalization, grapheme or word-boundary analysis',
                   'Empty chunk has no new characters and emits no repeated match',
                   'Input lengths not arbitrarily capped; no resource or real-time guarantee',
                   'No corpus relevance, production speed, hardware or detection efficacy measured']}
    print(json.dumps(output, ensure_ascii=False, indent=2))


if __name__ == '__main__':
    main()
مرجعِ نخست، متنِ کاملِ همان آزمون را به str.find مستندشدهٔ پایتون میدهد؛ این مرجع جدول یا حالت KMP را صدا نمیزند. پس از هر نتیجه، از یک جایگاه بعد از آغاز ادامه میدهد تا همپوشانی مجاز بماند. مرجعِ دوم، همهٔ برشهای هماندازهٔ الگو را مستقیم با آن مقایسه میکند. ساختن متنِ کامل فقط در مرجعِ آزمون است؛ مسیر اصلی قطعههای گذشته را دوباره به هم نمیچسباند.
چهارده الگوی دودویی با طول یک تا سه و شصتوسه متن با طول صفر تا پنج داریم. برای هر یک از ۸۸۲ زوج، تمام مرزهای دو قطعه و یک قطعهٔ خالیِ میانی آزموده میشوند؛ حاصل ۴۴۹۴ مقایسه در یک گروه است. در گروهی جدا، جدولِ ۶۲ الگو با جستوجوی مستقیمِ همهٔ پیشوندها و پسوندهای سره مقایسه میشود. این حلقهها به تعدادِ گروهها اضافه نشدهاند.
{
  "python": "3.14.5",
  "dependencies": "stdlib only",
  "pattern": "101",
  "prefix_table": [
    0,
    0,
    1
  ],
  "chunks": [
    "11",
    "010",
    "",
    "101"
  ],
  "concatenated_hand_text": "11010101",
  "matches": [
    [
      1,
      4
    ],
    [
      3,
      6
    ],
    [
      5,
      8
    ]
  ],
  "trace": [
    {
      "matches": [],
      "matched_prefix": 1,
      "processed": 2
    },
    {
      "matches": [
        [
          1,
          4
        ]
      ],
      "matched_prefix": 2,
      "processed": 5
    },
    {
      "matches": [],
      "matched_prefix": 2,
      "processed": 5
    },
    {
      "matches": [
        [
          3,
          6
        ],
        [
          5,
          8
        ]
      ],
      "matched_prefix": 1,
      "processed": 8
    }
  ],
  "wrong_reset_matches": [
    [
      5,
      8
    ]
  ],
  "position_unit": "absolute Python str Unicode codepoint index; half-open [start,end)",
  "oracle_pattern_text_pairs_inside_one_group": 882,
  "oracle_segmentations_inside_one_group": 4494,
  "brute_prefix_patterns_inside_one_group": 62,
  "unicode_fixture_matches": [
    [
      1,
      4
    ],
    [
      5,
      8
    ]
  ],
  "checks": {
    "literal_prefix_and_three_overlapping_half_open_spans": true,
    "literal_carried_prefix_and_absolute_count_for_each_chunk": true,
    "resetting_at_chunk_boundaries_loses_two_crossing_matches": true,
    "independent_find_and_slice_4494_segmentations_one_group": true,
    "independent_brute_border_tables_62_patterns_one_group": true,
    "multiple_fallbacks_discard_only_impossible_prefixes": true,
    "single_codepoint_pattern_reports_each_occurrence_then_empty_emits_none": true,
    "unfinished_longer_pattern_is_carried_until_future_completion": true,
    "absolute_positions_are_codepoints_not_utf8_bytes": true,
    "substring_inside_component_label_has_no_word_boundary_rule": true,
    "raw_canonical_forms_are_not_silently_normalized": true,
    "empty_pattern_and_nonactual_string_constructor_contract": true,
    "invalid_chunk_does_not_poison_partial_match_or_position": true
  },
  "unique_check_groups": 13,
  "all_passed": true,
  "limits": [
    "One logical raw string, one nonempty exact pattern",
    "No byte decoding, normalization, grapheme or word-boundary analysis",
    "Empty chunk has no new characters and emits no repeated match",
    "Input lengths not arbitrarily capped; no resource or real-time guarantee",
    "No corpus relevance, production speed, hardware or detection efficacy measured"
  ]
}
سیزده گروهِ نامدار واقعاً موفق شدند؛ شاهدِ دستی، چند بازگشتِ پیاپی، الگوی تکنویسهای، تکمیل در آینده، جایگاه یونیکد و خطای نوع نیز حضور دارند. آزمونها محدودند و اثباتِ همهٔ رشتهها یا تضمینِ موعدِ پردازش نیستند. شیء داخلی با قراردادِ نامگذاری خصوصی محافظت میشود؛ دستکاریِ دستیِ ویژگیهای آن پشتیبانی نمیشود و مرز امنیتی یا تضمینِ همزمانی نداریم.
۵. واحد جایگاه و حد تفسیر را نگه داریم
طبق تعریفِ str در همان مستندات، واحدِ رشته نقطهٔ کد یونیکد است. در متنِ ⚡R17🙂R17، رخدادهای R17 از یک و پنج آغاز میشوند؛ علامتِ نخست یک نقطهٔ کد ولی سه بایت UTF-8 دارد. بنابراین این offsetها بایتی نیستند. برنامه نرمالسازی، دستهبندیِ خوشههای نوشتاری یا تحلیلِ مرز واژه انجام نمیدهد؛ شکلِ ترکیبی و نویسهٔ ازپیشترکیبشده نیز بیاعلان یکی نمیشوند.
پرسش اول: چرا بعد از هر رخداد، طولِ تطبیق را صفر نکنیم؟ پاسخ: در نمونه، آخرین یکِ رخدادِ نخست آغاز رخدادِ میانی هم هست. صفر کردن آن، بازهٔ [3,6) را از دست میدهد؛ بازگشت به پیشوندِ یکنمادی، این امکان را نگه میدارد.
پرسش دوم: قطعهٔ خالی چه چیزی را برمیگرداند؟ پاسخ: هیچ رخداد تازهای؛ در شاهدِ میانی، حالتِ دو نمادِ تطبیقیافته و پنج نویسهٔ پردازششده حفظ میشود. رخدادِ قبلی دوباره گزارش نمیشود و کارِ تطبیقِ آینده هم متوقف نمیماند.
پرسش سوم: پیداشدنِ R1 داخل XR17 یعنی قطعهٔ R1 پیدا شده؟ پاسخ: فقط زیررشته پیدا شده است. برای نامِ کاملِ قطعه باید قاعدهٔ جداگانهای برای مرز و قالب شناسه تعریف شود؛ KMP از متنِ خام چنین معنایی استنتاج نمیکند.
پرسش چهارم: میتوان بستهٔ bytes شبکه را مستقیم feed کرد؟ پاسخ: خیر؛ این رابط bytes را رد میکند. رمزگشاییِ درستِ قطعههای بایتی باید پیش از آن و با نگهداریِ وضعیتِ رمزگشا انجام شود؛ مرز بسته ممکن است میان بایتهای یک نویسه بیفتد. اجرای حاضر شبکه یا رمزگشای مرحلهای را آزمایش نکرده است.
برای سندِ مستقلِ بعدی، نمونهٔ جستوجوی تازه بسازید تا پایانِ یک سند با آغازِ دیگری ترکیب نشود. تعداد رخدادها، ارتباط، اعتبار منبع یا کیفیتِ نتیجه را نمیسنجد. منابع در ۲۶ مهر ۱۴۰۵ خوانده شدند؛ آرشیو کرنل مربوط به درس سال ۲۰۰۲ است و تاریخ دقیقِ انتشار صفحه نامعلوم مانده است. مستندات Python 3.14.8 و اجرای واقعی 3.14.5 جدا ثبت شدهاند؛ آموزش، خبر تازه یا گزارشِ سرعتِ محصول نیست.
منابع و مطالعهٔ بیشتر
بررسی منابع: ۲۶ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.